Comment Aborder la Déduplication CRM
Un guide pratique pour planifier votre projet de dédoublonnage, classer les doublons par risque et combiner les types de fusion pour le nettoyage et l'automatisation continue.


Ce qui compte comme doublon dépend de la structure de votre CRM, des processus de votre équipe et des besoins de votre activité. C'est pourquoi nous recommandons de mener le dédoublonnage comme un projet en trois phases, et de classer vos doublons selon votre degré de certitude avant de fusionner quoi que ce soit.
Les trois phases
Phase 1 : Nettoyer les données héritées
Fusionnez votre arriéré historique pour repartir d'un CRM propre.
Phase 2 : nettoyer les données actuelles
Trouvez, examinez et fusionnez les doublons que votre équipe crée chaque jour par l'activité commerciale, les formulaires et les intégrations.
Phase 3 : garder propres les données futures
Mettez en place l'automatisation en arrière-plan (Auto Merge, Auto Match et pré-nettoyage des tableurs) pour traiter les nouveaux doublons à leur arrivée.
Classer vos doublons
Avant de créer des Duplicate Searches ou de configurer des Merge Rules, classez vos types de doublons selon votre degré de certitude et le risque d'une mauvaise fusion. Dedupely n'impose pas de définition figée du doublon. Votre équipe décide quelles correspondances sont sûres à fusionner et lesquelles demandent un examen plus attentif.
Doublons évidents
Des correspondances dont votre équipe est très sûre, avec peu de risque de faux positifs, comme des correspondances exactes de nom et d'e-mail. Ce qui compte comme « évident » dépend de vos données. Une fois vérifiées, elles se prêtent à la fusion en masse et à l'automatisation.
Doublons conditionnels
Des fiches probablement en double, mais qui demandent des règles par champ pour protéger les données valides. Par exemple, il faut s'assurer que les données de remplissage des numéroteurs ou des intégrations n'écrasent pas de vraies coordonnées.
Doublons complexes
Les correspondances à fort enjeu ou floues, où une mauvaise fusion pourrait toucher la facturation, la propriété des comptes ou les synchronisations ERP. Une personne doit les vérifier dans une file de revue avant la fusion.
Duplicate Searches courantes pour chaque catégorie
Voici les configurations de Duplicate Search les plus courantes dans les comptes Dedupely, comme point de départ :
Doublons évidents
- Correspondance exacte de contact (doubles soumissions de formulaire, imports de listes d'événements) : First Name : Exact · Last Name : Exact · Email : Exact
- Correspondance exacte d'entreprise (imports de listes de leads en double) : Company Name : Exact · Company Domain Name : Domain Root
Doublons conditionnels
- Journaux d'appels des intégrations (applis d'appel) : Phone Number : Similar (compare les 7 derniers chiffres) · Filtre : First Name ou Email vide
- Variantes de domaine, ou « entreprises fantômes » : Company Domain Name : Domain Root · Company Name : Similar Words (Any Order), avec des Ignored Terms pour les suffixes juridiques comme Inc., LLC ou Ltd.
Doublons complexes
- Identifiants financiers et ERP : champs personnalisés Numéro fiscal, Customer Account Number ou ERP ID pour les correspondances sur des enregistrements liés à la facturation ou à la comptabilité.
- Chevauchement de comptes régionaux : Similar Company Name + même City/State, avec des Account Owners différents ou des transactions actives qui demandent une revue entre équipes.
En savoir plus dans Duplicate Searches, Options de correspondance et Filtres.
Types de fusion Dedupely
- Custom Merge : compare les fiches côte à côte pour choisir les valeurs champ par champ. Idéal pour : tester vos Merge Rules et vérifier les cas limites.
- Bulk Merge : fusionne beaucoup ou la totalité de vos correspondances à la fois. Idéal pour : l'historique et les gros imports.
- Auto Merge : tourne en arrière-plan selon le planning que vous fixez, sans travail manuel. Idéal pour : les doublons qui reviennent sans cesse.
- Auto Match : cherche de nouveaux doublons selon votre planning et vous écrit quand les correspondances non relues atteignent le nombre fixé. Idéal pour : les correspondances complexes ou sensibles qui demandent une validation.
En savoir plus dans Fusionner les doublons et Auto Match.
Scénario d'exemple
Voici comment fonctionnent les trois catégories dans une équipe où le Marketing gère les doublons du CRM tandis que Ventes et Ops continuent d'importer des données. Adaptez ces étapes à vos propres sources et règles métier.
Doublons évidents : imports d'événements et envois de formulaires
Les ventes organisent des événements mensuels et le marketing des webinaires mensuels, et les tableurs et soumissions de formulaires arrivent donc en continu.
- Nettoyer les listes avant import. Passez d'abord les tableurs d'événements par l'import illimité de tableurs de Dedupely, pour que les doublons n'atteignent jamais votre CRM. Voir Fusionnez les doublons dans vos tableurs.
- Résorbez l'arriéré. Créez une Duplicate Search sur des identifiants exacts (par ex. Exact First Name + Exact Last Name + Exact Email).
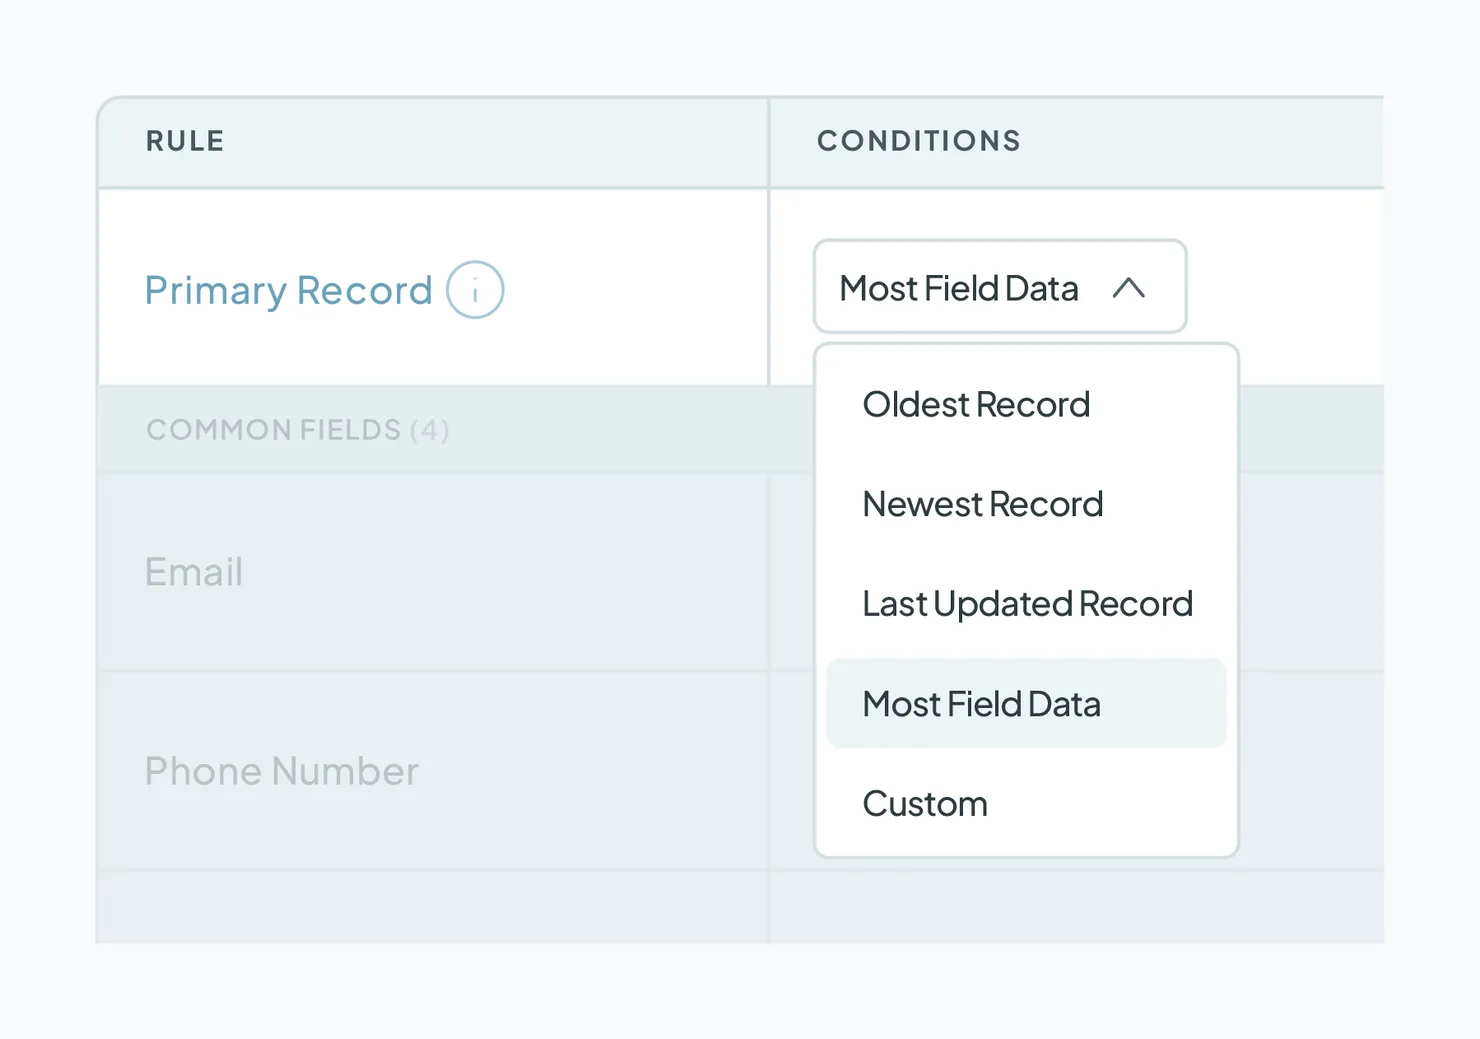
- Définir votre règle de Primary Record (par ex. la fiche avec les données les plus complètes).
- Prévisualisez. Ouvrez View Match Details et vérifiez le résultat dans la Merge Preview colonne.
- Testez. Faites 1–2 fusions individuelles et vérifiez les résultats dans votre CRM, puis sélectionnez et fusionnez en masse 2 pages.
- Fusion en masse les résultats restants.
- Automatisez. Activez Auto Merge pour cette recherche et fixez une planification (par ex. toutes les deux semaines ou chaque mois) adaptée à votre rythme d'import.
Doublons conditionnels : numéroteurs commerciaux et outils d'enrichissement
Cas A : journaux d'appels de l'outil d'appel
Les intégrations de numéroteurs envoient des journaux d'appels avec seulement un numéro, en laissant le nom ou l'e-mail vide.
- Rapprochement sur numéro de téléphone utilisant Similar match (compare les 7 derniers chiffres).
- Ajoutez un filtre pour qu'au moins une fiche de la correspondance ait un champ vide : Prénom ou E-mail.
- Définissez vos Merge Rules : Primary Record sur Le plus de données, pour que la vraie fiche contact l'emporte. Sur Phone Number, choisissez Personnalisé et ajoutez une Win Rule avec When field Create Date et l'opérateur is newest, pour que le contact garde le numéro le plus récent.
- Activez Auto Merge avec une planification quotidienne, pour que les journaux d'appels soient fusionnés avant la prospection matinale des commerciaux.
Cas B : enrichissement d'entreprises (« entreprises fantômes »)
Les CRM créent souvent des entreprises en double quand les domaines varient (par ex. acme.com et acme.co.uk).
- Rapprochez les entreprises avec Domain Root (ignore www et des terminaisons comme .com ou .co.uk).
- Rapprochez le nom de l'entreprise avec Similar Words (Any Order), et réglez Ignored Terms pour ignorer les suffixes juridiques (Inc., LLC, Ltd.).
- Réglez la règle de Primary Record pour garder la fiche la plus ancienne.
- Prévisualisez le résultat pour vérifier que votre correspondance et vos Merge Rules donnent le résultat voulu.
- Fusionnez en masse vos données historiques.
- Activez Auto Merge selon une planification quotidienne.
Doublons complexes : données ops et ERP
Les opérations synchronisent données financières, identifiants de facturation et détails de contrat depuis Salesforce ou un ERP, où fusionner le mauvais compte est très risqué.
- Créez une Duplicate Search sur des champs d'identifiant unique (par ex. numéro de TVA ou numéro client ERP).
- Activez Auto Match plutôt qu'Auto Merge et fixez un seuil d'alerte (par ex. prévenir quand 10 correspondances s'accumulent).
- Une fois averti, ouvrez les résultats et traitez chaque correspondance :
- Examen manuel : place la correspondance dans une file pour approbation par un chef d'équipe ou le propriétaire du compte. Voir Manual Review.
- Fusion : fusionne immédiatement, une fois vérifiées les valeurs conservées.
- Rejeter : écarte la correspondance si ce n'est pas un doublon. Elle reste hors de toutes les recherches futures pour cet objet. Voir Correspondances rejetées.
Et ensuite
Passez du plan à l'action, phase par phase :
- Cartographier vos types de doublons et classez chacun en évident, conditionnel ou complexe.
- Commencez par vos doublons évidents (Phase 1). Créez une Duplicate Search, testez avec 1–2 fusions individuelles, puis fusionnez en masse. Voir Repérer les doublons.
- Ajoutez des Merge Rules avant de fusionner les doublons conditionnels (Phase 2). Voir Merge Rules.
- Automatisez (phase 3). Utilisez Auto Merge pour les recherches testées et Auto Match pour tout ce qui est sensible.
Chaque fusion est enregistrée, vous pouvez donc toujours vérifier ce qui a été fusionné et quand dans Merge History.
Dépannage
Ma Duplicate Search trouve des fiches qui ne sont pas de vrais doublons. Vos réglages de correspondance sont peut-être trop souples pour cette catégorie. Passez des champs en correspondance Exact, ajoutez un autre champ de rapprochement ou ajoutez un filtre.
Ma Duplicate Search trouve moins de doublons que prévu. Vos réglages de correspondance sont peut-être trop stricts. Essayez Similar ou Fuzzy sur les champs de nom, ou Domain Root sur les domaines. Voir Options de correspondance.
La mauvaise fiche a été gardée comme principale. Vérifiez votre règle de Primary Record dans Merge Rules, et prévisualisez toujours quelques correspondances avant de fusionner en masse. Au besoin, créez des règles de fusion personnalisées au niveau du champ pour contrôler finement le résultat.
Auto Merge fusionne des fiches que je voulais examiner d'abord. Désactivez Auto Merge sur cette recherche et passez-la en Auto Match, pour être averti à la place. Vérifiez ce qui a été fusionné dans Merge History.
FAQ sur la planification d'un projet de dédoublonnage CRM
- Dois-je fusionner tous mes doublons d'un coup ? Non. Testez d'abord avec 1 ou 2 fusions individuelles et quelques pages en masse, vérifiez le résultat dans votre CRM, puis fusionnez le reste.
- Qui décide de ce qui compte comme doublon ? Votre équipe. Dedupely n'impose pas de définition figée : vous la fixez avec vos Duplicate Searches, leurs réglages de correspondance et les filtres.
- Quelle différence entre Auto Merge et Auto Match ? Auto Merge fusionne automatiquement selon une planification. Auto Match vous prévient seulement quand des doublons s'accumulent, et une personne décide quoi fusionner.
- Puis-je arrêter les doublons avant qu'ils n'atteignent mon CRM ? Oui. Nettoyez les tableurs dans Dedupely avant de les importer. Les imports de tableurs sont illimités et ne comptent pas dans la limite de votre offre.
- Par quelle phase commencer ? Phase 1, avec vos doublons évidents. C'est le risque le plus faible, et cela vous donne un point de départ propre pour tout le reste.
À suivre
Guide de déduplication HubSpot Appliquer ce plan dans HubSpot. Vous utilisez un autre CRM ? Voir les guides pour [Pipedrive](/knowledge-base/pipedrive-deduplication-guide), [Salesforce](/knowledge-base/salesforce-deduplication-guide), [Close](/knowledge-base/close-crm-deduplication-guide), [Nimble](/knowledge-base/nimble-crm-deduplication-guide) et [Google Contacts](/knowledge-base/google-contacts-deduplication-guide).Toujours bloqué ?
Notre équipe aide sur chaque offre et pendant l'essai gratuit, par chat, e-mail ou Zoom.
- Besoin d'aide ? Contacter le support
- Des questions sur les offres ? Réserver un Zoom avec un commercial
- Vous lisez ceci avec un modèle ? Lire cette page en Markdown
- Vous lui donnez tout le site ? Lire llms.txt




 Ou inscrivez-vous avec Google