Historia de cliente
Cómo una empresa SaaS fusionó más de 58.000 registros duplicados de Pipedrive creados por su migración desde HubSpot, con Dedupely
- Pipedrive
- Después de una migración de CRM
- Tras importar una lista
- SaaS

- 58,000+ registros duplicados fusionados
- 29,000+ coincidencias fusionadas
- 2.5x cuánto más grande se hizo la lista de Organizaciones después de la migración
Una coincidencia es un conjunto de registros duplicados fusionados en un único registro. Cada coincidencia contiene al menos dos registros, por lo que el número de registros fusionados es al menos el doble que el número de coincidencias.
De dónde vinieron los duplicados
Una lista de prospectos, importada más de una vez
La empresa es un negocio SaaS en Asia-Pacífico que crea una plataforma de aprendizaje para empleadores. Su fundador y CEO estaba configurando el embudo de ventas él mismo y migrando de HubSpot a Pipedrive. El plan era simple: traer una lista de prospectos de unos 26.000 empresas y comenzar a vender desde ella.
La migración requirió más de un intento:
- La primera importación no llegó como se esperaba. La lista se exportó como hoja de cálculo e importó a Pipedrive, y cuando los datos no se acomodaron como debían, se importó de nuevo.
- Una herramienta de migración movió todo de nuevo. Después, toda la cuenta se trasladó con una herramienta de migración, y fue entonces cuando aparecieron los duplicados.
- Cada duplicado tenía datos diferentes. El registro del CRM anterior tenía la dirección completa, página de LinkedIn, número de empleados y descripción. Otros solo tenían un país, escrito en formatos diferentes.
El resultado fueron aproximadamente 64.000 Organizaciones donde debería haber habido alrededor de 26.000, dos y medio veces el número real.
Lo que los duplicados rompieron
Una base de datos incomprensible
Con 64.000 Organizaciones en pantalla, no había forma de saber cuáles eran registros reales. Los datos de una única empresa estaban divididos entre dos, tres, cuatro y a veces cinco registros, cada uno con una pieza diferente. El control de duplicados propio de Pipedrive marcó alrededor de 9.000, que no contabilizaba todos.
Los mejores datos tenían que sobrevivir
La limpieza tenía que preservar los datos más completos del CRM anterior. Una fusión que guardara el registro incorrecto descartaría exactamente lo que importaba. Esta preocupación mantuvo el CRM intacto: tras ver más duplicados, lo último que quería era crear más problemas sin una visión clara de los datos.
Cómo se solucionaron los duplicados
-
1. Coincidir por nombre, luego afinar por dirección
Con el equipo de atención al cliente de Dedupely, el fundador comenzó con una búsqueda por nombre de organización. Por sí solo, el nombre devolvió unos 26.000 coincidencias, demasiadas para confiar, ya que dos empresas diferentes pueden compartir un nombre. Añadir la dirección con Coincidencia exacta redujo eso a 4.211 coincidencias. Cambiar la dirección a Similar Words en las tres primeras palabras, para que pequeñas diferencias en cómo se escribe una dirección no bloqueen una coincidencia, lo llevó a 4.868.
-
2. Conserve el registro con más datos
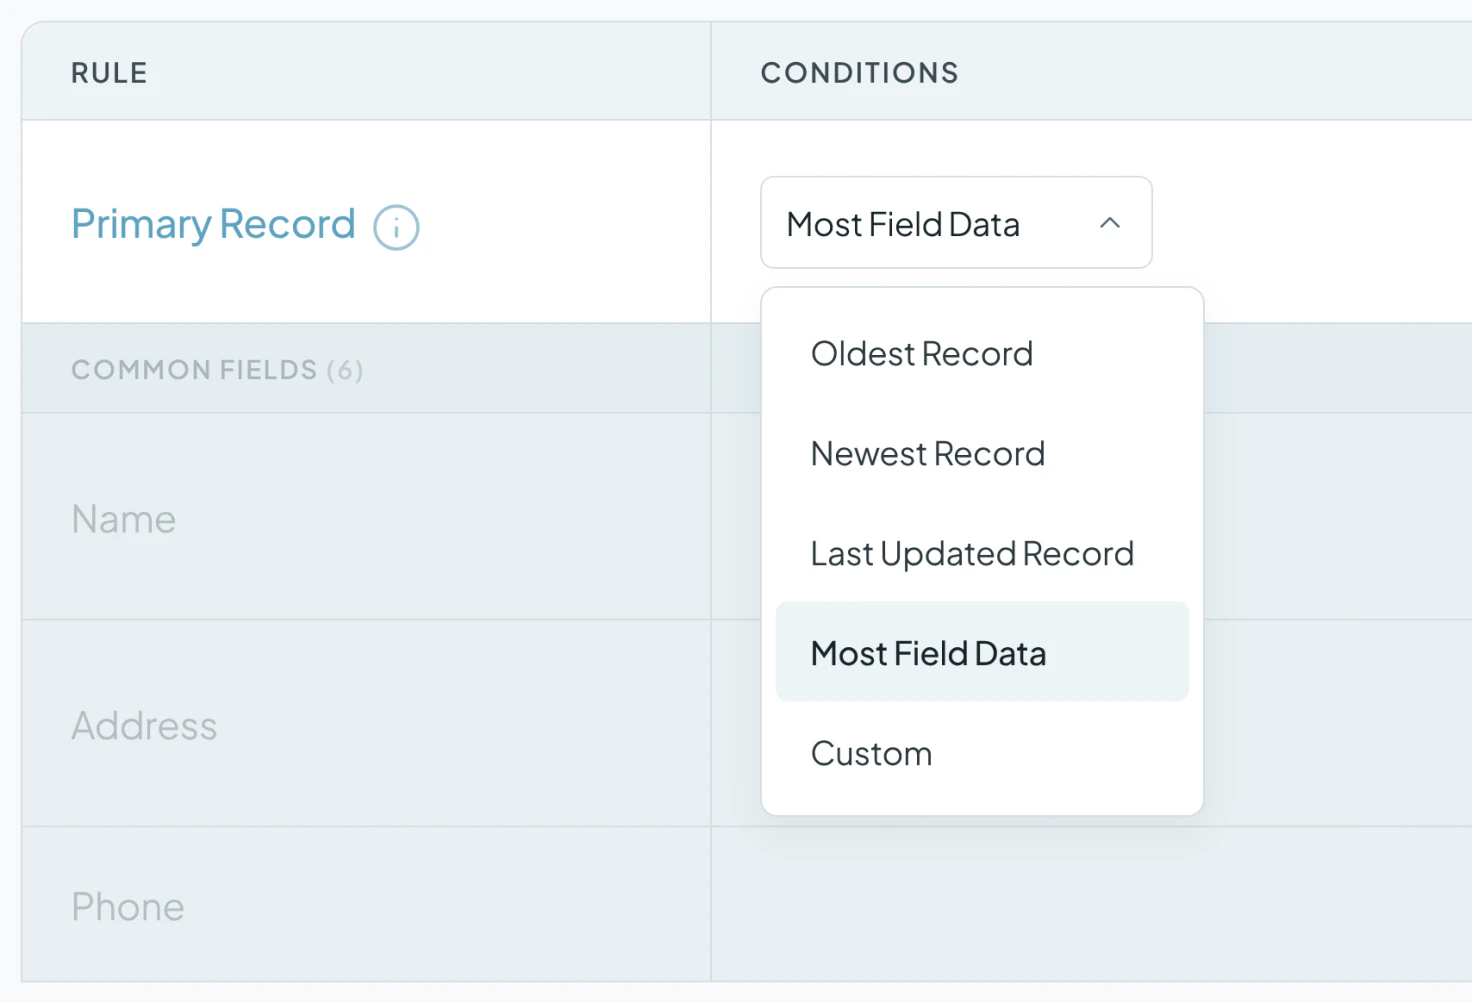
Merge Rules decidió qué sobrevive. La regla de Primary Record se estableció en Most Field Data, así que cada fusión incorpora duplicados en el registro con más información. La vista previa de fusión muestra valores ganadores en negrita antes de actuar, y los valores en blanco nunca sobrescriben datos existentes.
Una fusión de prueba de dos registros, verificada en Pipedrive, lo confirmó: la página de LinkedIn, el número de empleados y la descripción del CRM anterior aún estaban ahí. Después, las coincidencias se fusionaron en lote, en oleadas, en segundo plano.
-
3. Cuando los duplicados siguen ahí, cambia los campos de coincidencia
Después de los primeros miles de fusiones, la búsqueda estaba casi vacía, pero seguían siendo visibles muchos duplicados en Pipedrive. La dirección era la razón. Muchos duplicados tenían una dirección diferente o ninguna, y los valores en blanco no cuentan como coincidencia, así que la búsqueda los saltaba.
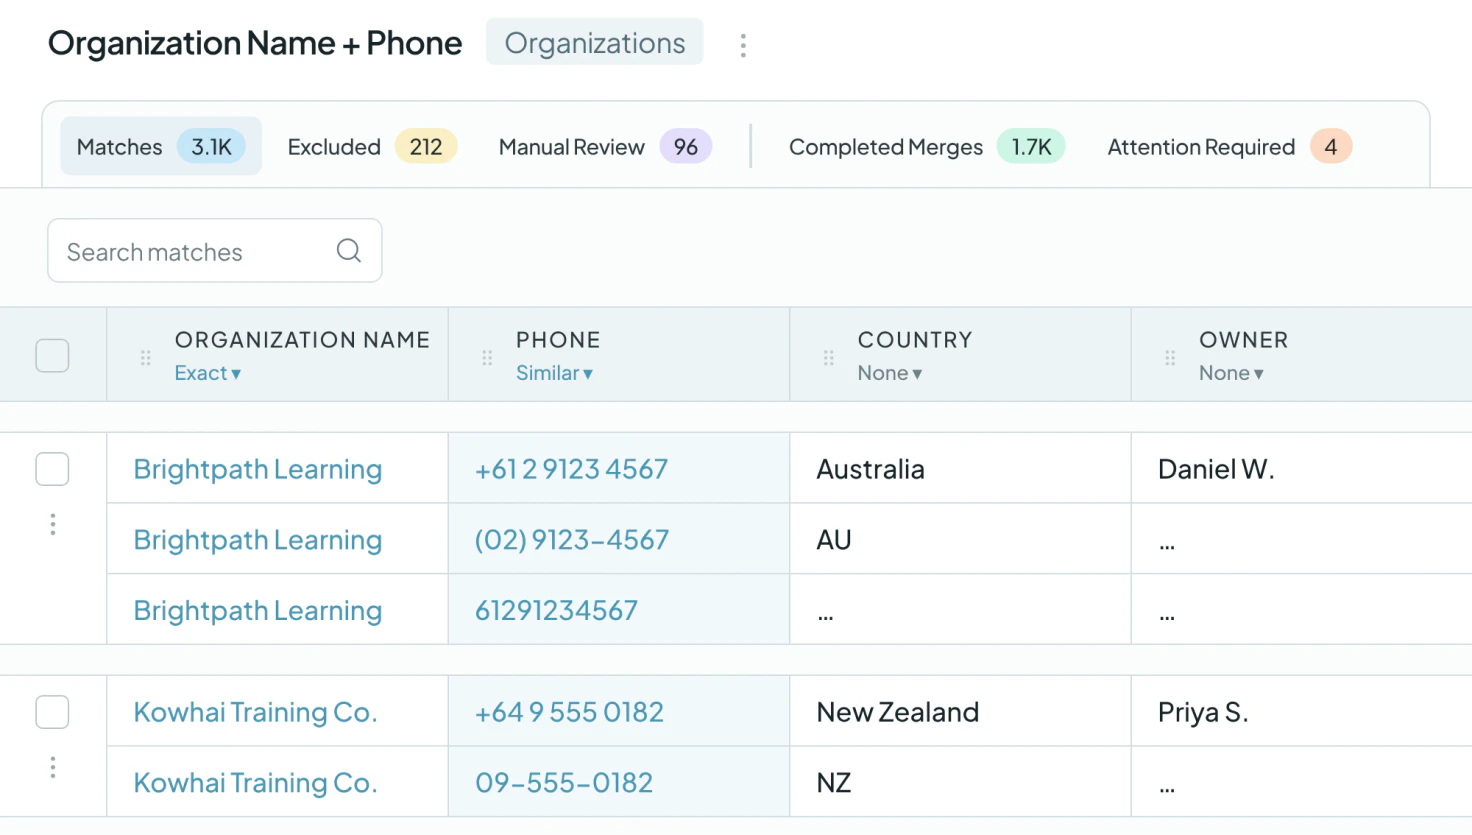
La solución fue dejar de coincidir por dirección y coincidir por nombre y teléfono en su lugar, con Teléfono configurado como Similar para que los códigos de país, espacios y guiones no se interponggan. Una fusión de prueba de una empresa con cuatro registros dejó exactamente uno en Pipedrive. De ahí, el plan fue una serie de fusiones en lote, cada una atrapando un grupo que la anterior perdió: nombre y teléfono, nombre y dirección de nuevo, luego las primeras dos palabras del nombre.
Cómo cambió la deduplicación
58.000+ registros duplicados fusionados
La empresa ha fusionado más de 29 000 coincidencias, combinando al menos 58 000 registros duplicados. Hoy la cuenta sincroniza 26 551 registros.
De ninguna idea a los datos que quería
Al principio, el fundador dijo que no sabía qué estaba mirando. Viendo que la primera fusión conservaba la página de LinkedIn, el número de empleados y la descripción del CRM anterior, dijo que era exactamente lo que había estado intentando hacer. Después de la segunda ronda, dijo que había estado haciéndolo mal, y que la sesión le había ayudado.
Relacionado

- Historia de cliente 9,092 coincidencias de personas fusionadasPipedrive Reclutamiento
Cómo una firma de búsqueda ejecutiva redujo su lista de personas en Pipedrive en casi un tercio tras una importación que duplicó a casi todos, con Dedupely
Lee la historia - Historia de cliente 20,000+ registros duplicados fusionadosPipedrive SaaS
Cómo dejaron de revisar Pipedrive manualmente y fusionaron 20.000+ duplicados con Dedupely
Lee la historia - Historia de cliente 200+ coincidencias de cuentas fusionadas al mes, en promedioSalesforce Retail
Cómo un minorista evitó que su equipo de ventas adivinara qué cuenta usar en Salesforce con Dedupely
Lee la historia













