Cas client
Comment une entreprise SaaS a fusionné 58 000+ fiches Pipedrive en doublon créées par sa migration depuis HubSpot, avec Dedupely
- Pipedrive
- Après une migration CRM
- Après une importation de liste
- SaaS

- 58,000+ enregistrements en doublons fusionnés
- 29,000+ correspondances fusionnées
- 2.5x combien la liste des Organisations s'est agrandie après la migration
Une correspondance est un ensemble d'enregistrements en double fusionnés en un seul enregistrement. Chaque correspondance contient au moins deux enregistrements, donc le nombre d'enregistrements fusionnés est au moins le double du nombre de correspondances.
D'où venaient les doublons
Une liste de prospects importée plusieurs fois
L'entreprise est une activité SaaS en Asie-Pacifique développant une plateforme d'apprentissage pour les employeurs. Son fondateur et PDG configurait lui-même le pipeline commercial et migrait de HubSpot vers Pipedrive. Le plan était simple : importer une liste de prospects d'environ 26 000 entreprises et commencer à vendre à partir de celle-ci.
La migration a demandé plusieurs tentatives :
- La première importation ne s'est pas déroulée comme prévu. La liste a été exportée en feuille de calcul et importée dans Pipedrive. Quand les données n'ont pas atterri correctement, elle a été réimportée.
- Un outil de migration a encore tout déplacé. Le compte a été migré avec un outil de migration, et c'est à ce moment que les doublons ont commencé à apparaître.
- Chaque doublon contenait des données différentes. L'enregistrement du CRM ancien contenait l'adresse complète, la page LinkedIn, le nombre d'employés et la description. D'autres n'avaient que le pays, écrit en différents formats.
Le résultat était environ 64 000 Organisations alors qu'il devrait y en avoir environ 26 000, deux fois et demie le nombre réel.
Problèmes causés par les doublons
Une base de données illisible
Avec 64 000 organisations à l'écran, il était impossible de savoir quelles fiches étaient réelles. Les données d'une seule entreprise étaient réparties sur deux, trois, quatre et parfois cinq fiches, chacune en contenant une partie différente. Le contrôle des doublons propre à Pipedrive en a signalé environ 9 000, ce qui n'en représentait pas la totalité.
Les meilleures données devaient être conservées
Le nettoyage devait préserver les données plus riches de l'ancien CRM. Une fusion qui aurait conservé le mauvais enregistrement aurait supprimé exactement ce que l'importation était censée apporter. Cette crainte a laissé le CRM inchangé : après avoir vu davantage de doublons s'ajouter aux premiers, le dernier souhait du fondateur était de créer d'autres problèmes avant d'avoir une vue claire des données.
Comment les doublons ont été résolus
-
1. Correspondance sur le nom, puis affinage par l'adresse
Avec l'équipe de réussite client de Dedupely, le fondateur a commencé par une recherche sur le nom de l'organisation. À lui seul, le nom a retourné environ 26 000 correspondances, trop large pour être fiable, puisque deux entreprises différentes peuvent partager un nom. L'ajout de l'adresse avec correspondance exacte a réduit cela à 4 211 correspondances. Le changement de l'adresse en Similar Words sur les trois premiers mots, pour que les petites différences dans la façon dont une adresse est écrite ne bloquent pas une correspondance, l'a porté à 4 868.
-
2. Conserver l'enregistrement contenant le plus de données
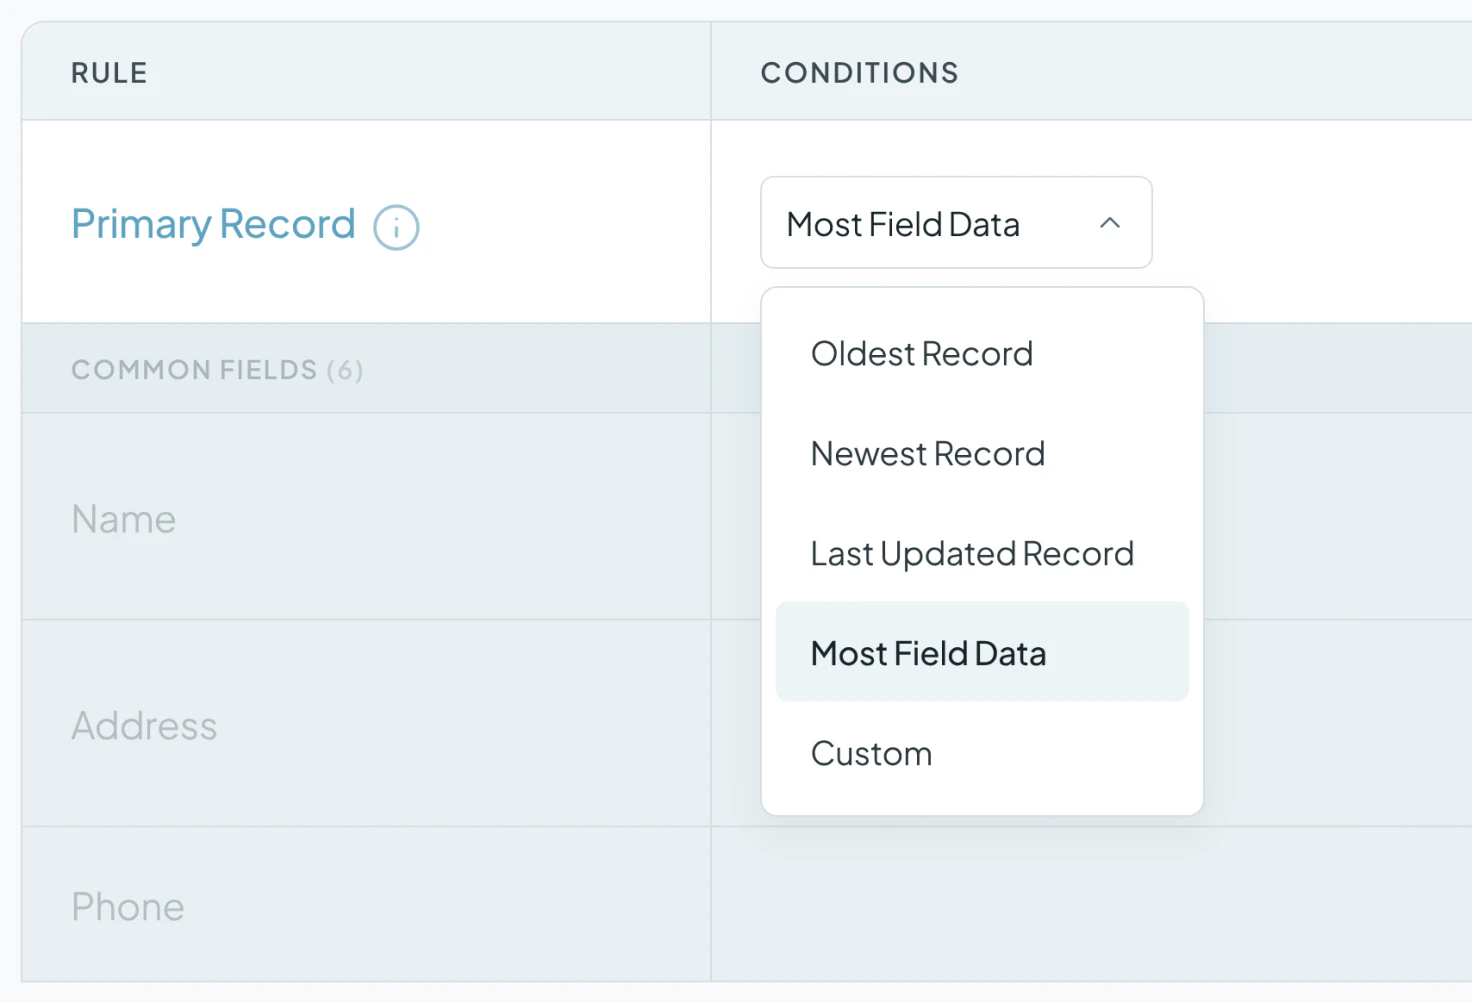
Merge Rules décidé ce qui survit. La règle Primary Record était définie sur Most Field Data, donc chaque fusion consolidait les doublons dans l'enregistrement ayant le plus d'informations. L'aperçu affiche les valeurs gagnantes en gras avant exécution, et les valeurs vides ne remplacent jamais les données existantes.
Une fusion de test de deux enregistrements, vérifiée directement dans Pipedrive, l'a confirmé : la page LinkedIn, le nombre d'employés et la description du CRM ancien étaient tous toujours présents. Après cela, les correspondances ont été fusionnées en masse, par vagues, s'exécutant en arrière-plan.
-
3. Si des doublons restent, modifiez les champs de recherche
Après les premiers milliers de fusions, la recherche était presque vide, mais de nombreux doublons restaient visibles dans Pipedrive. L'adresse était la raison. De nombreux doublons avaient une adresse différente ou aucune, et les valeurs vides ne comptent pas comme correspondance, donc la recherche les ignorait.
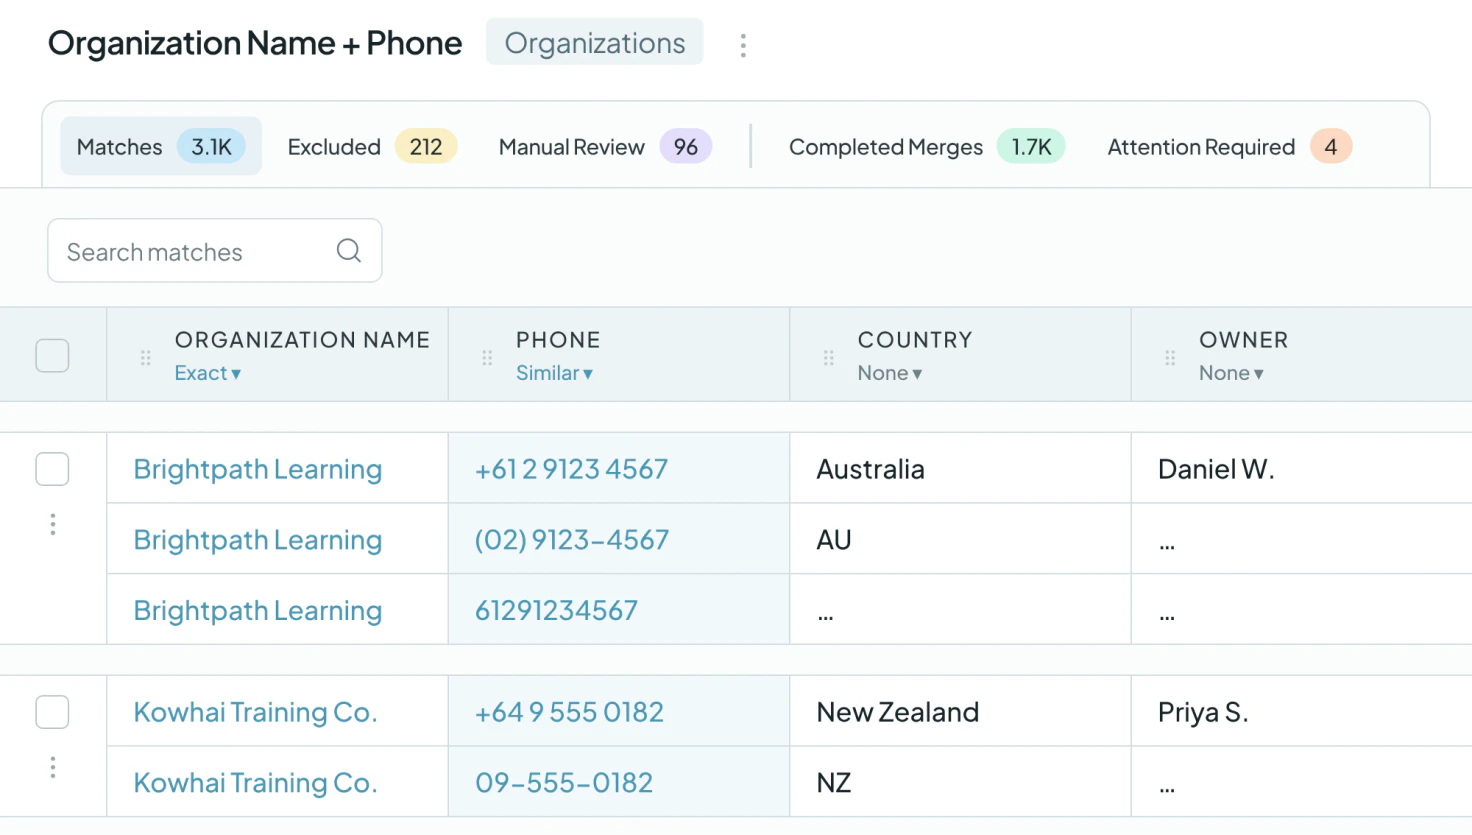
La solution : cesser la correspondance sur l'adresse, correspondre sur le nom et le téléphone avec Similar. Une fusion de test a validé le résultat. Le plan était une série de fusions en masse sur différentes combinaisons.
Ce que la déduplication a changé
Plus de 58 000 enregistrements en doublon fusionnés
L'entreprise a fusionné plus de 29 000 correspondances, combinant au moins 58 000 enregistrements en double. Aujourd'hui, le compte synchronise 26 551 enregistrements.
De zéro au contrôle des données
Au départ, le fondateur ne savait pas ce qu'il regardait. En voyant la première fusion conserver la page LinkedIn, le nombre d'employés et la description de l'ancien CRM, il a dit que c'était exactement ce qu'il tentait de faire. Après le deuxième passage, il a compris qu'il s'y prenait mal et que la session lui avait ouvert les yeux.

- Cas client 9,092 correspondances de personnes fusionnéesPipedrive Recrutement
Comment un cabinet de recrutement a réduit d'un tiers sa liste de contacts Pipedrive après qu'une importation a créé des doublons, avec Dedupely
Lire l'histoire - Cas client 20,000+ enregistrements en doublons fusionnésPipedrive SaaS
Comment une entreprise de réponse téléphonique IA a arrêté la vérification manuelle de Pipedrive et fusionné 20 000+ doublons avec Dedupely
Lire l'histoire - Cas client 200+ correspondances de comptes fusionnées par mois, en moyenneSalesforce Vente au détail
Comment un détaillant a empêché son équipe commerciale de deviner le compte à utiliser dans Salesforce avec Dedupely
Lire l'histoire













