Caso di studio
Come un'azienda SaaS ha unito 58.000+ record duplicate di Pipedrive creati dalla sua migrazione da HubSpot, con Dedupely
- Pipedrive
- Dopo una migrazione CRM
- Dopo l'importazione di un elenco
- SaaS

- 58,000+ record duplicati uniti
- 29,000+ corrispondenze unite
- 2.5x quanto è cresciuto l'elenco Organizzazioni dopo la migrazione
Una corrispondenza è un insieme di record duplicati fusi in un unico record. Ogni corrispondenza contiene almeno due record, quindi il numero di record fusi è almeno il doppio del numero di corrispondenze.
Da dove provengono i duplicati
Un elenco di prospect, importato più volte
L'azienda è un'attività SaaS in Asia-Pacifico che sviluppa una piattaforma di apprendimento per i datori di lavoro. Il fondatore e CEO stava configurando la pipeline di vendita da solo e migrando da HubSpot a Pipedrive. Il piano era semplice: trasferire un elenco di prospetti di circa 26.000 aziende e iniziare a vendere da lì.
La migrazione ha richiesto più di un tentativo:
- La prima importazione non è arrivata come previsto. L'elenco è stato esportato come foglio di calcolo e importato in Pipedrive, ma quando i dati non sono arrivati come previsto, è stato importato di nuovo.
- Uno strumento di migrazione ha spostato di nuovo tutto. Dopo di che, l'intero account è stato trasferito con uno strumento di migrazione, ed è allora che i duplicati sono apparsi.
- Ogni duplicato conteneva dati diversi. Il record del vecchio CRM aveva l'indirizzo completo, la pagina LinkedIn, il numero di dipendenti e la descrizione. Altri avevano solo un paese, scritto in formati diversi.
Il risultato era circa 64.000 Organizzazioni dove ci sarebbero dovuti essere circa 26.000, due volte e mezzo il numero reale.
Cosa hanno rotto i duplicati
Un database illeggibile
Con 64.000 organizzazioni sullo schermo, non c'era modo di dire quali record fossero reali. I dati di una singola azienda erano suddivisi in due, tre, quattro e a volte cinque record, ognuno contenente una parte diversa. Il controllo duplicati di Pipedrive ha segnalato circa 9.000, che non hanno coperto tutti.
I dati migliori dovevano sopravvivere
La pulizia doveva conservare i dati più ricchi dal vecchio CRM. Un'unione che preservasse il record sbagliato eliminerebbe esattamente quello che l'importazione era destinata a portare. Quella preoccupazione mantenne il CRM intatto: dopo aver visto più duplicati accumularsi su quelli iniziali, l'ultima cosa che il fondatore voleva era creare più problemi prima di avere una visione chiara dei dati.
Come sono stati risolti i duplicati
-
1. Abbina per nome, poi restringi per indirizzo
Con il team Customer Success di Dedupely, il fondatore ha iniziato con una ricerca sul nome dell'organizzazione. Di per sé, il nome ha restituito circa 26.000 risultati, troppo ampi per essere affidabili, poiché due aziende diverse possono condividere un nome. Aggiungendo l'indirizzo con Exact matching ha ridotto a 4.211 risultati. Cambiando l'indirizzo a Similar Words sulle prime tre parole, in modo che piccole differenze in come viene scritto un indirizzo non blocchino una corrispondenza, l'ha aumentato a 4.868.
-
2. Mantieni il record con più dati
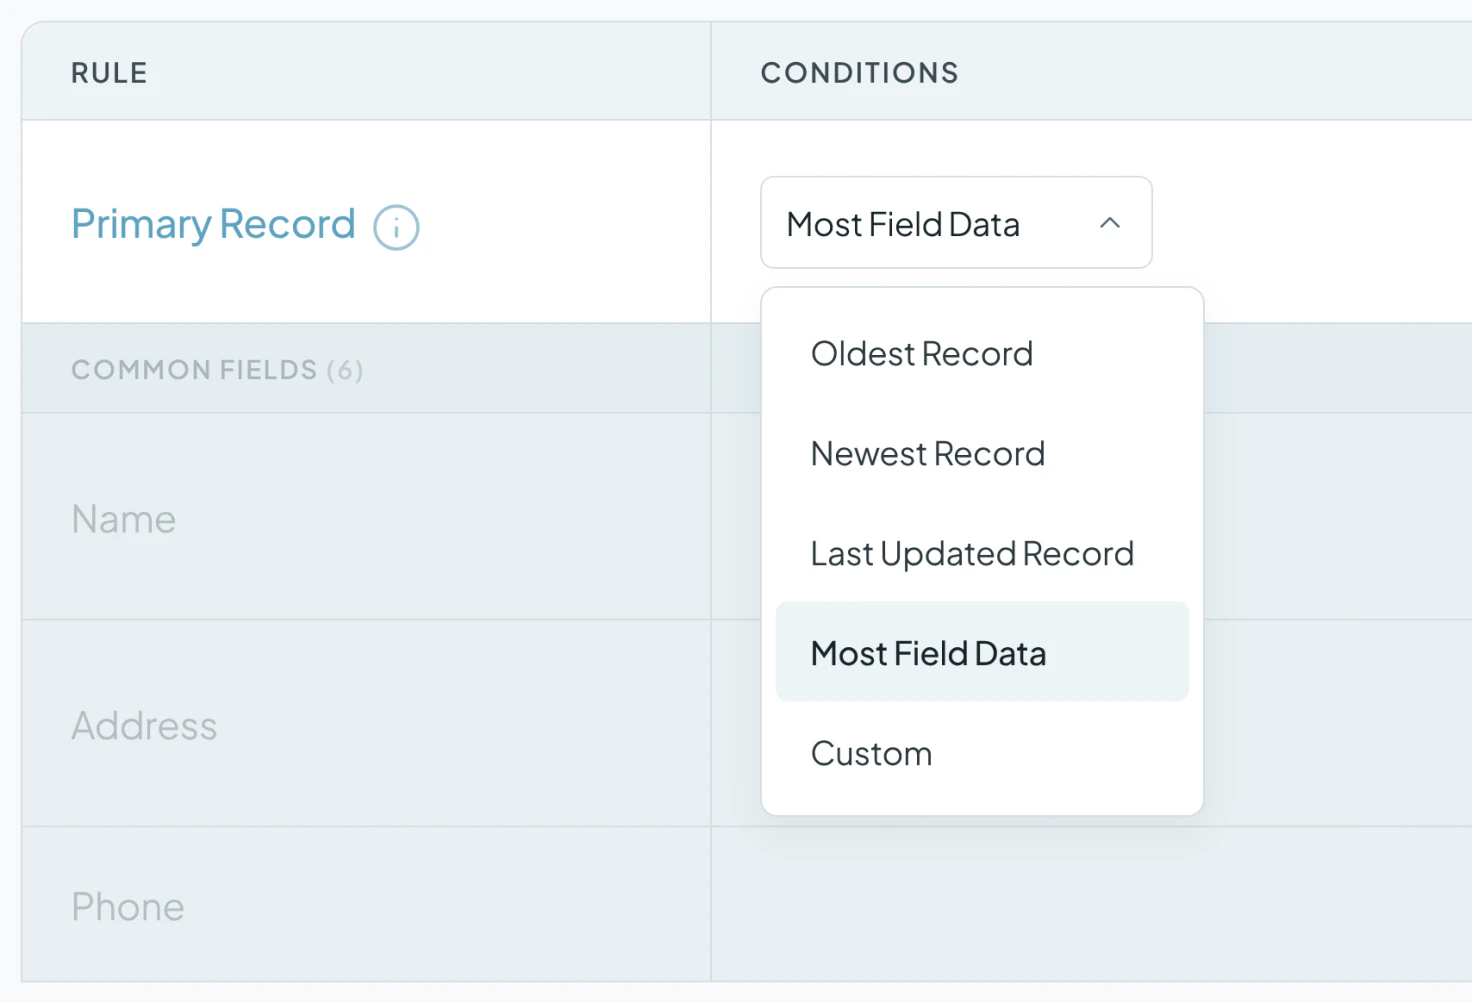
Merge Rules ha deciso cosa sopravvive. La regola del Record Primario è stata impostata su Più Dati Campo, quindi ogni merge piega i duplicati nel record che contiene più informazioni. L'anteprima del merge mostra i valori vincenti in grassetto prima che accada qualsiasi cosa, e i valori vuoti non sovrascrivono mai i dati esistenti.
Un'unione di prova di due record, controllata direttamente in Pipedrive, lo ha confermato: la pagina LinkedIn, il numero di dipendenti e la descrizione dal vecchio CRM erano ancora tutti lì. Dopo di che, le corrispondenze sono state unite in massa, in ondate, in esecuzione in background.
-
3. Se i duplicati persistono, modifica i campi di corrispondenza
Dopo le prime migliaia di unioni, la ricerca era quasi vuota, ma molti duplicati erano ancora visibili in Pipedrive. Il problema era l'indirizzo. Molti duplicati avevano un indirizzo diverso o nessuno, e i valori vuoti non contano come corrispondenza, quindi la ricerca li ha saltati.
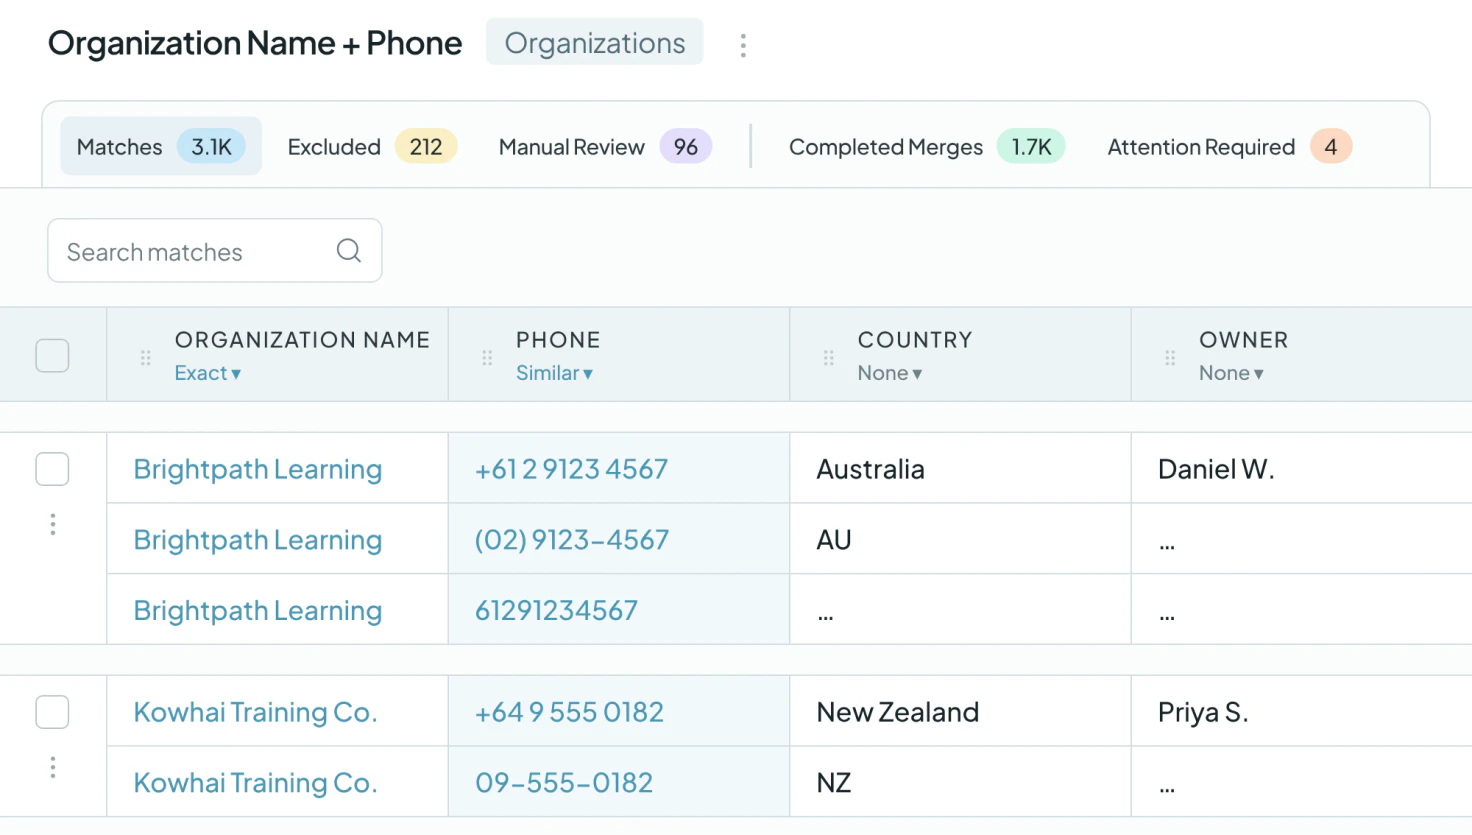
La soluzione era smettere di abbinare sull'indirizzo e abbinare su nome e telefono, con il Telefono impostato su Similar Words in modo che i prefissi internazionali, gli spazi e i trattini non ostacolino l'abbinamento. Un'unione di prova di un'azienda con quattro record ha lasciato esattamente uno in Pipedrive. Da lì, il piano era una serie di merge in massa, ognuno catturando un gruppo che l'ultimo ha perso: nome e telefono, nome e indirizzo di nuovo, poi le prime due parole del nome.
Cosa è cambiato con la deduplicazione
58,000+ record duplicati uniti
L'azienda ha fusionato più di 29.000 corrispondenze, combinando almeno 58.000 record duplicati. Oggi l'account sincronizza 26.551 record.
Da nessuna idea ai dati desiderati
All'inizio, il fondatore ha detto di non avere idea di cosa stesse guardando. Vedendo il primo merge mantenere la pagina LinkedIn, il numero di dipendenti e la descrizione dal vecchio CRM, ha detto che era esattamente quello che stava cercando di fare. Dopo il secondo turno, ha detto che stava procedendo nel modo sbagliato e che la sessione lo aveva aiutato.

- Caso di studio 9,092 corrispondenze di persone fusePipedrive Reclutamento
Come uno studio di executive search ha ridotto il suo elenco di persone in Pipedrive di un terzo dopo che un'importazione ha duplicato quasi tutti, con Dedupely
Leggi la storia - Caso di studio 20,000+ record duplicati unitiPipedrive SaaS
Come un'azienda di risposta telefonica con IA ha smesso di controllare manualmente Pipedrive e ha unito 20.000+ record duplicati con Dedupely
Leggi la storia - Caso di studio 200+ corrispondenze di account fuse al mese, in mediaSalesforce Vendita al dettaglio
Come un rivenditore ha smesso di far indovinare al suo team di vendita quale account usare in Salesforce con Dedupely
Leggi la storia













