Kundengeschichte
Wie ein SaaS-Unternehmen 58.000+ Pipedrive-Duplikate zusammenführte, die durch die Migration von HubSpot entstanden, mit Dedupely.
- Pipedrive
- Nach einer CRM-Migration
- Nach Listenimport
- SaaS

- 58,000+ doppelte Einträge zusammengeführt
- 29,000+ Übereinstimmungen zusammengeführt
- 2.5x wie stark die Organisationsliste nach der Migration wuchs
Eine Übereinstimmung ist ein Satz doppelter Datensätze, die in einem einzelnen Datensatz gemergt werden. Jede Übereinstimmung enthält mindestens zwei Datensätze, daher ist die Anzahl der gemergten Datensätze mindestens doppelt so hoch wie die Anzahl der Übereinstimmungen.
Woher die Duplikate kamen
Eine Prospect-Liste mehrmals importiert
Das Unternehmen ist ein SaaS-Geschäft im asiatisch-pazifischen Raum, das eine Lernplattform für Arbeitgeber entwickelt. Sein Gründer und CEO richtete die Vertriebspipeline selbst ein und migrierte von HubSpot zu Pipedrive. Der Plan war einfach: eine Prospektliste von etwa 26.000 Unternehmen einbringen und damit zu verkaufen.
Die Migration erforderte mehr als einen Versuch:
- Der erste Import kam nicht wie erwartet an. Die Liste wurde als Tabelle exportiert und in Pipedrive importiert. Als die Daten nicht wie erwartet landeten, wurde erneut importiert.
- Ein Migrationstool verschob alles nochmals. Danach wurde das ganze Konto mit einem Migrationstool übertragen, und da zeigten sich die Duplikate.
- Jedes Duplikat enthielt unterschiedliche Daten. Der Eintrag aus dem alten CRM enthielt die vollständige Adresse, LinkedIn-Seite, Mitarbeiterzahl und Beschreibung. Andere hatten nur ein Land, in verschiedenen Formaten geschrieben.
Das Ergebnis war etwa 64.000 Organisationen wo etwa 26.000 hätte sein sollen - zweieinhalb mal so viel wie die echte Anzahl.
Schäden durch Duplikate
Eine Datenbank, die niemand verstehen konnte
Mit 64.000 Organisationen auf dem Bildschirm war unmöglich zu sehen, welche Datensätze echt waren. Die Daten für ein Unternehmen waren über zwei, drei, vier und manchmal fünf Datensätze verteilt, jeder mit einem anderen Teil. Pipedrives Duplikatkontrolle kennzeichnete etwa 9.000 davon, was nicht alle ausmachte.
Die beste Information musste erhalten bleiben
Die Bereinigung musste die wertvolleren Daten aus dem alten CRM beibehalten. Ein Merge, der den falschen Datensatz behalten würde, würde genau das verwerfen, das der Import mitbringen sollte. Diese Sorge hielt das CRM unberührt: Nachdem der Gründer sah, dass immer mehr Duplikate landeten, war das Letzte, das er wollte, mehr Probleme zu schaffen, bevor er einen klaren Überblick über die Daten hatte.
Wie Duplikate gelöst wurden
-
1. Nach Namen abgleichen, dann nach Adresse eingrenzen
Mit dem Customer Success Team von Dedupely begann der Gründer mit einer Suche nach dem Namen der Organisation. Der Name allein ergab etwa 26.000 Treffer, zu viele zum Vertrauen, da zwei verschiedene Unternehmen einen Namen teilen können. Das Hinzufügen der Adresse mit Exact Matching reduzierte dies auf 4.211 Treffer. Beim Umschalten auf Similar Words für die ersten drei Wörter stiegen die Treffer auf 4.868.
-
2. Den Eintrag mit den meisten Daten behalten
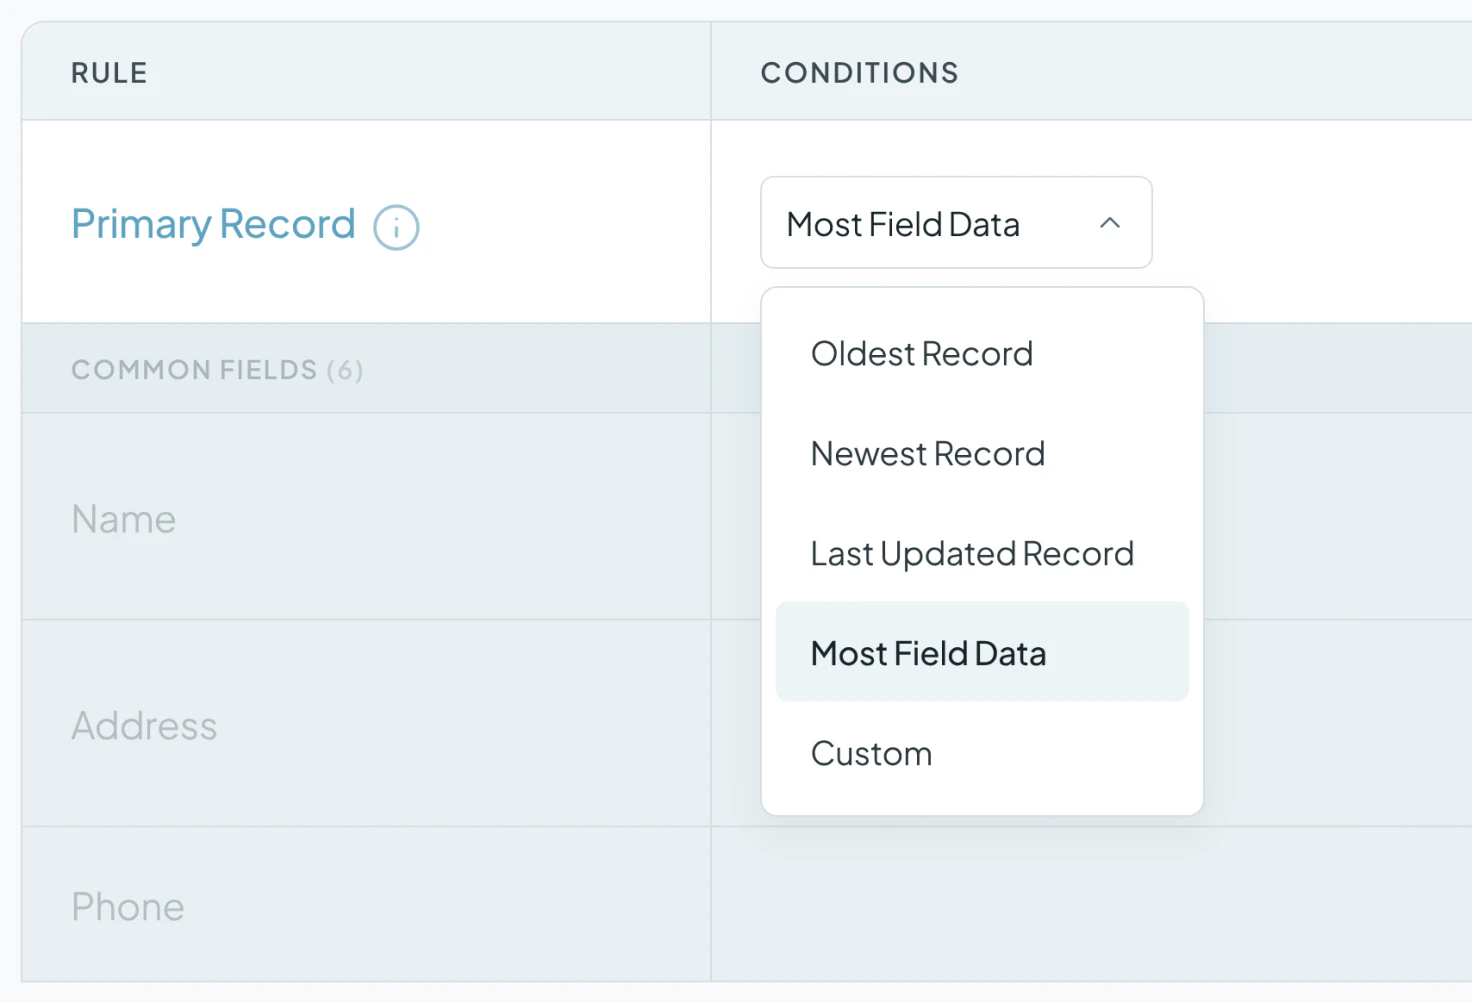
Merge Rules bestimmte, was erhalten bleibt. Die Primary Record-Regel war auf Most Field Data eingestellt, daher werden bei jeder Zusammenführung die Duplikate in den Datensatz mit den meisten Informationen gefaltet. Die Merge-Vorschau zeigt die Gewinnwerte fett, bevor etwas geschieht, und leere Werte überschreiben nie vorhandene Daten.
Ein Test-Merge zweier Einträge, direkt in Pipedrive überprüft, bestätigte es: Die LinkedIn-Seite, Mitarbeiterzahl und Beschreibung aus dem alten CRM waren noch da. Danach wurden Treffer in Bulk, in Wellen, im Hintergrund zusammengeführt.
-
3. Wenn noch Duplikate vorhanden sind, ändern Sie die Abgleichfelder
Nach einigen tausend Merges war die Suche fast leer, aber in Pipedrive waren immer noch viele Duplikate sichtbar. Die Adresse war das Problem. Viele Duplikate hatten eine andere Adresse oder gar keine, und leere Felder werden nicht als Übereinstimmung gewertet, sodass die Suche sie übersprang.
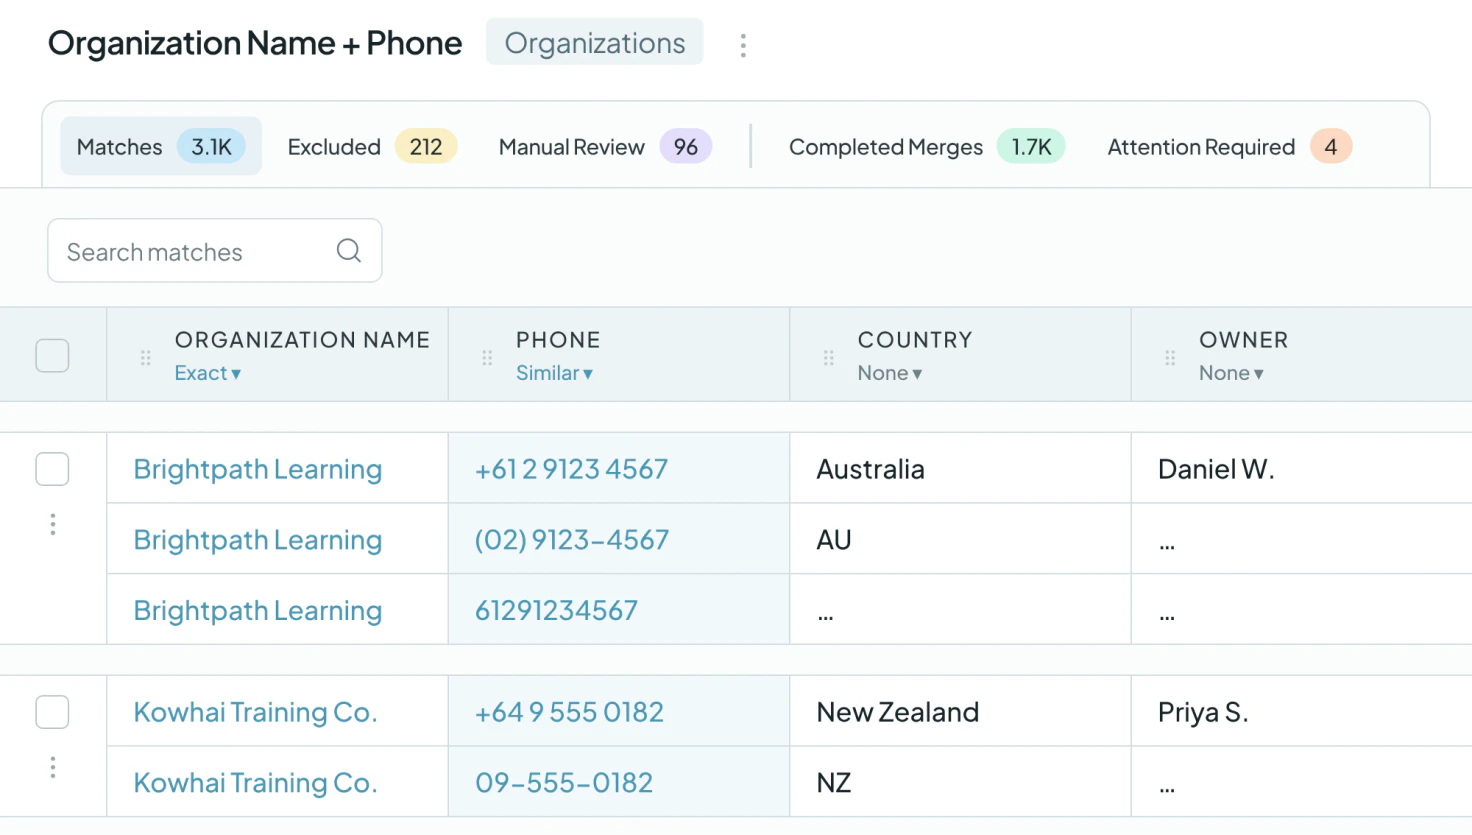
Die Lösung war, nicht mehr auf Adresse abzugleichen, sondern auf Name und Telefon, mit Telefon auf Ähnlich eingestellt, sodass Landeskennzahlen, Leerzeichen und Bindestriche nicht störten. Ein Test-Merge eines Unternehmens mit vier Einträgen hinterließ genau einen in Pipedrive. Von dort aus war der Plan eine Reihe von Bulk Merges, jeweils fangend eine Gruppe, die die letzte verpasst hatte: Name und Telefon, Name und Adresse erneut, dann die ersten zwei Wörter des Namens.
Das bewirkte die Deduplizierung
58.000+ doppelte Datensätze zusammengeführt
Das Unternehmen hat mehr als 29.000 Übereinstimmungen gemergt und dabei mindestens 58.000 doppelte Datensätze kombiniert. Heute synchronisiert das Konto 26.551 Datensätze.
Von Datenchaos zu zuverlässigen Daten
Anfangs sagte der Gründer, er habe nicht gewusst, was er sah. Als die erste Zusammenführung die LinkedIn-Seite, Mitarbeiterzahl und Beschreibung aus dem alten CRM behielt, sagte er, das sei genau das, was er erreichen wollte. Nach dem zweiten Durchgang sagte er, er sei falsch vorgegangen, und die Sitzung hätte geholfen.

- Kundengeschichte 9,092 Personenübereinstimmungen gemergtPipedrive Personalvermittlung
Wie ein Executive Search Unternehmen seine Pipedrive-Personenliste um ein Drittel verringerte, nachdem ein Import fast alle dupliziert hatte, mit Dedupely.
Geschichte lesen - Kundengeschichte 20,000+ doppelte Einträge zusammengeführtPipedrive SaaS
Wie ein KI-Telefonanbieter mit Dedupely 20.000+ Duplikate in Pipedrive zusammenführte
Geschichte lesen - Kundengeschichte 200+ Kontenübereinstimmungen pro Monat, durchschnittlich gemergtSalesforce Einzelhandel
Wie ein Einzelhandelshändler sein Vertriebsteam mit Dedupely von Vermutungen über das richtige Salesforce-Konto befreite
Geschichte lesen













