Partnergeschichte
Wie ein CRM-Berater einem Personalvermittlungsunternehmen half, 16.000+ doppelte HubSpot Einträge aus seinem Rollout mit Dedupely zu fusionieren
- HubSpot
- Nach Listenimport
- Integration oder Synchronisierung
- Personalvermittlung

- 16,000+ doppelte Einträge zusammengeführt
- 8,200+ Übereinstimmungen zusammengeführt
- 54,507 zu Dedupely synchronisierte Datensätze
Eine Übereinstimmung ist ein Satz doppelter Datensätze, die in einem einzelnen Datensatz gemergt werden. Jede Übereinstimmung enthält mindestens zwei Datensätze, daher ist die Anzahl der gemergten Datensätze mindestens doppelt so hoch wie die Anzahl der Übereinstimmungen.
Woher die Duplikate kamen
Ein Rollout, das alles mehrmals geladen hat
Der Kunde ist ein IT-Personalvermittlungs- und Recruitingunternehmen mit mehreren Büros. Er betreibt Vertrieb und Marketing in HubSpot und speichert seine Firmen und Kontakte in einem Bewerberverfolgungssystem (ATS), das die zentrale Datenquelle ist. Ein unabhängiger CRM-Berater, der das Unternehmen beim HubSpot Rollout unterstützte und dessen Produktmanager ist, übernahm das Duplikatproblem.
Die Duplikate entstanden beim Rollout:
- Große Importe aus dem ATS. Bei HubSpot-Start wurden Kontakte und Unternehmen massenweise aus dem ATS importiert. Eine damals eingerichtete Integration verschärfte das Problem.
- Fehlerhafte Daten. Einige Importe enthielten Firmennamen mit der falschen Adresse oder falscher ATS-ID.
- Zwei Web-Domains für eine Firma. Viele Unternehmen haben sowohl eine .com als auch eine Länderdomäne, und HubSpot behandelte sie als zwei unterschiedliche Unternehmen.
Es gab etwa 22.000 Unternehmen statt der erwarteten 10.000 und 120.000 Kontakte, manche dreimal, viermal oder fünfmal in HubSpot.
Schäden durch Duplikate
Aktivität auf dem falschen Datensatz protokolliert
Sales loggten Anrufe und Notizen zu einem Datensatz, suchten die Person später erneut auf und fanden ihre eigene Historie nicht. HubSpot ließ nur zwei Datensätze gleichzeitig mit täglichem Limit zusammenführen, die Duplikat-Zahlen sanken kaum.
Ein Marketingprogramm auf Eis
Die Firma wollte ein Marketingprogramm starten, konnte es aber mit so vielen Duplikaten nicht. Dieselbe Person könnte dieselbe E-Mail mehrfach erhalten, oder HubSpot würde den Versand stoppen. Der Berater sagte, sie müssten die Daten einfach bereinigen, bevor sie ein zuverlässiges Programm ausführen könnten.
Wie Duplikate gelöst wurden
-
1. Erst testen, Freigabe durch den Kunden
Das Unternehmen hatte sein eigenes Dedupely-Konto und die Beraterin arbeitete als Gastnutzerin darin, sodass das Tool bleibt. Sie testete zuerst bei alten, unveränderten Datensätzen, und nichts lief über die ganze Datenbank, bis der CIO zustimmte.
-
2. Legen Sie fest, welche Werte gewinnen – Feld für Feld
Bevor zusammengeführt wurde, einigten sich der Berater und die Kanzlei darauf, welche Werte nach einer Zusammenführung überleben sollen – Feld für Feld – und die Kanzlei genehmigte Merge Rules:
- Primärer Datensatz: der älteste Eintrag.
- Email und Telefon: der Datensatz mit der neuesten Aktivität gewinnt, da das die wahrscheinlich aktuelle E-Mail und Nummer der Person ist.
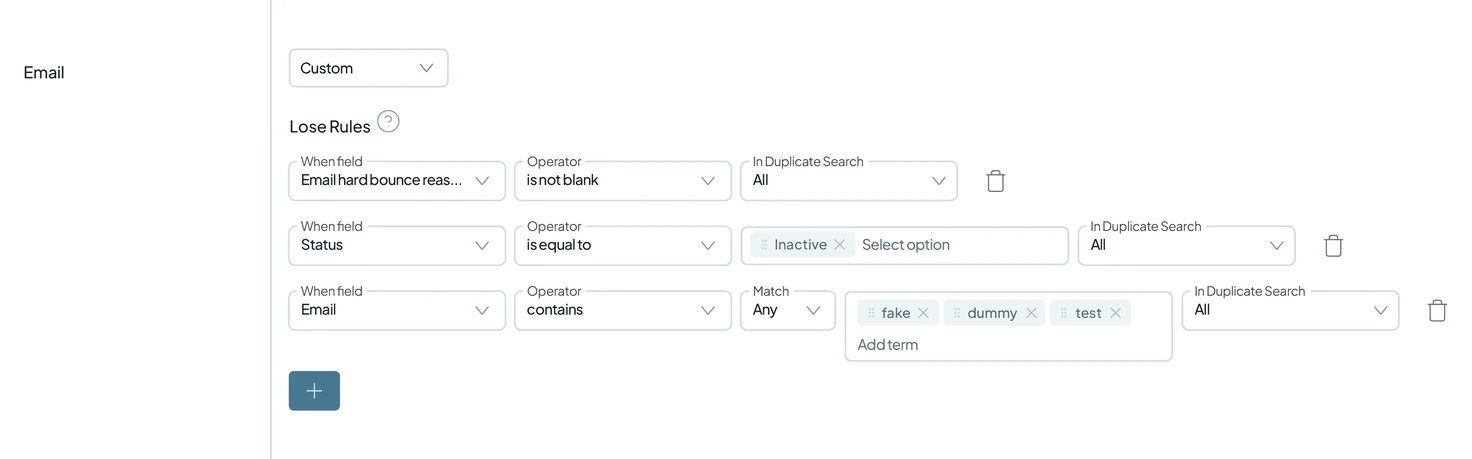
- Fehlerhafte E-Mails führen: Lose Rules entfernen E-Mails von inaktiven Kontakten, hart abgeprellte E-Mails sowie Test-Adressen mit Wörtern wie dummy, fake oder example.
- Die ATS-ID: Die ID des zuletzt erstellten Eintrags gewinnt, da die neueste Charge vom ATS die korrekte ID trägt.
- Datensätze ehemaliger Mitarbeiter verlieren: Bei E-Mail, Telefon, Inhaber und Kontaktstatus verlieren Werte ehemaliger Mitarbeiter, das aktive Team behält den Eintrag.
- Lead-Status und Lifecycle Stage: aus dem primären Datensatz beibehalten.
Leere Werte überschreiben niemals vorhandene Daten.
-
3. Mergen in Schichten, von offensichtlich bis knifflig
Die erste Firmensuche basierte auf vier Kriterien: ähnlicher Firmenname, Adresse (Similar Words, beliebige Reihenfolge), Firmeneigentümer und ATS-ID. Treffer mit so vielen Übereinstimmungen sind gute Kandidaten für einen Bulk Merge. Später wurden die Suchfelder Schritt für Schritt gelockert, sodass offensichtliche Duplikate zuerst verarbeitet werden konnten und schwierigere Fälle mehr Aufmerksamkeit bekamen.
-
4. Unternehmenszweige getrennt halten
Viele Unternehmen haben mehrere Niederlassungen, die einen Namen teilen. Um zu verhindern, dass Filialen miteinander zusammengeführt werden, arbeitete die Beraterin eine Suche eigenständig durch: ähnlicher Unternehmensname und exakte ATS-ID, mit einem Filter, damit mindestens ein Datensatz in jedem Match keine Adresse hatte. Während sie diese Suche bearbeitete, die Safety Settings für Unternehmen waren auf zwei Datensätze pro Treffer eingestellt, daher wurden alles Größere in Excluded Matches zurückgehalten statt zusammengeführt. Da Sicherheitseinstellungen auf jede Unternehmenssuche zutreffen, wurde diese Suche separat behandelt. Auf diese Weise werden Datensätze ohne Adresse mit solchen mit einer Adresse zusammengeführt, und zwei Standorte mit Adressen werden nicht kombiniert. Der Berater führte diese Treffer im Bulk zusammen. Gleichzeitig löschten der Berater und der CIO der Kanzlei etwa 7.200 leere Unternehmenseinträge ohne Aktivitäten.
Das bewirkte die Deduplizierung
16.000+ doppelte Datensätze zusammengeführt
Das Unternehmen hat über 8.200 Treffer zusammengeführt und mindestens 16.000 doppelte Datensätze kombiniert. Heute synchronisiert Dedupely 54.507 Datensätze für das Unternehmen.
Eine Bereinigung im laufenden Betrieb
Früh schon sagte die Beraterin, Dedupely sei das richtige Tool für den Kunden. Da das Konto der Firma gehört, soll jemand aus ihrem Team die Regeln und Suchen lernen und die Daten nach der initialen Bereinigung sauberzuhalten.

- Kundengeschichte 9,000+ doppelte Einträge zusammengeführtHubSpot Gesundheitswesen
Wie ein Telemedizin-Unternehmen 9.000+ doppelte HubSpot Einträge aus seiner Calling App, Formularen und Integrationen mit Dedupely fusionierte
Geschichte lesen - Kundengeschichte 1,600+ doppelte Einträge zusammengeführtHubSpot Immobilien
Wie ein Renovierungsunternehmen 1.600+ doppelte HubSpot-Datensätze einer Call-Tracking-Integration mit Dedupely zusammengeführt hat
Geschichte lesen - Kundengeschichte 2,158 Unternehmens-Matches in unter 7 Wochen zusammengefasstHubSpot Finanzdienstleistungen
Wie ein Fintech seinem Sales-Team eine zuverlässige Pipeline gab, indem es 4.000+ Duplicate Matches mit Dedupely bereinigt hat.
Geschichte lesen












