Kundengeschichte
Wie ein Fintech seinem Sales-Team eine zuverlässige Pipeline gab, indem es 4.000+ Duplicate Matches mit Dedupely bereinigt hat.
- HubSpot
- Jahrelang angesammelte Altdaten
- Finanzdienstleistungen

- 2,158 Unternehmens-Matches in unter 7 Wochen zusammengefasst
- 1,852 Deal-Matches in unter 7 Wochen zusammengefasst
- 12 Suchvorgänge mit Auto Merge
Eine Übereinstimmung ist ein Satz doppelter Datensätze, zusammengefasst zu einem Datensatz. Jede Übereinstimmung enthält mindestens zwei Datensätze, viele davon drei oder mehr. Die Gesamtzahl der zusammengefassten Datensätze ist mehr als doppelt so hoch wie die Anzahl der Übereinstimmungen.
Woher die Duplikate kamen
Ein Unternehmen, zwei Website-Felder und ein Deal für jedes Duplikat
Das Unternehmen ist ein Fintech-Geschäft, das seine Verkaufspipeline in HubSpot mit über 500.000 Datensätzen und ein paar tausend Deals verwaltet. Der RevOps-Manager hatte Dedupely ein paar Jahre zuvor verwendet, war davon abgewichen und kam zurück mit dem, was er als großes Duplikatproblem auf Unternehmens- und Deal-Ebene beschrieb. Er hatte bereits eigene Suchvorgänge und Merge Rules erstellt, und Duplikate gelangten immer noch durch.
Drei Dinge erzeugten sie ständig:
- Die Website existierte an zwei Orten. Einige Firmeneinträge speicherten die Information im Domain-Feld, andere in einem zweiten Website-Feld. Eine Suche auf einem Feld konnte die Duplikate im anderen nicht finden.
- Unternehmensfusionen erstellten Deal-Duplikate. Wenn zwei Unternehmen zusammengeführt wurden, brachte jede ihren eigenen Deal mit, sodass das überlebende Unternehmen mit zwei Deals in derselben Pipeline endete. Jede Unternehmensbereinigung konnte eine neue Deal-Bereinigung hinterlassen.
- Nicht jeder Datensatz sollte übereinstimmen. Unternehmen aus persönlichen E-Mail-Domains wie Gmail oder Yahoo erstellt, und Unternehmen, die zu einem Mutterunternehmen gehören, mussten aus der Zusammenführung ausgenommen werden, sonst würden falsche Einträge kombinieren.
Schäden durch Duplikate
Eine wöchentliche Suche nach Datensätzen, die zusammengeführt werden sollten
Als er zurückkam, sagte er, die Duplikate verursachten Chaos. Fast jede Woche würde er Datensätze finden, die hätten fusionieren sollen, es aber nicht taten, und fragte sich, warum es immer noch so viele Duplikate gab.
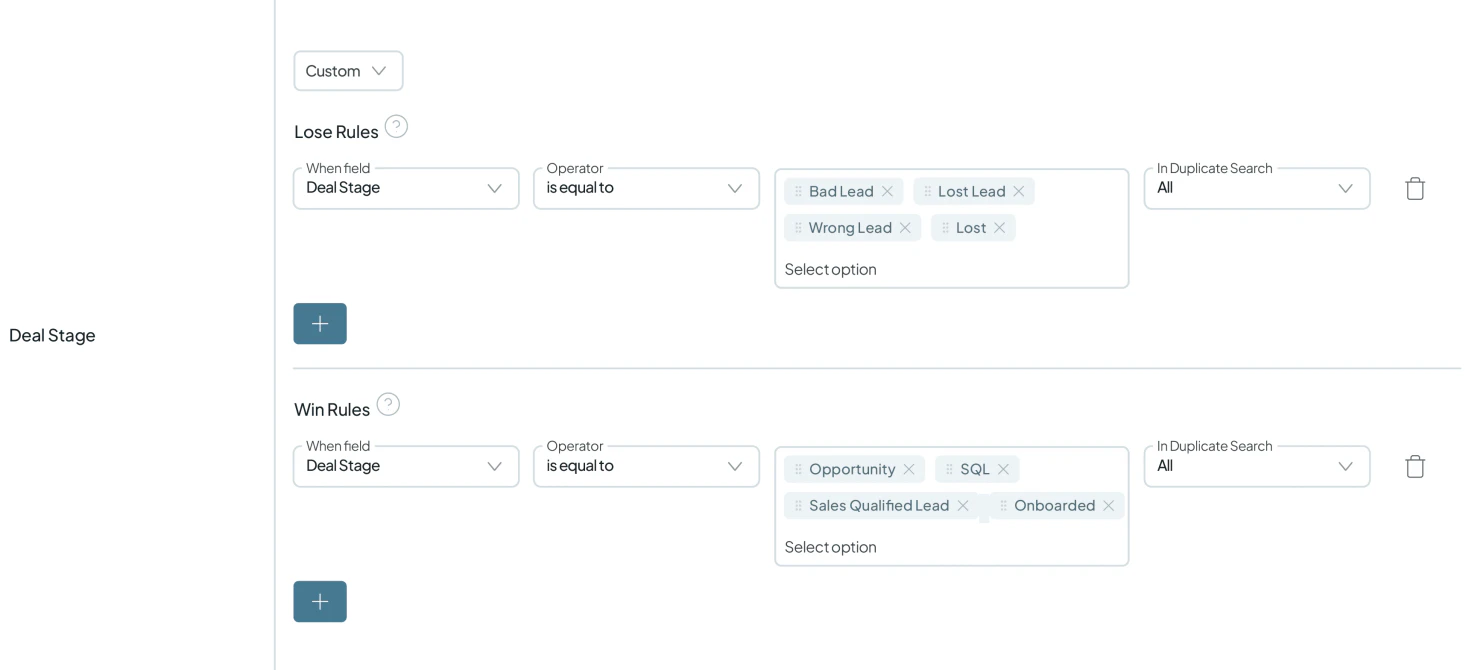
Ein zusammengefasstes Unternehmen konnte mit zwei Deals für denselben Kunden in derselben Pipeline enden. Jemand musste sie manuell zusammenfassen. Das Team legte vorab fest, welche Deal-Phasen eine Zusammenfassung überstehen sollten. Phasen wie Verloren oder Schlechter Lead wurden so eingestellt, dass sie nicht übernommen werden.
Warum zu lockere Regeln riskant waren
Das Matching auf zu wenig war riskant in dieser Größenordnung. Anfangs führte eine automatisierte Unternehmenssuche zwei Unternehmen zusammen, deren Domänen bis auf die Endung übereinstimmten. Domain Root ignoriert absichtlich www, .com und Ländervarianten, sodass die Suche das tat, wofür sie konzipiert war. Er machte sich über dieses Paar keine Sorgen, aber er pausierte die Suche Auto Merge und fügte eine zweite Prüfung hinzu, sodass zwei wirklich unterschiedliche Unternehmen nicht auf die gleiche Weise zusammengeführt werden könnten.
Zu viel Matching übersah echte Duplikate. Eine Suche, die beide Domain und Website-Feld erforderte, übersprang Paare, bei denen ein Datensatz das Website-Feld leer ließ, da leere Werte nicht als Übereinstimmung zählen.
Wie Duplikate gelöst wurden
-
1. Felder für die Suche hinzufügen
Die erste Lösung war, die richtigen Felder hinzuzufügen. Mit dem Customer Success Team von Dedupely fügte er das zweite Website-Feld zu den Unternehmenssuchen hinzu sowie den Namen und die Website des verknüpften Unternehmens zu Deal-Suchen. Dann wartete er auf die Resynchronisierung, damit die neuen Felder in den Ergebnissen angezeigt wurden. Jeder von Dedupely durchgeführte Merge wird auch in der Merge History aufgezeichnet, die das Team als CSV exportierte.
-
2. Unternehmen nach Domain abgleichen mit Schutzvorrichtungen
Unternehmenssuchen nutzen Domain Root, die die Kerndomäne vergleicht und www, .com und Ländervarianten ignoriert. Um verschiedene Unternehmen auseinanderzuhalten, fügte er ein zweites Feld hinzu: Land oder Region. So erfordert eine Übereinstimmung die gleiche Domain und das gleiche Land.
Filter halten falsche Datensätze vor dem Matching aus. Ein Filter entfernt Unternehmen mit privaten E-Mail-Domains wie Gmail, Yahoo und Proton. Ein anderer schließt Unternehmen mit übergeordneter Gesellschaft aus. Mehr Abgleichfelder bedeuten weniger, aber solidere Ergebnisse.
-
3. Geben Sie Deals eine eigene Suche und eigene Regeln
Deals Auf das zugehörige Unternehmen und die Pipeline abgleichen, sodass zwei Deals nur zusammengefasst werden, wenn sie zum selben Client in der selben Pipeline gehören. Das erfasst genau das Paar, das ein Unternehmenszusammenführung hinterlässt.
Merge Rules bestimmen Sie, was erhalten bleibt. Bei Deals ist der Primary Record der älteste Deal, daher behält eine Zusammenführung den zuerst erstellten Deal. Bei Deal-Stufen machen Lose Rules Stufen wie Leads, Bad lead und Lost sind Lose Rules, und Win Rules bevorzugen Stufen, die echten Fortschritt zeigen, wie Qualified Leads, Opportunities und onboarded Customers. Lose Rules werden immer vor Win Rules ausgeführt, und leere Felder überschreiben nie vorhandene Daten.
-
4. Nach Plan automatisieren, dann überwachen
Sobald eine Suche nur noch echte Duplikate zurückgab, aktivierte er Auto Merge, das neue Duplikate planmäßig anhand der Suchkriterien und ihrer Merge Rules zusammenführt. Unternehmenssuchen, die alle paar Minuten liefen, wurden auf einen täglichen Plan verlegt, und Deal-Suchen laufen an festgelegten Tagen. Als er Auto Merge für eine neue Deal-Suche einrichtete, plante er, die Ergebnisse genau zu überprüfen, bevor er sie aktivierte.
Das Ablehnen von Übereinstimmungen machte es sicherer. Wenn ein Paar kein echtes Duplikat ist, lehnt er es ab, und es wird aus aktuellen und zukünftigen Suchen entfernt, sodass es nie aus Versehen zusammengeführt wird.
Das bewirkte die Deduplizierung
Suchvorgänge, die sich selbst ausführen
Innerhalb von wenigen Wochen mergte er so viele, dass er die Anzahl aufgehört hatte zu zählen. Bald darauf führte seine automatisierte Hauptsuche für Unternehmen ihre Aufgabe aus, erfasste die meisten Duplikate und flaggte nur gelegentlich einen echten Grenzfall, daher ließ er sie laufen. Eine ältere einmalige Suche gab nun nichts mehr zurück, höchstwahrscheinlich weil ihre Duplikate bereits gemergt waren.
Die Zahlen bestätigen es. In weniger als 7 Wochen mergte das Team 2.158 Unternehmensübereinstimmungen und 1.852 Deal-Übereinstimmungen, viele mit drei oder mehr Datensätzen in einer Übereinstimmung. Zwölf Suchvorgänge laufen jetzt mit Auto Merge, sodass neue Duplikate über Unternehmen und Deals nach Plan gemergt werden, statt dass jemand sie entdecken muss.
Ein Tool, das das Team ständig erweiterte
Er pries Dedupleys Fähigkeit an, ihre Datensätze zu deduplizieren, und das Team baute das Setup weiter aus: separate Suchen für Unternehmen und Deals, Merge Rules für jedes Objekt und Filter, um die falschen Datensätze auszuschließen.
Verwandte

- Kundengeschichte 140,000+ doppelte Einträge zusammengeführtSalesforce Gesundheitswesen
Wie ein Healthcare-Softwareunternehmen mit Dedupely doppelte Bereinigung von Duplikaten in HubSpot und Salesforce vermied
Geschichte lesen - Kundengeschichte 58,000+ doppelte Einträge zusammengeführtPipedrive SaaS
Wie ein SaaS-Unternehmen 58.000+ Pipedrive-Duplikate zusammenführte, die durch die Migration von HubSpot entstanden, mit Dedupely.
Geschichte lesen - Kundengeschichte 20,000+ doppelte Einträge zusammengeführtPipedrive SaaS
Wie ein KI-Telefonanbieter mit Dedupely 20.000+ Duplikate in Pipedrive zusammenführte
Geschichte lesen














