Caso di studio
Come una Fintech ha dato al suo team di vendita una pipeline affidabile eliminando 4.000+ corrispondenze duplicate con Dedupely
- HubSpot
- Anni di dati legacy
- Servizi finanziari

- 2,158 match aziendali uniti in meno di 7 settimane
- 1,852 match di deal uniti in meno di 7 settimane
- 12 ricerche in Auto Merge
Un match è un insieme di record duplicate uniti in un unico record. Ogni match contiene almeno due record, e molti ne contenevano tre o più, quindi il numero di record uniti è più del doppio del numero di match.
Da dove provengono i duplicati
Un'azienda, due campi sito web e un'offerta per ogni duplicato
L'azienda è un'attività fintech che gestisce la sua pipeline di vendita in HubSpot, con più di 500.000 record e un paio di migliaia di deal. Il manager di RevOps aveva utilizzato Dedupely un paio di anni prima, se ne era allontanato e è tornato con quello che ha descritto come un grande problema di duplicati a livello di società e a livello di deal. Aveva già costruito ricerche e Merge Rules proprie, e i duplicati continuavano a passare.
Tre fattori li creavano continuamente:
- Il sito web viveva in due posti. Alcuni record aziendali lo hanno memorizzato nel campo dominio, altri in un secondo campo sito web. Una ricerca su un campo non ha trovato i duplicati nascosti nell'altro.
- Le fusioni aziendali hanno creato duplicati di trattative. Quando due aziende si univano, ognuna portava la sua offerta, quindi l'azienda superstite finiva con due offerte nella stessa pipeline. Ogni pulizia di aziende potrebbe lasciare dietro una nuova pulizia di offerte.
- Non tutti i record dovrebbero corrispondere. Aziende creati da domini di posta personali, come Gmail o Yahoo, e le aziende che appartengono a un'azienda madre dovevano stare fuori dall'unione, altrimenti i record sbagliati si combinerebbero.
Cosa hanno rotto i duplicati
Una ricerca settimanale di record che avrebbero dovuto essere uniti
Quando è tornato, ha detto che i duplicati stavano causando il caos. Quasi ogni settimana trovava record che avrebbero dovuto unirsi e non l'avevano fatto, e si chiedeva perché ci fossero ancora così tanti duplicati.
Lato deal, un'azienda unita poteva avere due deal per lo stesso cliente nella stessa pipeline, e richiedeva un'unione manuale. Il team aveva già deciso quali deal stage dovevano sopravvivere a un merge, con stage come Lost o Bad lead impostati per essere scartati.
Perché le regole poco restrittive erano rischiose
Cercare con troppi pochi criteri era rischioso a questa scala. All'inizio, una ricerca automatica di aziende ha unito due aziende i cui domini corrispondevano tranne per l'estensione. Domain Root ignora www, .com e varianti di paese per scelta progettuale, quindi la ricerca ha fatto quello per cui era stata impostata. Non era preoccupato per quella coppia, ma ha messo in pausa la ricerca Auto Merge e ha aggiunto un secondo controllo, in modo che due aziende realmente diverse non potessero unirsi nello stesso modo.
L'abbinamento su troppi elementi ha invece mancato i duplicati reali. Una ricerca che richiedeva sia il dominio che il campo del sito web ha saltato le coppie in cui un record ha lasciato il sito web vuoto, perché i valori vuoti non contano come corrispondenza.
Come sono stati risolti i duplicati
-
1. Importa i campi che le ricerche richiedono
La prima soluzione è stata aggiungere i campi giusti. Con il team di customer success di Dedupely, ha aggiunto il secondo campo sito web alle ricerche di azienda, e il nome e il sito web dell'azienda associata alle ricerche di opportunità, poi ha aspettato la risincronizzazione affinché i nuovi campi apparissero nei risultati. Ogni unione viene registrata in Merge History, che il team ha esportato come backup CSV.
-
2. Abbina aziende per dominio, con protezioni
Le ricerche di aziende corrispondono su Domain Root, che confronta il dominio principale e ignora www, .com e varianti di paese. Per mantenere diverse aziende separate, ha aggiunto un secondo campo, paese o regione, così una corrispondenza richiede lo stesso dominio e lo stesso paese.
I filtri escludono i record sbagliati prima che inizia la ricerca di corrispondenze. Un filtro elimina le aziende con domini email personali come Gmail, Yahoo e Proton. Un altro esclude le aziende che hanno un'azienda madre. Più campi di corrispondenza significano meno risultati, ma duplicati più solidi.
-
3. Assegna ai deal la loro ricerca e le loro regole
Deal abbina l'azienda associata e la pipeline, in modo che due affari si uniscono solo quando appartengono allo stesso cliente nella stessa pipeline. Questo cattura esattamente la coppia che un'unione aziendale lascia indietro.
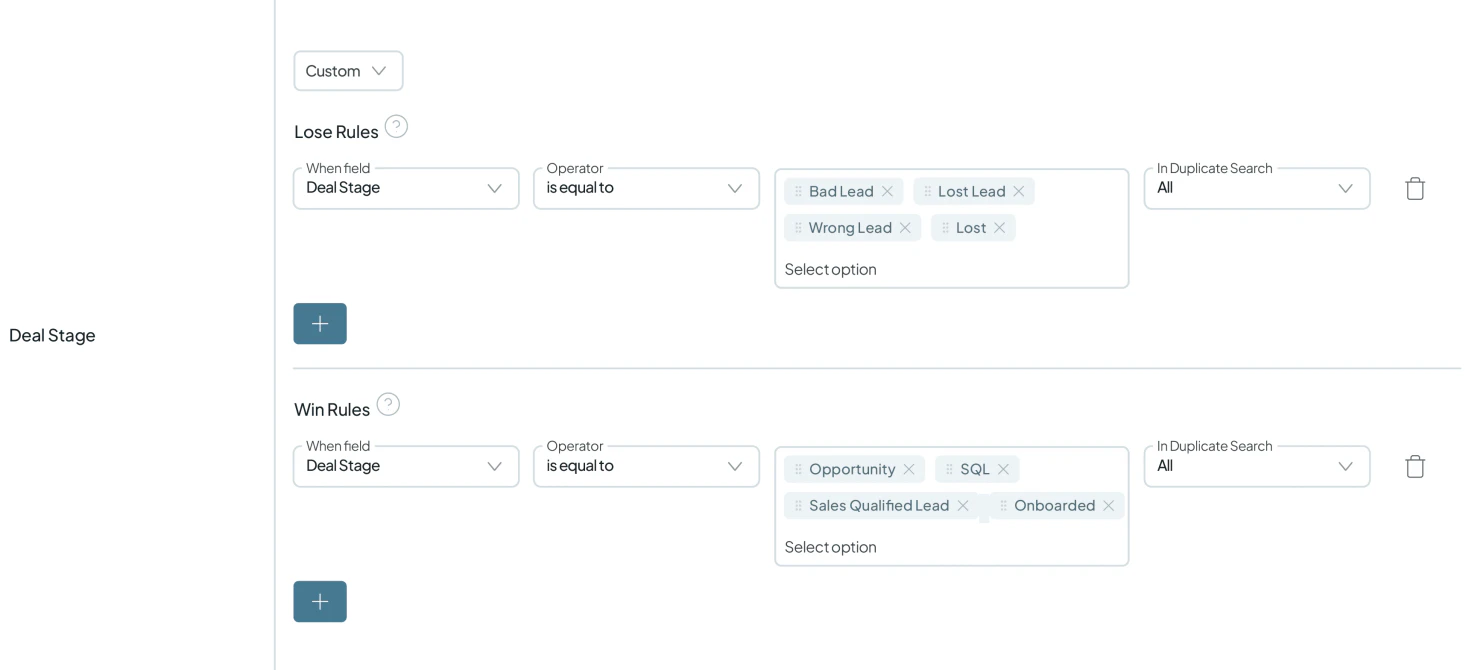
Merge Rules decidi cosa sopravvive. Per le offerte, il Record Primario è l'offerta più vecchia, quindi un merge mantiene sempre l'offerta creata per prima. Sulla fase dell'offerta, le Lose Rules trasformano fasi come Lead, Lead cattivi e Opportunità perse perdono, e Win Rules favoriscono le fasi che mostrano veri progressi, come lead qualificati, opportunità e clienti integrati. Le Lose Rules vengono sempre eseguite prima delle Win Rules e i campi vuoti non sovrascrivono mai i dati esistenti.
-
4. Automatizza secondo programma, poi monitora
Una volta che una ricerca ha restituito solo veri duplicati, ha attivato Auto Merge, che unisce i nuovi duplicati secondo una pianificazione utilizzando i criteri della ricerca e le sue Merge Rules. Le ricerche di aziende che si eseguivano ogni pochi minuti sono passate a una pianificazione giornaliera, e le ricerche di affari vengono eseguite in giorni prestabiliti. Quando ha impostato Auto Merge su una nuova ricerca di affari, ha pianificato di rivedere attentamente i risultati prima di lasciarla attiva.
Rifiutare le corrispondenze ha reso il processo più sicuro. Quando una coppia non è un vero duplicato, la rifiuta e viene esclusa dalle ricerche attuali e future, in modo che non venga mai unita per errore.
Cosa è cambiato con la deduplicazione
Ricerche che si eseguono da sole
Nel giro di poche settimane stava facendo tante fusioni da aver smesso di contare. Poco dopo, la sua ricerca principale di società automatizzata stava facendo il suo lavoro, intercettando la maggior parte dei duplicati e occasionalmente marcando solo un caso limite, così l'ha lasciata in esecuzione. Una ricerca precedente non strutturata ora non restituiva più nulla, molto probabilmente perché i suoi duplicati erano già stati fusionati.
I numeri lo confermano. In meno di 7 settimane, il team ha fusionato 2.158 corrispondenze di società e 1.852 corrispondenze di deal, molti con tre o più record in una singola corrispondenza. Dodici ricerche ora vengono eseguite in Auto Merge, quindi i nuovi duplicati tra società e deal si fusionano secondo una pianificazione anziché aspettare che qualcuno li individui.
Uno strumento su cui il team ha continuato a investire
Ha descritto Dedupely come una soluzione eccellente per deduplicare i loro record, e il team ha continuato ad aggiungere alla configurazione: ricerche separate per aziende e accordi, Merge Rules per ogni oggetto e filtri che escludono i record sbagliati.
Correlato

- Caso di studio 140,000+ record duplicati unitiSalesforce Sanità
Come un'azienda di software sanitario ha eliminato i duplicati una sola volta tra HubSpot e Salesforce con Dedupely
Leggi la storia - Caso di studio 58,000+ record duplicati unitiPipedrive SaaS
Come un'azienda SaaS ha unito 58.000+ record duplicate di Pipedrive creati dalla sua migrazione da HubSpot, con Dedupely
Leggi la storia - Caso di studio 20,000+ record duplicati unitiPipedrive SaaS
Come un'azienda di risposta telefonica con IA ha smesso di controllare manualmente Pipedrive e ha unito 20.000+ record duplicati con Dedupely
Leggi la storia














