Cas client
Comment une fintech a donné à son équipe commerciale un pipeline fiable en éliminant 4 000+ doublons avec Dedupely
- HubSpot
- Des années de données héritées
- Services financiers

- 2,158 correspondances d'entreprises fusionnées en moins de 7 semaines
- 1,852 correspondances de deals fusionnées en moins de 7 semaines
- 12 recherches sur Auto Merge
Une correspondance est un ensemble d'enregistrements en double fusionnés en un seul enregistrement. Chaque correspondance contient au moins deux enregistrements, et beaucoup en contenaient trois ou plus, donc le nombre d'enregistrements fusionnés est plus que le double du nombre de correspondances.
D'où venaient les doublons
Une société, deux champs de site web, et un deal par doublon
L'entreprise est une fintech qui gère son pipeline de ventes dans HubSpot, avec plus de 500 000 enregistrements et quelques milliers de transactions. Le gestionnaire RevOps avait utilisé Dedupely quelques années plus tôt, l'avait abandonné, et est revenu avec ce qu'il décrivait comme un gros problème de doublon au niveau de l'entreprise et de la transaction. Il avait déjà construit ses propres recherches et règles de fusion, et les doublons passaient toujours.
Trois éléments ont créé des doublons :
- Le site web était présent en deux endroits. Certains enregistrements de sociétés ont stocké cela dans le champ domaine, d'autres dans le champ site Web. Une recherche sur un seul champ a manqué les doublons cachés dans l'autre.
- Les fusions d'entreprises ont créé des doublons d'opportunités. Quand deux sociétés fusionnaient, chacune apportait ses deals, si bien que la société survivante avait deux deals dans le même pipeline. Chaque nettoyage de sociétés créait un nouveau nettoyage de deals.
- Les enregistrements ne doivent pas tous correspondre. Entreprises Créés à partir de domaines Gmail ou Yahoo, et les sociétés filiales devaient rester hors fusion, sinon les mauvais enregistrements se combineraient.
Problèmes causés par les doublons
Une chasse hebdomadaire aux fiches qui auraient dû être fusionnées
Quand il est revenu, il a dit que les doublons causaient le chaos. Presque chaque semaine il trouverait des fiches qui auraient dû se fusionner et ne l'avaient pas fait, et se demandait pourquoi il y avait toujours autant de doublons.
Côté deals, une entreprise fusionnée pouvait se retrouver avec deux deals pour le même client dans le même pipeline, et quelqu'un devait les trouver et les fusionner manuellement. L'équipe avait déjà décidé quels stages de deal devaient survivre à une fusion, avec des stages comme Lost ou Bad lead configurés pour disparaître.
Pourquoi les règles trop permissives étaient risquées
La correspondance sur trop peu de critères était risquée à cette échelle. Au début, une recherche automatisée d'entreprises a fusionné deux entreprises dont les domaines correspondaient sauf pour l'extension. Domain Root ignore intentionnellement www, .com et les variantes de pays, donc la recherche a fait exactement ce pour quoi elle a été configurée. Il ne s'inquiétait pas pour cette paire, mais il a mis en pause la recherche Auto Merge et ajouté une deuxième vérification pour que deux sociétés vraiment différentes ne puissent pas fusionner de la même façon.
Chercher sur trop de champs a plutôt manqué les vrais doublons. Une recherche exigeant à la fois le domaine et le champ site web aurait ignoré les paires où un enregistrement laissait le site vierge, car les valeurs vides ne comptent pas comme correspondance.
Comment les doublons ont été résolus
-
1. Ajoutez les champs nécessaires à la recherche
Le premier correctif a été d'apporter les bons champs. Avec l'équipe de succès client de Dedupely, il a ajouté le deuxième champ de site web aux recherches d'entreprises, et le nom et le site web de l'entreprise associée aux recherches d'offres, puis a attendu la resynchronisation pour que les nouveaux champs apparaissent dans les résultats. Chaque fusion que Dedupely effectue est également enregistrée dans Merge History, que l'équipe a exportée comme sauvegarde CSV.
-
2. Associer les entreprises par domaine, avec garde-fous
Les recherches d'entreprises correspondent sur Domain Root, qui compare le domaine principal et ignore www, .com et les variantes de pays. Pour maintenir les différentes entreprises séparées, il a ajouté un deuxième champ, le pays ou la région, pour qu'une correspondance nécessite le même domaine et le même pays.
Les filtres éliminent les mauvais enregistrements avant la recherche de correspondances. Un filtre exclut les sociétés avec des domaines de messagerie personnels comme Gmail, Yahoo et Proton. Un autre écarte celles ayant une société mère. Plus de champs de correspondance donnent moins de résultats, mais plus fiables.
-
3. Donnez aux transactions leur propre recherche et leurs propres règles
Transactions Correspondez sur la société et le pipeline, afin que deux contrats ne fusionnent que s'ils appartiennent au même client dans le même pipeline.
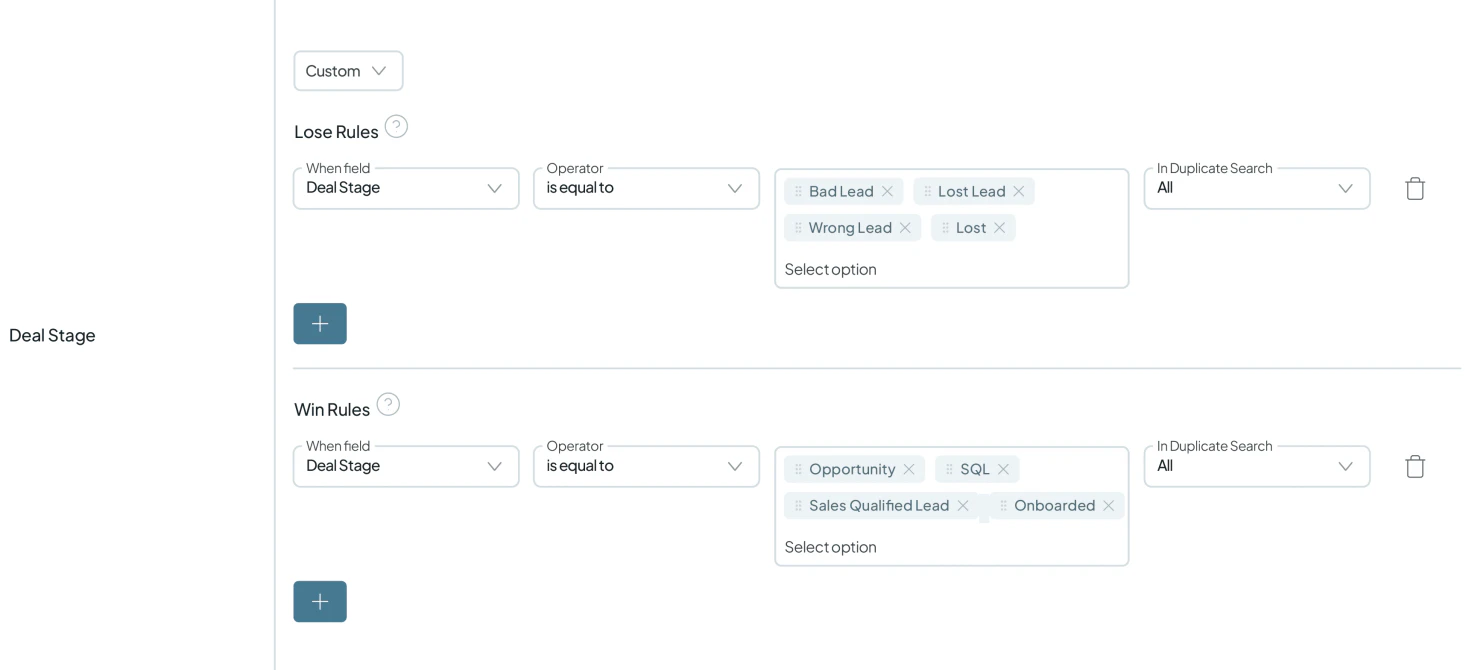
Merge Rules décidez ce qui survit. Pour les deals, le Primary Record est le plus ancien, donc une fusion conserve toujours le deal créé en premier. Sur l'étape du deal, les Lose Rules créent des étapes comme Leads, Les leads mauvais et Perdus perdent, et les Règles Win favorisent les étapes montrant une progression réelle, comme les leads qualifiés, les opportunités et les clients embarqués. Les Règles Lose s'exécutent toujours avant les Règles Win et les champs vides ne remplacent jamais les données existantes.
-
4. Automatisez selon un calendrier, puis gardez un œil dessus
Il a activé Auto Merge, qui fusionne les nouveaux doublons selon un calendrier en utilisant les critères de recherche et les Merge Rules. Les recherches de sociétés s'exécutent désormais quotidiennement, et les recherches de contrats à des jours définis. Il prévoit d'examiner attentivement les résultats avant d'activer Auto Merge.
Rejeter les correspondances a rendu cela plus sûr. Quand une paire n'est pas un vrai doublon, il la rejette, et elle est retirée des recherches actuelles et futures, pour qu'elle ne soit jamais fusionnée par erreur.
Ce que la déduplication a changé
Des recherches qui s'exécutent d'elles-mêmes
En quelques semaines, il fusionnait tellement qu'il avait arrêté de compter. Peu après, sa principale recherche d'entreprise automatisée faisait son travail, détectant la plupart des doublons et signalant occasionnellement un cas difficile, alors il l'a laissée s'exécuter. Une ancienne recherche ponctuelle ne retournait plus rien, probablement parce que ses doublons avaient déjà été fusionnés.
Les chiffres le confirment. En moins de 7 semaines, l'équipe a fusionné 2 158 correspondances d'entreprises et 1 852 correspondances de transactions, beaucoup contenant trois enregistrements ou plus dans une seule correspondance. Douze recherches s'exécutent maintenant sur Auto Merge, et les nouveaux doublons entre les entreprises et les transactions fusionnent selon un calendrier plutôt que d'attendre quelqu'un pour les repérer.
Un outil que l'équipe n'a cessé d'améliorer
Il a décrit Dedupely comme faisant un excellent travail de dédoublonnage de leurs enregistrements, et l'équipe a continué à développer la configuration : des recherches séparées pour les entreprises et les transactions, des Merge Rules pour chaque objet, et des filtres qui excluent les mauvais enregistrements.
Associé

- Cas client 140,000+ enregistrements en doublons fusionnésSalesforce Santé
Comment une Entreprise Santé a Éliminé les Doublons Répétés dans HubSpot et Salesforce avec Dedupely
Lire l'histoire - Cas client 58,000+ enregistrements en doublons fusionnésPipedrive SaaS
Comment une entreprise SaaS a fusionné 58 000+ fiches Pipedrive en doublon créées par sa migration depuis HubSpot, avec Dedupely
Lire l'histoire - Cas client 20,000+ enregistrements en doublons fusionnésPipedrive SaaS
Comment une entreprise de réponse téléphonique IA a arrêté la vérification manuelle de Pipedrive et fusionné 20 000+ doublons avec Dedupely
Lire l'histoire














