


TL;DR
- Os CRMs deixam passar duplicados porque as ferramentas nativas comparam alguns campos definidos, muitas vezes valor por valor.
- Erros de digitação, apelidos, formatos de telefone e sufixos de empresa fazem um registro parecer dois.
- Registros sem e-mail ou domínio costumam ficar fora da detecção nativa por completo.
- Testar as ferramentas nativas em duplicados que você já conhece mostra o que elas deixam passar.
- A Dedupely encontra duplicados em qualquer campo, inclusive campos personalizados, e mescla correspondências inteiras.
Seu CRM deixa passar duplicados porque as ferramentas dele procuram de um jeito restrito. Elas comparam alguns campos definidos, muitas vezes valor por valor, e exigem que esses campos estejam preenchidos.
Duplicados reais raramente se alinham tão bem. Um registro diz "Bob", o outro "Robert". Um tem um e-mail de trabalho, o outro um pessoal. Uma empresa termina em "Inc." e a outra não. Para uma pessoa, são a mesma coisa, e para uma verificação em um só campo exato, são dois registros.
Neste post, você verá o que a detecção nativa procura em alguns CRMs e quais duplicados ela deixa passar. Também verá como descobrir o que a sua está deixando escapar. Se as ferramentas nativas bastam para a sua equipe é outra questão, tratada em quando as ferramentas de deduplicação nativas do seu CRM bastam.
O que a detecção nativa de duplicados procura
Cada CRM traça suas próprias linhas. Eis o que os CRMs com os quais a Dedupely trabalha dizem nas suas páginas de ajuda, em outubro de 2026.
HubSpot
O HubSpot deduplica contatos automaticamente pelo endereço de e-mail e empresas pelo nome de domínio, conforme sua página de ajuda sobre deduplicação. As importações também podem comparar registros pelo ID de Registro, e cada objeto pode ter até dez propriedades personalizadas que exigem valores únicos.
Para duplicados existentes, sua ferramenta de gestão de duplicados cobre contatos e empresas nas assinaturas Professional e Enterprise. Compara um conjunto padrão de propriedades todo dia, como nome, e-mail, telefone e nome da empresa para contatos. Regras personalizadas de duplicados exigem Data Hub Professional ou Enterprise.
Salesforce
Salesforce regra padrão de correspondência de contas compara nome da conta, rua de cobrança, cidade, CEP, telefone e site. Nome, rua e cidade podem usar distância de edição além da correspondência exata, enquanto CEP, telefone e site são exatos.
Para encontrar duplicados que já existem, trabalhos de duplicados rode uma regra de correspondência em contas, contatos ou leads. Elas estão disponíveis nas edições Performance e Unlimited.
Pipedrive
do Pipedrive recurso de mesclagem de duplicados sugere pessoas com o mesmo nome mais o mesmo telefone, e-mail ou organização. Sugere organizações com o mesmo nome e o mesmo endereço.
Fechar
do Close ferramentas de duplicados comparam leads pelo nome do lead, telefone ou e-mail em toda a conta. Comparam contatos pelo nome, telefone ou e-mail do contato, mas só dentro do mesmo lead.
Nimble
do Nimble Find/Merge Duplicates começa a partir de um contato que você suspeita ter um duplicado. A página de ajuda não diz quais campos ele compara. As importações comparam contatos por e-mail, ou por nome e sobrenome quando o e-mail não bate.
Google Contacts
O Google Contacts mostra sugestões de duplicados em Merge & fix, e você escolhe quais mesclar. A página de ajuda não diz o que ele compara, e contatos salvos em contas diferentes do Google não podem ser mesclados.
| CRM | O que a detecção nativa compara (em outubro de 2026) | Objetos cobertos |
|---|---|---|
| HubSpot | E-mail (contatos) e nome de domínio da empresa (empresas) automaticamente; um conjunto de propriedades padrão na ferramenta de gestão de duplicados | Contatos e empresas na ferramenta de gestão de duplicados |
| Salesforce | Os campos de cada regra de correspondência; a regra padrão de contas usa nome, endereço, telefone e site | Contas, contatos e leads em trabalhos de duplicados |
| Pipedrive | Nome mais telefone, e-mail ou organização (pessoas); nome mais endereço (organizações) | Pessoas e organizações |
| Fechar | Nome, telefone ou e-mail (leads na conta inteira; contatos dentro de um lead) | Leads, e contatos dentro de um lead |
| Nimble | Não informado para Find/Merge Duplicates; importações correspondem por e-mail, depois por nome e sobrenome | Contatos |
| Google Contacts | Não informado; sugestões em Merge & fix | Contatos em uma mesma conta do Google |
Essas ferramentas funcionam bem para os duplicados para os quais foram feitas. As lacunas aparecem nos duplicados que não se encaixam nesses padrões.
Os duplicados que as ferramentas nativas costumam deixar passar
A maioria dos duplicados perdidos cai em alguns tipos. Muitos CRMs têm vários deles ao mesmo tempo.
Valores que diferem por um erro de digitação ou formato
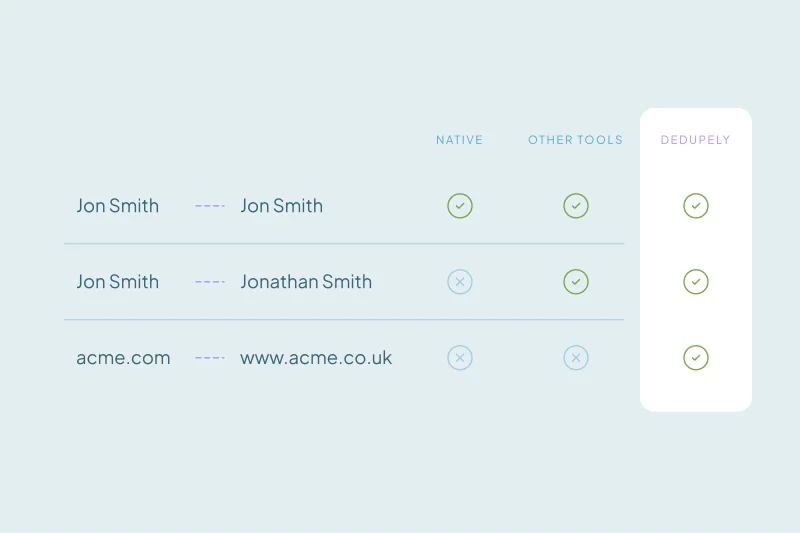
"jon.smith@" e "john.smith@" diferem por uma letra. "+1 (555) 010-2030" e "555 010 2030" são o mesmo número em dois formatos. Uma verificação que compara valores exatamente lê cada par como dois registros diferentes.
Apelidos e variantes de grafia
Robert e Bob, Katherine e Kathy, Sean e Shawn. Nomes que parecem diferentes ou soam parecido raramente batem numa verificação caractere por caractere, e o nome costuma ser o único campo que dois registros têm em comum.
Sufixos de empresa e ordem das palavras
"Acme Inc.", "ACME" e "Acme Incorporated" são uma empresa só para quem lê. Uma verificação de nome que compara o valor inteiro vê três. Como os sufixos de empresa escondem duplicados trata deste caso em detalhes.
Registros com o campo-chave em branco
Quando a detecção depende de e-mail ou domínio, registros sem eles ficam de fora. Um contato vindo de um app de telefone pode ter só um número, e uma empresa de uma lista pode não ter site. Como diz a página de ajuda do HubSpot, linhas importadas sem um valor único, como e-mail ou domínio, entram como registros novos. Nosso post sobre encontrar duplicados sem e-mail trata do que comparar no lugar.
Dois e-mails para uma pessoa
Um endereço de trabalho e um pessoal nunca batem entre si. Quando o e-mail é o campo que decide, a mesma pessoa com dois endereços continua como dois contatos.
Campos que a ferramenta não compara
As ferramentas nativas comparam o próprio conjunto de campos. Seu melhor sinal pode estar em outro lugar, como um número de cliente, um ID fiscal, uma URL do LinkedIn ou outro campo personalizado. Se a ferramenta não consegue usá-lo, esses duplicados continuam escondidos.
Duplicados que precisam de vários campos para aparecer
Alguns duplicados só aparecem quando dois ou três campos fracos coincidem, como sobrenome, telefone e cidade. Uma verificação em um campo forte os deixa passar, e uma verificação frouxa em um campo fraco junta desconhecidos.
Objetos fora do alcance da ferramenta
A detecção nativa costuma focar em contatos e empresas, ou em contas, contatos e leads. Negócios, tickets, produtos e objetos personalizados duplicados precisam de outra forma de serem encontrados.
Mesmo os duplicados que um CRM encontra podem continuar no lugar, já que a mesclagem nativa trabalha com poucos registros de cada vez. Quando as ferramentas de deduplicação do CRM chegam trata de onde a mesclagem e outros limites nativos começam a importar.
Como descobrir o que o seu CRM está deixando passar
Você não precisa adivinhar. Um teste curto mostra onde suas ferramentas nativas param.
- Reúna os duplicados conhecidos. Anote dez ou vinte conjuntos que você sabe que são duplicados, de tipos diferentes: um erro de digitação, um apelido, um sufixo, um e-mail em branco.
- Veja quais a detecção nativa encontra. Os conjuntos ignorados mostram quais tipos ele não consegue ver.
- Olhe um segundo campo. Ordene contatos por telefone ou empresas por nome, e procure vizinhos que diferem em e-mail ou domínio.
- Conte os registros sem o campo-chave. Contatos sem e-mail e empresas sem domínio costumam ficar fora da detecção nativa.
- Confira seus outros objetos. Procure nomes de negócios ou tickets repetidos no mesmo contato.
O que conta como duplicado depende do caso, então defina suas próprias regras antes de contar. Dois escritórios de uma mesma empresa podem ser um registro para marketing e dois para vendas. Deduplicação nativa vs. ferramentas de deduplicação compara as opções quando você souber o que está faltando.
Como a Dedupely encontra os duplicados que o seu CRM deixa passar
A Dedupely Intelligence é uma correspondência com IA que encontra padrões complexos de duplicados sem nenhuma opção de correspondência, e encontra 10x mais duplicados do que a conferência à mão. Você também pode criar pesquisas de duplicados em qualquer campo, inclusive campos personalizados. Para cada campo, escolhe-se como ele compara: exatamente, aceitando erros de digitação, por som, por apelido, por palavras compartilhadas ou pelo domínio principal. Ao mesclar, a Dedupely mescla cada registro de uma correspondência em uma única ação.
Seu CRM encontra os duplicados para os quais foi feito
A detecção nativa é feita para o caso comum: o mesmo e-mail, o mesmo domínio, o mesmo nome e endereço. Ela cumpre esse papel, mas dados reais nem sempre colaboram.
Erros de digitação, apelidos, sufixos, e-mails ausentes e campos personalizados são onde os duplicados se escondem. Testar suas ferramentas com duplicados que você já conhece mostra quais deles o seu CRM não consegue ver, e isso indica onde procurar a seguir.
Perguntas frequentes
Por que meu CRM não encontra todos os meus duplicados?
Porque a detecção nativa compara um conjunto de campos, muitas vezes valor por valor, e exige que eles estejam preenchidos. Duplicados que diferem por um erro de digitação, um apelido, um formato de telefone, um sufixo de empresa ou um segundo e-mail não batem nesses campos. Registros sem e-mail ou domínio costumam ser ignorados por completo.
Um CRM consegue encontrar duplicados com e-mails diferentes?
Geralmente não só por e-mail, já que um endereço de trabalho e um pessoal nunca coincidem. Algumas ferramentas nativas comparam outros campos também, como nome, telefone ou empresa. Para encontrá-los, compare por nome mais telefone ou nome mais empresa, e confira os resultados antes de mesclar.
A deduplicação nativa usa correspondência aproximada?
Depende do CRM. A regra padrão de correspondência de contas do Salesforce pode comparar nome, rua e cidade por distância de edição, em outubro de 2026. Muitas verificações nativas, como as de e-mail e domínio, comparam valores exatamente, então pequenos erros de digitação e diferenças de formato passam.
Por que meu CRM não encontra empresas duplicadas?
Nomes de empresas variam muito: "Inc.", "Ltda.", abreviações e a ordem das palavras mudam o valor. A detecção por domínio deixa passar empresas sem site ou com dois domínios. Comparar pelo domínio principal mais um nome de empresa que ignore sufixos pega muitas delas.
As ferramentas nativas conseguem encontrar duplicados em campos personalizados?
Alguns podem, dentro de limites. O HubSpot permite que cada objeto tenha até dez propriedades personalizadas que exigem valores únicos. No Salesforce, as regras por trás de um trabalho de duplicados decidem quais campos ele compara. Confira as páginas de ajuda do seu CRM para saber quais campos e objetos a detecção dele pode usar.


 Ou cadastre-se com o Google

 Pipedrive Marketplace












