


TL;DR
- CRMs übersehen Dubletten, weil native Tools einige feste Felder vergleichen, oft Wert für Wert.
- Tippfehler, Spitznamen, Telefonformate und Firmenzusätze lassen einen Datensatz wie zwei aussehen.
- Datensätze ohne E-Mail oder Domain werden von der nativen Erkennung oft ganz übersprungen.
- Das Testen nativer Tools an Dubletten, die Sie bereits kennen, zeigt, was sie übersehen.
- Dedupely findet Dubletten über jedes Feld, auch benutzerdefinierte Felder, und mergt ganze Treffer.
Ihr CRM übersieht Dubletten, weil seine eigenen Tools auf eng gefasste Weise suchen. Sie vergleichen einige Felder, oft Wert für Wert, und brauchen diese Felder ausgefüllt.
Echte Dubletten passen selten so sauber zusammen. Ein Datensatz sagt "Bob", der andere "Robert". Einer hat eine geschäftliche E-Mail, der andere eine private. Eine Firma endet auf "Inc.", die andere nicht. Für einen Menschen sind sie dieselben, bei einer Prüfung auf ein exaktes Feld sind es zwei Datensätze.
In diesem Beitrag sehen Sie, wonach die native Erkennung in einigen CRMs sucht und welche Dubletten an ihr vorbeirutschen. Sie sehen außerdem, wie Sie herausfinden, was Ihrem CRM fehlt. Ob die nativen Tools für Ihr Team reichen, ist eine eigene Frage, behandelt in wann die eigenen Dublettentools Ihres CRM ausreichen.
Was die native Dublettenerkennung prüft
Jedes CRM zieht seine eigenen Grenzen. Hier steht, was die CRMs, mit denen Dedupely arbeitet, auf ihren Hilfeseiten sagen, Stand Oktober 2026.
HubSpot
HubSpot dedupliziert Kontakte automatisch nach E-Mail-Adresse und Firmen nach Firmen-Domain, gemäß seiner Hilfeseite zur Deduplizierung. Importe können Datensätze auch über die Datensatz-ID abgleichen, und jedes Objekt kann bis zu zehn benutzerdefinierte Eigenschaften haben, die eindeutige Werte verlangen.
Für bestehende Dubletten ihre Dublettenmanagement-Tool deckt Kontakte und Firmen in den Abonnements Professional und Enterprise ab. Es vergleicht täglich einen Standardsatz an Eigenschaften, etwa Name, E-Mail, Telefon und Firmenname bei Kontakten. Benutzerdefinierte Dublettenregeln brauchen Data Hub Professional oder Enterprise.
Salesforce
Salesforce Standardregel für Konten vergleicht Kontoname, Rechnungsstraße, Ort, PLZ, Telefon und Website. Name, Straße und Ort können neben exaktem auch Edit-Distanz nutzen, während PLZ, Telefon und Website exakt sind.
Um bereits bestehende Dubletten zu finden, Dublettenaufträge eine Abgleichregel über Konten, Kontakte oder Leads laufen lassen. Sie sind in Performance und Unlimited Editions verfügbar.
Pipedrive
Pipedrives Feature Merge Duplicates schlägt Personen mit demselben Namen plus derselben Telefonnummer, E-Mail oder Organisation vor. Es schlägt Organisationen mit demselben Namen und derselben Adresse vor.
Schließen
von Close Dublettentools gleichen Leads über Lead-Name, Telefonnummer oder E-Mail-Adresse im gesamten Konto ab. Kontakte gleichen sie über Kontaktname, Telefon oder E-Mail ab, aber nur innerhalb desselben Leads.
Nimble
Nimbles Find/Merge Duplicates beginnt bei einem Kontakt, bei dem Sie eine Dublette vermuten. Die Hilfeseite sagt nicht, welche Felder verglichen werden. Importe gleichen Kontakte per E-Mail ab oder über Vor- und Nachname, wenn die E-Mail nicht passt.
Google Contacts
Google Contacts zeigt Dublettenvorschläge unter Merge & fix, und Sie wählen, welche Sie mergen. Die Hilfeseite sagt nicht, was verglichen wird, und Kontakte in unterschiedlichen Google-Konten können nicht gemergt werden.
| CRM | Was die native Erkennung vergleicht (Stand Oktober 2026) | Abgedeckte Objekte |
|---|---|---|
| HubSpot | E-Mail (Kontakte) und Firmen-Domain (Firmen) automatisch; ein Standardeigenschaftssatz im Dublettenmanagement-Tool | Kontakte und Firmen im Dublettenmanagement-Tool |
| Salesforce | Die Felder jeder Abgleichregel; die Standardregel für Konten nutzt Name, Adresse, Telefon und Website | Konten, Kontakte und Leads in Dublettenaufträgen |
| Pipedrive | Name plus Telefon, E-Mail oder Organisation (Personen); Name plus Adresse (Organisationen) | Personen und Organisationen |
| Schließen | Name, Telefon oder E-Mail (Leads im gesamten Konto; Kontakte innerhalb eines Leads) | Leads und Kontakte innerhalb eines Leads |
| Nimble | Nicht angegeben für Find/Merge Duplicates; Importe gleichen nach E-Mail, dann Vor- und Nachname ab | Kontakte |
| Google Contacts | Nicht angegeben; Vorschläge unter Merge & fix | Kontakte in einem Google-Konto |
Diese Tools funktionieren gut für die Dubletten, für die sie gebaut wurden. Die Lücken zeigen sich bei den Dubletten, die nicht in diese Muster passen.
Die Dubletten, die native Tools meist übersehen
Die meisten übersehenen Dubletten fallen in eine Handvoll Typen. Viele CRMs haben mehrere davon gleichzeitig.
Werte, die sich durch einen Tippfehler oder ein Format unterscheiden
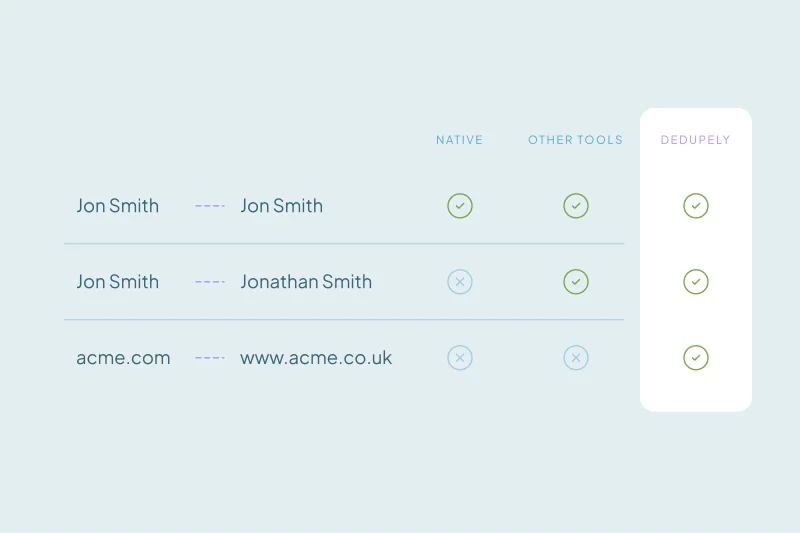
"jon.smith@" und "john.smith@" unterscheiden sich um einen Buchstaben. "+1 (555) 010-2030" und "555 010 2030" sind dieselbe Nummer in zwei Formaten. Eine Prüfung, die Werte exakt vergleicht, liest jedes Paar als zwei verschiedene Datensätze.
Spitznamen und Schreibvarianten
Robert und Bob, Katherine und Kathy, Sean und Shawn. Namen, die anders aussehen oder ähnlich klingen, passen bei einer Prüfung Zeichen für Zeichen selten, und ein Name ist oft das einzige Feld, das zwei Datensätze gemeinsam haben.
Firmenzusätze und Wortstellung
"Acme Inc.", "ACME" und "Acme Incorporated" sind für jeden Leser dieselbe Firma. Eine Namensprüfung, die den ganzen Wert vergleicht, sieht drei. Wie Firmenzusätze Dubletten verbergen behandelt diesen Fall ausführlich.
Datensätze mit fehlendem Schlüsselfeld
Wenn die Erkennung auf E-Mail oder Domain beruht, bleiben Datensätze ohne eines davon außen vor. Ein Kontakt aus einer Telefon-App hat womöglich nur eine Nummer, und eine Firma aus einer Liste hat womöglich keine Website. Wie es auf der Hilfeseite von HubSpot heißt, kommen Zeilen ohne eindeutigen Wert wie E-Mail oder Domain als neue Datensätze herein. Unser Beitrag zu Dubletten ohne E-Mail finden beschreibt, worauf Sie stattdessen abgleichen sollten.
Zwei E-Mails für eine Person
Eine geschäftliche und eine private Adresse passen nie zueinander. Wenn E-Mail das entscheidende Feld ist, bleibt dieselbe Person mit zwei Adressen als zwei Kontakte bestehen.
Felder, die das Tool nicht vergleicht
Native Tools vergleichen ihre eigene Gruppe von Feldern. Ihr bestes Signal liegt womöglich anderswo, etwa in einer Kundennummer, einer Steuer-ID, einer LinkedIn-URL oder einem anderen benutzerdefinierten Feld. Kann das Tool es nicht nutzen, bleiben diese Dubletten verborgen.
Dubletten, die mehrere Felder brauchen, um sichtbar zu werden
Manche Dubletten erscheinen erst, wenn zwei oder drei schwächere Felder übereinstimmen, etwa Nachname, Telefon und Ort. Eine Prüfung auf ein starkes Feld übersieht sie, und eine lockere Prüfung auf ein schwaches Feld paart Fremde.
Objekte außerhalb der Reichweite des Tools
Die native Erkennung konzentriert sich oft auf Kontakte und Firmen oder auf Konten, Kontakte und Leads. Doppelte Deals, Tickets, Produkte und benutzerdefinierte Objekte brauchen einen anderen Weg, um gefunden zu werden.
Selbst die Dubletten, die ein CRM findet, können bleiben, da das native Mergen nur wenige Datensätze auf einmal bearbeitet. Wann die eigenen Deduplizierungstools Ihres CRMs ausreichen beschreibt, wo das Mergen und andere native Grenzen relevant werden.
So finden Sie heraus, was Ihrem CRM fehlt
Sie müssen nicht raten. Ein kurzer Test zeigt, wo Ihre nativen Tools aufhören.
- Sammeln Sie bekannte Dubletten. Notieren Sie zehn oder zwanzig Sets, von denen Sie wissen, dass es Dubletten sind, verschiedener Typen: ein Tippfehler, ein Spitzname, ein Zusatz, eine fehlende E-Mail.
- Sehen Sie, welche die native Erkennung findet. Die übersprungenen Sets zeigen Ihnen, welche Typen es nicht sehen kann.
- Sehen Sie sich ein zweites Feld an. Sortieren Sie Kontakte nach Telefon oder Firmen nach Name und suchen Sie nach Nachbarn, die sich in E-Mail oder Domain unterscheiden.
- Zählen Sie die Datensätze ohne das Schlüsselfeld. Kontakte ohne E-Mail und Firmen ohne Domain liegen oft außerhalb der nativen Erkennung.
- Prüfen Sie Ihre anderen Objekte. Suchen Sie nach wiederholten Deal-Namen oder Tickets am selben Kontakt.
Was als Dublette gilt, entscheidet sich im Einzelfall, legen Sie daher Ihre eigenen Regeln fest, bevor Sie zählen. Zwei Büros einer Firma können für das Marketing ein Datensatz und für den Vertrieb zwei sein. Native Dublettenerkennung vs. Deduplizierungstools vergleicht die Optionen, sobald Sie wissen, was fehlt.
Wie Dedupely die Dubletten findet, die Ihr CRM übersieht
Dedupely Intelligence ist KI-gestützter Abgleich, der komplexe Dublettenmuster ohne jede Match-Einstellung findet und dabei 10x mehr Dubletten findet als eine Prüfung von Hand. Sie können Duplikatsuchen auch auf beliebigen Feldern aufbauen, einschließlich benutzerdefinierter Felder. Für jedes Feld wählen Sie, wie es abgleicht: exakt, mit Tippfehlertoleranz, nach Klang, nach Spitzname, nach gemeinsamen Wörtern oder nach Kern-Domain. Beim Mergen führt Dedupely jeden Datensatz eines Treffers in einer Aktion zusammen.
Ihr CRM findet die Dubletten, für die es gebaut wurde
Die native Erkennung ist für den häufigen Fall gebaut: dieselbe E-Mail, dieselbe Domain, derselbe Name und dieselbe Adresse. Sie erledigt diese Aufgabe, aber echte Daten spielen nicht immer mit.
Tippfehler, Spitznamen, Suffixe, fehlende E-Mails und benutzerdefinierte Felder sind die Orte, an denen sich Dubletten verstecken. Wenn Sie Ihre Tools an Dubletten testen, die Sie bereits kennen, zeigt das, welche davon Ihr CRM nicht sieht, und das sagt Ihnen, wo Sie als Nächstes suchen sollten.
Häufige Fragen
Warum findet mein CRM nicht alle meine Dubletten?
Weil die native Erkennung eine Reihe von Feldern vergleicht, oft Wert für Wert, und diese ausgefüllt sein müssen. Dubletten, die sich durch einen Tippfehler, einen Spitznamen, ein Telefonformat, einen Firmenzusatz oder eine zweite E-Mail unterscheiden, stimmen bei diesen Feldern nicht überein. Datensätze ohne E-Mail oder Domain werden oft ganz übersprungen.
Kann ein CRM Dubletten mit verschiedenen E-Mail-Adressen finden?
In der Regel nicht allein über die E-Mail, da sich eine geschäftliche und eine private Adresse nie decken. Manche nativen Tools vergleichen auch andere Felder, etwa Name, Telefon oder Firma. Um diese zu finden, gleichen Sie Name plus Telefon oder Name plus Firma ab und prüfen die Ergebnisse vor dem Merge.
Verwendet die native Deduplizierung unscharfen Abgleich?
Das hängt vom CRM ab. Die Standardregel für Konten in Salesforce kann Name, Straße und Ort per Edit-Distanz vergleichen, Stand Oktober 2026. Viele native Prüfungen, etwa über E-Mail und Domain, vergleichen Werte exakt, daher kommen kleine Tippfehler und Formatunterschiede durch.
Warum übersieht mein CRM doppelte Firmen?
Firmennamen variieren stark: "Inc.", "LLC", Abkürzungen und Wortstellung verändern den Wert. Erkennung über die Domain übersieht Firmen ohne Website oder mit zwei Domains. Der Abgleich über die Kern-Domain plus einen Firmennamen ohne Zusätze findet viele davon.
Können native Tools Dubletten in benutzerdefinierten Feldern finden?
Manche können das, innerhalb von Grenzen. HubSpot erlaubt jedem Objekt bis zu zehn benutzerdefinierte Eigenschaften, die eindeutige Werte verlangen. In Salesforce bestimmen die Regeln hinter einem Dublettenlauf, welche Felder er vergleicht. Prüfen Sie in den Hilfeseiten Ihres CRM, welche Felder und Objekte die Erkennung nutzen kann.


 Oder mit Google registrieren

 Pipedrive Marketplace












