


Résumé
- Les CRM manquent des doublons parce que les outils natifs comparent quelques champs définis, souvent valeur pour valeur.
- Les fautes de frappe, surnoms, formats de téléphone et suffixes d'entreprise font qu'une fiche ressemble à deux.
- Les fiches sans e-mail ni domaine échappent souvent complètement à la détection native.
- Tester les outils natifs sur des doublons que vous connaissez déjà montre ce qu'ils manquent.
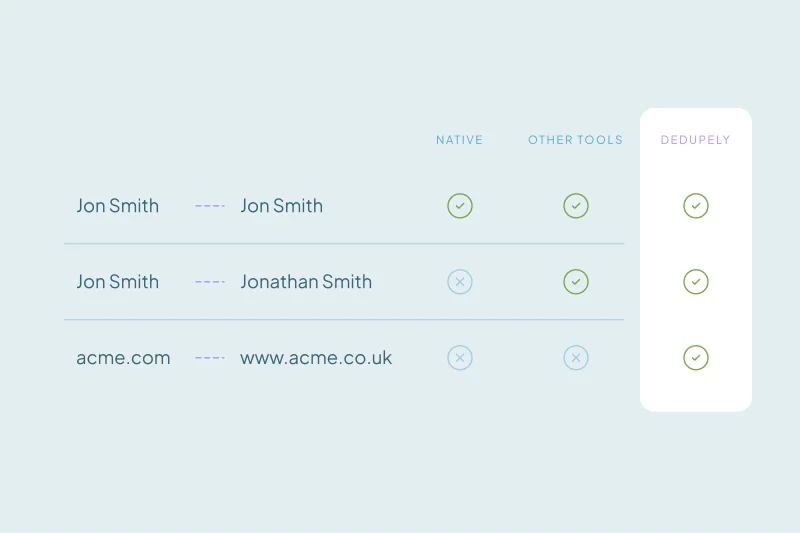
- Dedupely trouve les doublons sur n'importe quel champ, champs personnalisés compris, et fusionne des correspondances entières.
Votre CRM manque des doublons parce que ses propres outils les cherchent de manière étroite. Ils comparent quelques champs définis, souvent valeur pour valeur, et ils exigent que ces champs soient renseignés.
Les vrais doublons s'alignent rarement aussi proprement. Une fiche dit « Bob », l'autre « Robert ». L'une a une adresse professionnelle, l'autre une adresse personnelle. Une entreprise se termine par « Inc. » et l'autre non. Pour une personne, ce sont les mêmes, et pour une vérification sur un seul champ exact, ce sont deux fiches.
Dans cet article, vous verrez ce que la détection native recherche dans quelques CRM et quels doublons lui échappent. Vous verrez aussi comment découvrir ce que le vôtre manque. Savoir si les outils natifs suffisent à votre équipe est une autre question, traitée dans quand les outils de déduplication propres à votre CRM suffisent.
Ce que la détection native des doublons recherche
Chaque CRM trace ses propres limites. Voici ce que disent les CRM avec lesquels Dedupely travaille sur leurs pages d'aide, en octobre 2026.
HubSpot
HubSpot déduplique les contacts par adresse e-mail et les entreprises par nom de domaine automatiquement, selon sa page d'aide sur la déduplication. Les imports peuvent aussi faire correspondre les fiches par Record ID, et chaque objet peut avoir jusqu'à dix propriétés personnalisées qui exigent des valeurs uniques.
Pour les doublons existants, son outil de gestion des doublons couvre les contacts et les entreprises des abonnements Professional et Enterprise. Il compare chaque jour un jeu de propriétés par défaut, comme le nom, l'e-mail, le téléphone et le nom d'entreprise pour les contacts. Les règles de doublons personnalisées demandent Data Hub Professional ou Enterprise.
Salesforce
Salesforce règle standard de correspondance des comptes compare le nom du compte, la rue de facturation, la ville, le code postal, le téléphone et le site web. Le nom, la rue et la ville peuvent utiliser la distance d'édition en plus de la correspondance exacte, tandis que le code postal, le téléphone et le site web sont exacts.
Pour trouver les doublons qui existent déjà, tâches de doublons exécuter une règle de correspondance sur les comptes, contacts ou pistes. Elles sont disponibles dans les éditions Performance et Unlimited.
Pipedrive
de Pipedrive fonctionnalité de fusion des doublons suggère des personnes ayant le même nom plus le même téléphone, e-mail ou organisation. Il suggère des organisations ayant le même nom et la même adresse.
Fermer
de Close outils de déduplication font correspondre les pistes par nom de piste, numéro de téléphone ou adresse e-mail dans tout le compte. Elles font correspondre les contacts par nom, téléphone ou e-mail, mais seulement au sein d'une même piste.
Nimble
de Nimble Find/Merge Duplicates part d'un contact dont vous soupçonnez qu'il a un doublon. La page d'aide ne dit pas quels champs il compare. Les imports font correspondre les contacts par e-mail, ou par prénom et nom quand l'e-mail ne correspond pas.
Google Contacts
Google Contacts affiche les suggestions de doublons sous Merge & fix, et vous choisissez lesquels fusionner. La page d'aide ne précise pas ce qu'elle compare, et les contacts enregistrés dans des comptes Google différents ne peuvent pas être fusionnés.
| CRM | Ce que compare la détection native (en octobre 2026) | Objets couverts |
|---|---|---|
| HubSpot | E-mail (contacts) et nom de domaine de l'entreprise (entreprises) automatiquement ; un jeu de propriétés par défaut défini dans l'outil de gestion des doublons | Contacts et entreprises dans l'outil de gestion des doublons |
| Salesforce | Les champs de chaque règle de correspondance ; la règle standard des comptes utilise le nom, l'adresse, le téléphone et le site web | Comptes, contacts et pistes dans les tâches de doublons |
| Pipedrive | Nom plus téléphone, e-mail ou organisation (personnes) ; nom plus adresse (organisations) | Personnes et organisations |
| Fermer | Nom, téléphone ou e-mail (pistes dans tout le compte ; contacts au sein d'une piste) | Pistes, et contacts au sein d'une piste |
| Nimble | Non précisé pour Find/Merge Duplicates ; les imports font correspondre sur l'e-mail, puis le prénom et le nom | Contacts |
| Google Contacts | Non précisé ; suggestions sous Merge & fix | Contacts dans un même compte Google |
Ces outils fonctionnent bien pour les doublons pour lesquels ils ont été conçus. Les lacunes apparaissent dans les doublons qui ne correspondent pas à ces schémas.
Les doublons que les outils natifs manquent en général
La plupart des doublons manqués entrent dans une poignée de types. Beaucoup de CRM en ont plusieurs à la fois.
Valeurs qui diffèrent par une faute de frappe ou un format
« jon.smith@ » et « john.smith@ » ne diffèrent que d'une lettre. « +1 (555) 010-2030 » et « 555 010 2030 » sont le même numéro dans deux formats. Une vérification qui compare les valeurs à l'identique lit chaque paire comme deux fiches différentes.
Surnoms et variantes d'orthographe
Robert et Bob, Katherine et Kathy, Sean et Shawn. Des noms qui s'écrivent différemment ou se prononcent de la même façon correspondent rarement à une vérification caractère par caractère, et le nom est souvent le seul champ que deux fiches partagent.
Suffixes d'entreprise et ordre des mots
« Acme Inc. », « ACME » et « Acme Incorporated » désignent une seule entreprise pour quiconque les lit. Une vérification de nom qui compare la valeur entière en voit trois. Comment les suffixes d'entreprise cachent les doublons traite ce cas en détail.
Fiches sans le champ clé
Quand la détection repose sur l'e-mail ou le domaine, les fiches sans l'un des deux sont laissées de côté. Un contact issu d'une application téléphonique n'a peut-être qu'un numéro, et une entreprise issue d'une liste peut n'avoir aucun site web. Comme le dit la page d'aide de HubSpot, les lignes importées sans valeur unique comme l'e-mail ou le domaine arrivent comme de nouvelles fiches. Notre article sur trouver des doublons sans e-mail explique plutôt sur quoi faire correspondre.
Deux e-mails pour une même personne
Une adresse professionnelle et une adresse personnelle ne correspondent jamais entre elles. Quand l'e-mail est le champ qui décide, la même personne avec deux adresses reste deux contacts.
Champs que l'outil ne compare pas
Les outils natifs comparent leur propre ensemble de champs. Votre meilleur signal se trouve peut-être ailleurs, comme un numéro de client, un identifiant fiscal, une URL LinkedIn ou un autre champ personnalisé. Si l'outil ne peut pas l'utiliser, ces doublons restent cachés.
Doublons qui ne se révèlent qu'avec plusieurs champs
Certains doublons n'apparaissent que lorsque deux ou trois champs plus faibles concordent, comme le nom de famille, le téléphone et la ville. Un contrôle sur un seul champ fort les manque, et un contrôle souple sur un seul champ faible associe des inconnus.
Objets hors de portée de l'outil
La détection native se concentre souvent sur les contacts et les entreprises, ou sur les comptes, contacts et pistes. Les affaires, tickets, produits et objets personnalisés en double demandent une autre façon d'être trouvés.
Même les doublons qu'un CRM trouve peuvent rester en place, car la fusion native ne traite que quelques fiches à la fois. Quand les outils de dédoublonnage de votre CRM suffisent explique à partir de quand la fusion et les autres limites natives commencent à compter.
Comment savoir ce que votre CRM manque
Pas besoin de deviner. Un court test montre où vos outils natifs s'arrêtent.
- Rassemblez les doublons connus. Notez dix ou vingt ensembles dont vous savez qu'ils sont des doublons, de types différents : une faute de frappe, un surnom, un suffixe, un e-mail manquant.
- Voyez lesquels la détection native trouve. Les ensembles ignorés indiquent les types qu'il ne peut pas voir.
- Regardez un second champ. Triez les contacts par téléphone ou les entreprises par nom, et repérez les voisins qui diffèrent par l'e-mail ou le domaine.
- Comptez les fiches sans le champ clé. Les contacts sans e-mail et les entreprises sans domaine échappent souvent à la détection native.
- Vérifiez vos autres objets. Recherchez des noms d'affaires ou des tickets répétés sur un même contact.
Ce qui compte comme doublon se décide au cas par cas, donc définissez vos propres règles avant de compter. Deux bureaux d'une même entreprise peuvent être une seule fiche pour le marketing et deux pour les ventes. Déduplication native ou outils de déduplication compare les options une fois que vous savez ce qui manque.
Comment Dedupely trouve les doublons que votre CRM manque
Dedupely Intelligence est une correspondance par IA qui trouve des schémas de doublons complexes sans aucun réglage de correspondance, et qui trouve 10x plus de doublons qu'une vérification à la main. Vous pouvez aussi construire des recherches de doublons sur n'importe quel champ, champs personnalisés compris. Pour chaque champ, vous choisissez sa correspondance : exacte, avec fautes de frappe, par son, par surnom, par mots communs ou par domaine principal. Lors d'une fusion, Dedupely fusionne chaque fiche d'une correspondance en une seule action.
Votre CRM trouve les doublons pour lesquels il a été conçu
La détection native est conçue pour le cas courant : le même e-mail, le même domaine, le même nom et la même adresse. Elle fait ce travail, et les données réelles ne coopèrent pas toujours.
Les fautes de frappe, surnoms, suffixes, e-mails manquants et champs personnalisés sont là où les doublons se cachent. Tester vos outils sur des doublons déjà connus montre ce que votre CRM ne voit pas, et indique où chercher ensuite.
Questions fréquentes
Pourquoi mon CRM ne trouve-t-il pas tous mes doublons ?
Parce que la détection native compare un ensemble de champs, souvent valeur pour valeur, et demande qu'ils soient renseignés. Les doublons qui diffèrent par une faute de frappe, un surnom, un format de téléphone, un suffixe d'entreprise ou un second e-mail ne correspondent pas sur ces champs. Les fiches sans e-mail ou domaine sont souvent ignorées complètement.
Un CRM peut-il trouver des doublons avec des adresses e-mail différentes ?
En général pas sur l'e-mail seul, car une adresse professionnelle et une adresse personnelle ne correspondent jamais. Certains outils natifs comparent aussi d'autres champs, comme le nom, le téléphone ou l'entreprise. Pour les trouver, faites correspondre sur nom plus téléphone, ou nom plus entreprise, et vérifiez les résultats avant de fusionner.
La déduplication native utilise-t-elle la correspondance floue ?
Cela dépend du CRM. La règle standard de correspondance des comptes de Salesforce peut comparer le nom, la rue et la ville par distance d'édition, en octobre 2026. Beaucoup de contrôles natifs, comme les recherches par e-mail et par domaine, comparent les valeurs à l'identique : les petites fautes de frappe et les différences de format passent donc entre les mailles.
Pourquoi mon CRM manque-t-il des doublons d'entreprises ?
Les noms d'entreprises varient beaucoup : « Inc. », « LLC », les abréviations et l'ordre des mots changent la valeur. La détection par domaine rate les entreprises sans site web ou avec deux domaines. Faire correspondre le domaine principal et un nom d'entreprise sans suffixes en attrape beaucoup.
Les outils natifs peuvent-ils trouver des doublons dans les champs personnalisés ?
Certains le peuvent, dans certaines limites. HubSpot permet à chaque objet d'avoir jusqu'à dix propriétés personnalisées qui exigent des valeurs uniques. Dans Salesforce, les règles derrière une tâche de doublons déterminent les champs qu'elle compare. Consultez les pages d'aide de votre CRM pour savoir quels champs et objets sa détection peut utiliser.


 Ou inscrivez-vous avec Google

 Pipedrive Marketplace












