
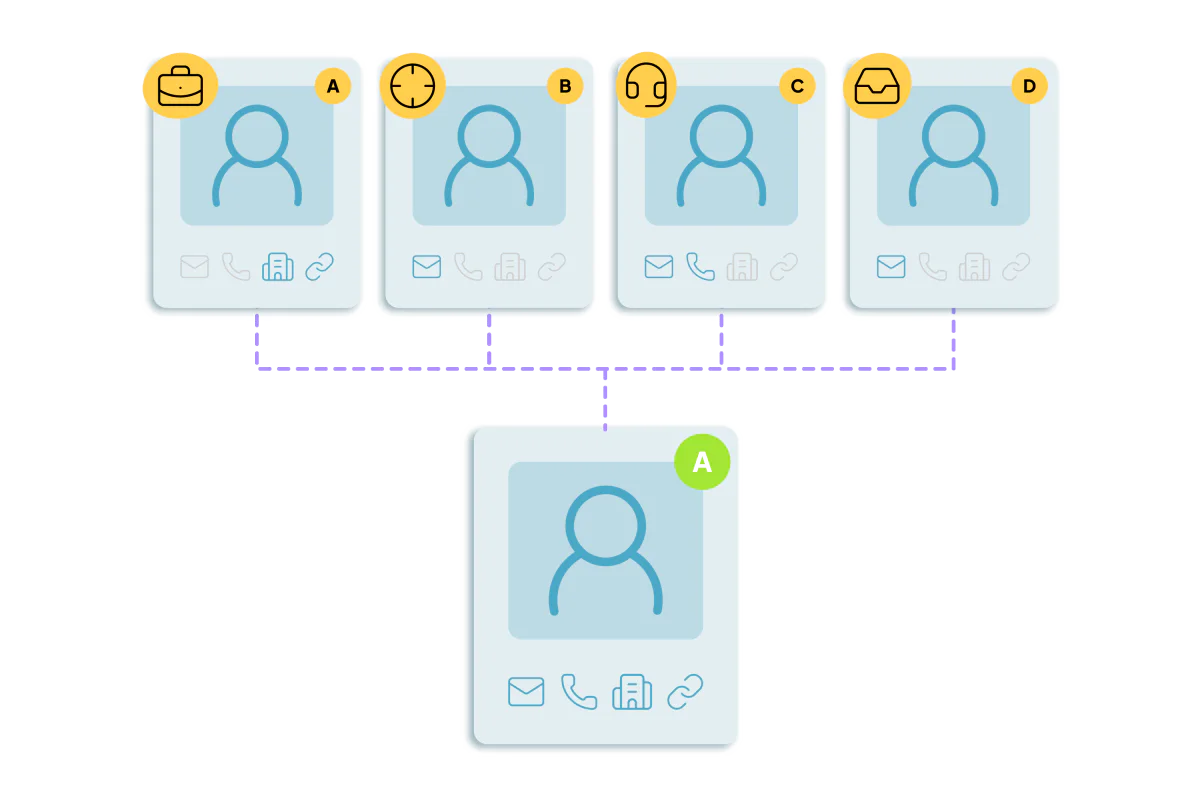


Conectar várias ferramentas de prospecção a um CRM cria registros de forma exponencial: cada ferramenta formata os dados dos prospects de forma diferente. Uma lista enxuta de 1.000 prospects-alvo vira rapidamente 3.000 registros de CRM separados.
Como Um Prospect Se Torna 4 Registros CRM Fragmentados
Um único prospect-alvo movendo-se através de uma stack de saída padrão desencadeia quatro criações de registros separadas:
- Exportação de redes sociais gera Registro A: nome, sobrenome e nome da empresa, sem e-mail.
- O enriquecimento de dados acrescenta um email corporativo (tim@company.com) e o envia sem corresponder a um registro existente. Esse é o Registro B.
- A plataforma de contato a frio envia campanhas usando um pseudônimo (tim+outreach@company.com): Registro C.
- Sincronização de caixa de entrada captura uma resposta de um endereço pessoal (tim@gmail.com): Registro D.
Por Que a Desduplicação Nativa Não Consegue Corresponder a Registros Fragmentados
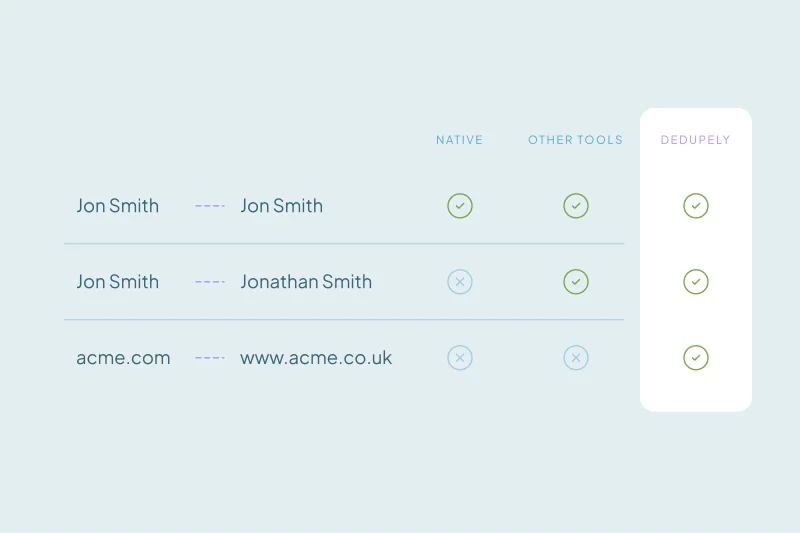
As ferramentas de duplicatas CRM padrão dependem de correspondências exatas em campos de e-mail primários ou nomes próprios. A arquitetura multi-ferramenta quebra isso de três maneiras:
Dependência de E-mail Principal nos Motores CRM Nativos
Quando uma importação não tem endereço de e-mail, as ferramentas nativas não conseguem fazer referência cruzada de nomes existentes ou domínios de empresa. Em vez de atualizar o prospect existente, o CRM cria um novo perfil por padrão.
Aliases de Email Não Reconhecidos e Incompatibilidades de Webmail
Aliases de email e endereços de email pessoais escapam aos controles de duplicados nativos: não correspondem exatamente ao domínio corporativo principal.
Visibilidade Restrita em Bases de Dados Grandes
Os utilitários CRM incorporados limitam correspondências de duplicatas visíveis, ocultando resultados multi-registros em grandes bases de dados. As equipes não conseguem ver a verdadeira escala da duplicação.
Como Unir Registros Duplicados de Múltiplas Fontes
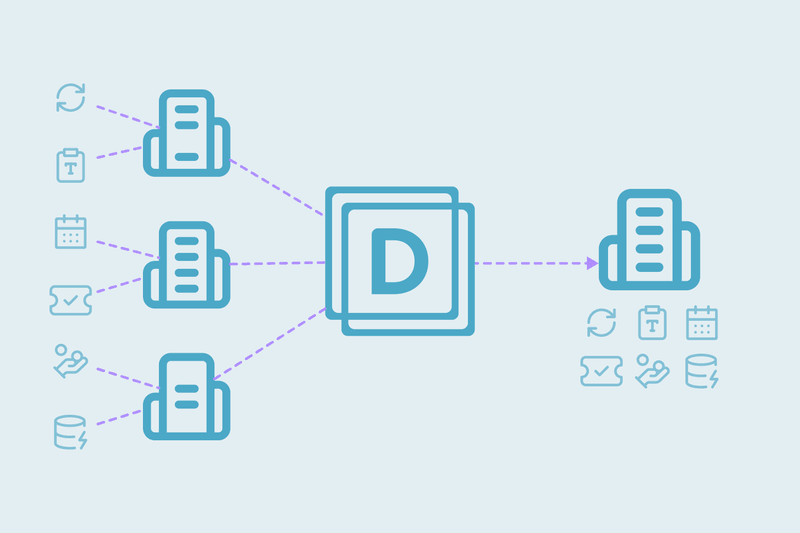
Resolver a fragmentação de identidade numa stack de múltiplas ferramentas significa ir além de correspondência por campo único para lógica multi-atributo. Quatro correções fecham as lacunas estruturais:
Contornar Correspondência de E-mail com Regras Multi-Atributo
Configure Duplicate Searches para ignorar completamente o campo de e-mail. A correspondência em Nome, Sobrenome e Domínio da Empresa em conjunto detecta duplicatas mesmo quando uma exportação de redes sociais não tem e-mail nenhum.
Executar Mesclagem Multi-Registros em Escala
Unifique correspondências com cinco ou mais registros numa ação única em vez de pares por vez, e o acúmulo se resolve mais rapidamente.
Personalizar o Resultado da Mesclagem para Evitar Perda de Dados
Merge Rules decidem qual valor vence campo a campo. Force o e-mail corporativo enriquecido a permanecer no campo principal, mova webmail pessoal para um campo secundário e mantenha cada nota de atividade histórica e data de contato anexada.
Encaminhamento de Casos Extremos para Manual Review
Envie duplicatas ambíguas, como dois nomes idênticos na mesma empresa com títulos de trabalho diferentes, para Excluded Matches. Um punhado de correspondências incertas nunca bloqueia a mesclagem em massa automatizada.
A correspondência exata por email numa pilha de várias ferramentas garante crescimento exponencial do banco de dados. Corresponder pelo campo que cada ponto de contato realmente compartilha mantém as contagens de contatos precisas e os históricos de atividade intactos.
Unir Registros Duplicados em Massa deixa Merge Rules decidir qual valor sobrevive em cada fonte, e Merge History registra exatamente o que mudou.
Comece grátis, conecte seu CRM e veja os duplicados que você tem antes de mesclar qualquer coisa. Comece aqui.



 Ou cadastre-se com o Google

 Salesforce AppExchange












