

TL;DR
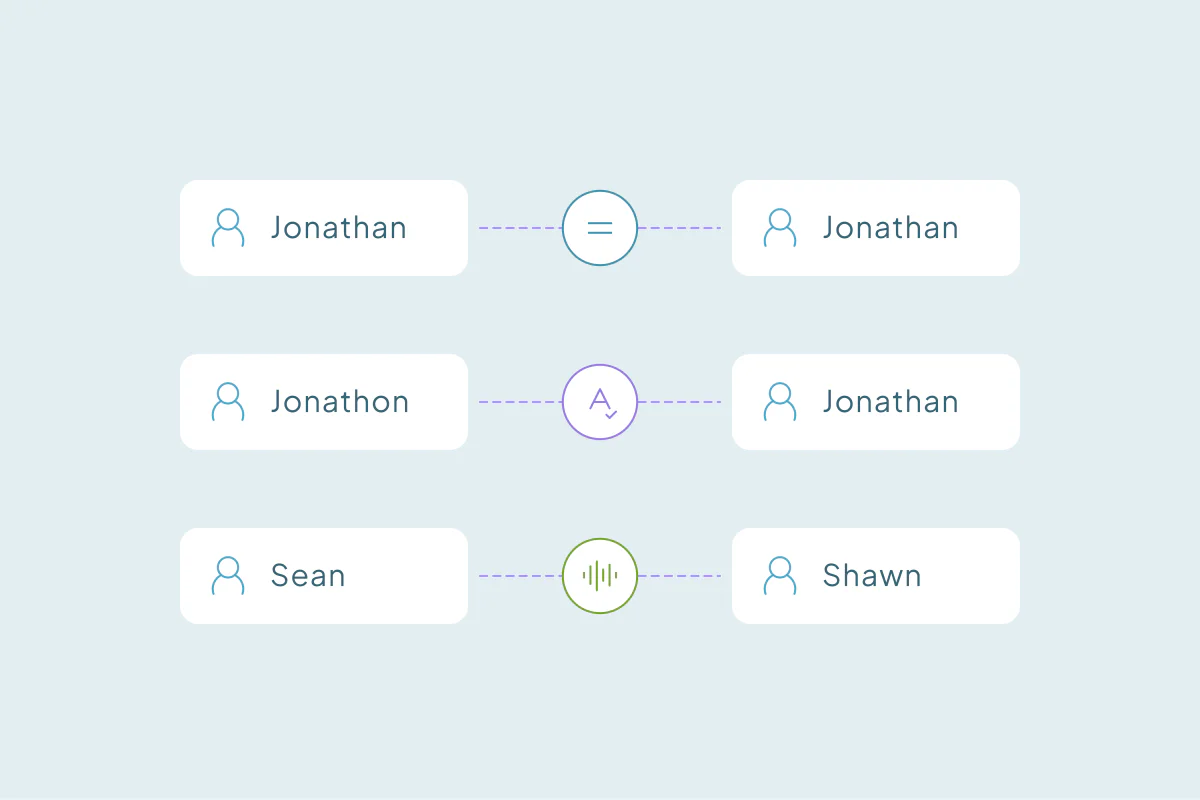
- Exakter Abgleich findet Datensätze mit identischen Werten, meist ohne Rücksicht auf Groß- und Kleinschreibung.
- Fuzzy-Abgleich erkennt Tippfehler, phonetischer Abgleich erkennt Namen, die gleich klingen.
- Mehrfeld-Abgleich kombiniert mehrere Felder, sodass ein einzelner gemeinsamer Wert für einen Treffer nicht reicht.
- Ein zu lockerer Abgleich paart verschiedene Datensätze, ein zu strenger übersieht Duplikate.
- Mit Dedupely wählen Sie, wie streng jedes Feld bei der Duplikatsuche abgeglichen wird.
Jedes Deduplizierungstool, ob im CRM eingebaut oder obendrauf, muss eine Frage beantworten: Sind diese zwei Datensätze dieselben? Wie es antwortet, nennt man Abgleich.
Abgleich klingt technisch, aber die Ideen dahinter sind einfach, und wer sie kennt, liest die Ergebnisse jedes Tools besser. Manche Methoden vergleichen Werte Buchstabe für Buchstabe, manche erlauben kleine Unterschiede, und manche vergleichen, wie Namen klingen. Viele echte Suchen kombinieren mehrere Felder.
In diesem Beitrag sehen Sie, wie jede Abgleichsart funktioniert, was sie erkennt und wo sie danebenliegt. Sie sehen auch, warum es wichtiger ist, Ihre eigenen Duplikate zu kennen, als welche Methode Sie wählen.
Exakter Abgleich
Exakter Abgleich paart Datensätze mit identischen Werten. Es ist die berechenbarste Methode und der sicherste Startpunkt.
Was exakter Abgleich erkennt
Zwei Kontakte mit jane.doe@example.com oder zwei Firmen mit example.com als Domain. Exakter Abgleich ignoriert oft die Groß-/Kleinschreibung, sodass auch Jane.Doe@Example.com passt.
Das sind meist die offensichtlichen Duplikate: dasselbe Schlüsselfeld, zweimal eingegeben. Sie sind eine gute erste Gruppe zum Zusammenführen.
Was exakter Abgleich übersieht
Ein Leerzeichen zu viel, ein fehlender Buchstabe oder ein anderes Telefonformat, und ein exakter Abgleich scheitert. „+1 (555) 010-2030“ und „5550102030“ sind dieselbe Nummer, aber nicht derselbe Text.
Deshalb bereinigen viele Tools Werte vor dem Vergleich: Leerzeichen entfernen, Telefonformatierung streichen oder www von einer Website entfernen.
Unscharfer Abgleich
Unscharfer Abgleich paart Werte, die sich ähneln, auch wenn sie nicht identisch sind. Er misst, wie viele Änderungen nötig sind, um den einen Wert in den anderen zu verwandeln.
Was unscharfer Abgleich erfasst
Tippfehler und kleine Unterschiede: „Jonathon“ und „Jonathan“, „Acme Corp“ und „Acme Crop“ oder eine E-Mail mit einem vertauschten Buchstaben. Von Menschen eingegebene Daten sind voll davon.
Wo unscharfer Abgleich danebenliegt
Kurze Werte sind riskant. „Dan“ und „Jan“ unterscheiden sich um einen Buchstaben, ebenso viele kurze Firmennamen, die zu verschiedenen Unternehmen gehören.
Unscharfer Abgleich hat meist einen Schwellenwert: wie nah nah genug ist. Ein niedriger Schwellenwert findet mehr Duplikate und mehr falsche Treffer. Ein hoher ist sicherer, übersieht aber mehr.
Phonetischer Abgleich
Phonetischer Abgleich vergleicht, wie Werte klingen, statt wie sie geschrieben werden. Er wandelt jeden Namen in einen Code nach seinen Lauten um und vergleicht dann die Codes.
Was phonetischer Abgleich erfasst
Alternative Schreibweisen desselben Namens: Sean und Shawn oder Smith und Smyth. Manche phonetischen Methoden paaren auch Catherine und Kathryn, andere nicht. Solche Paare können dem unscharfen Abgleich entgehen, wenn die Schreibweise um mehr als ein oder zwei Buchstaben abweicht.
Wo phonetischer Abgleich danebenliegt
Phonetische Codes beruhen darauf, wie Namen in einer Sprache klingen, oft Englisch. Namen aus anderen Sprachen können Codes bekommen, die ihre Aussprache nicht wiedergeben.
Er gruppiert auch ähnlich klingende Namen, die zu verschiedenen Personen gehören. Phonetischer Abgleich funktioniert am besten bei Namen, kombiniert mit einem weiteren Feld.
Wortbasierter und Domain-Abgleich
Zwei weitere Methoden decken Fälle ab, die die anderen übersehen. Sie sind bei Firmendatensätzen üblich.
Wortbasierter Abgleich
Der wortbasierte Abgleich vergleicht die Wörter eines Werts, egal in welcher Reihenfolge. „Northwind Traders“ und „Traders Northwind“ passen zusammen, und auch „Northwind Traders Inc.“, wenn das Tool Folgendes ignoriert: Suffixe wie Inc. oder LLC.
Manche Tools erkennen auch gängige Spitznamen wie Robert und Bob, die weder unscharfer noch phonetischer Abgleich fände.
Domain-Abgleich
Domain-Abgleich vergleicht die Stammdomain einer E-Mail oder Website. Adressen wie sales@example.com und support@example.com teilen example.com, daher zeigen beide Datensätze auf eine Firma.
Private E-Mail-Domains wie gmail.com machen diese Methode kaputt, weil Millionen unverbundener Menschen sie teilen. Sie müssen außen vor bleiben.
Mehrfeld-Abgleich
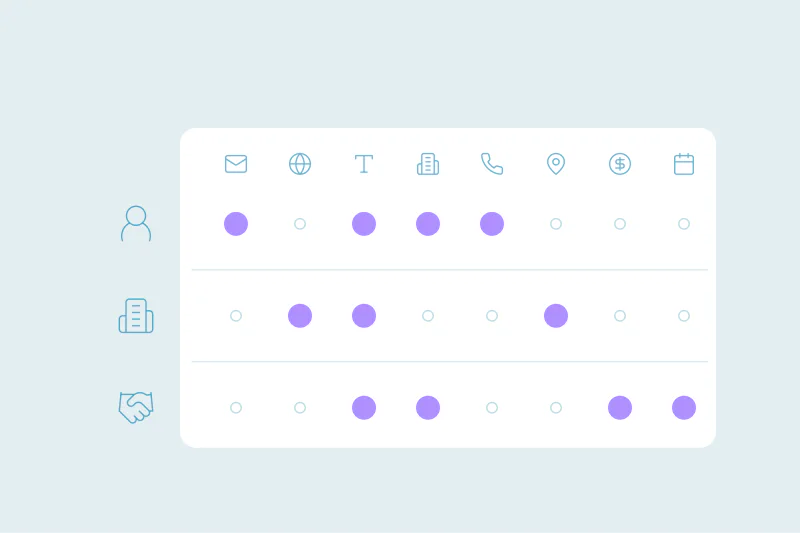
Außer bei Schlüsselfeldern wie E-Mail oder Domain beweist ein einzelnes Feld selten, dass zwei Datensätze gleich sind. Mehrfeld-Abgleich verlangt, dass mehrere Felder übereinstimmen, bevor Datensätze gepaart werden.
Felder kombinieren
Zwei Kontakte namens John Smith können zwei Personen sein. Zwei John Smiths in derselben Firma mit derselben Telefonnummer sind viel wahrscheinlicher eine.
Jedes Feld der Kombination kann seinen eigenen Abgleichstyp nutzen: die E-Mail exakt, den Namen phonetisch, die Firma wortbasiert. So wird eine Suche streng, wo sie es sein muss, und flexibel, wo sie es sein kann.
Suchen kombinieren
Manche Duplikate teilen eine E-Mail, andere nur einen Namen und eine Telefonnummer. Eine Suche deckt nicht beides ab, daher nutzen viele Bereinigungen mehrere Kombinationen nebeneinander.
Abgleichstypen auf einen Blick
| Abgleichstyp | Was es findet | Beispiel | Achten Sie auf |
|---|---|---|---|
| Exakt | Identische Werte | Gleiche E-Mail, beliebige Groß- und Kleinschreibung | Formatierungsunterschiede |
| Fuzzy | Tippfehler und fehlende Buchstaben | Jonathon und Jonathan | Kurze Werte |
| Phonetisch | Ähnlich klingende Namen | Sean und Shawn | Namen aus anderen Sprachen |
| Wortbasiert | Dieselben Wörter in beliebiger Reihenfolge, ohne Begriffe wie Inc. | Northwind Traders Inc. und Northwind Traders | Allgemeine Wörter, die viele Firmen teilen |
| Domain | Gleiche Kerndomain | sales@ und support@ bei einer Firma | Private E-Mail-Domains |
| Mehrere Felder | Datensätze, die in mehreren Feldern übereinstimmen | Gleicher Name, gleiche Firma und Telefonnummer | Oft leere Felder |
Zu locker oder zu streng
Abgleich kann in zwei Richtungen danebengehen, und viele Setups tun irgendwo beides.
- Zu locker: verschiedene Datensätze werden gepaart. Zwei Personen mit ähnlichen Namen oder zwei Niederlassungen mit einer Domain landen in einem Treffer, und ein Merge würde sie vermischen.
- Zu streng: echte Duplikate bleiben getrennt. Dieselbe Person mit einem Tippfehler im Namen oder einer Telefonnummer in anderem Format passt nie.
Abgleichen bildet nur Paare; Zusammenführen ist ein eigener Schritt. Trotzdem ist ein zusammengeführter falscher Treffer schwerer zu beheben als ein übersehenes Duplikat. Deshalb beginnen viele Teams streng und lockern ein Feld nach dem anderen.
Wissen, was in Ihrem eigenen CRM ein Duplikat ist
Das größere Problem kommt meist vor jeder Abgleichsart: nicht zu wissen, was in Ihrem eigenen CRM einen Datensatz zum Duplikat macht. Was ein Team für ein Duplikat hält, sieht ein anderes vielleicht nicht so.
Sehen Sie sich an, wo sich Ihre Datensätze überschneiden
Schauen Sie sich zuerst an, wie Duplikate in Ihren Daten auftauchen. Teilen sie eine E-Mail, eine Telefonnummer, eine Firmendomain? Welche Felder sind verlässlich gefüllt, und welche sind oft leer oder falsch?
Zwei Niederlassungen mit einer gemeinsamen Domain können für ein Team Duplikate und für ein anderes getrennte Kunden sein. Die Daten allein sagen es Ihnen nicht.
Dann den Match-Typ jedes Felds festlegen
Wenn Sie wissen, wie ein Duplikat aussieht, ergibt sich der Abgleich. Sie können entscheiden, welche Felder Sie kombinieren, und wie locker oder streng jedes sein soll.
Beginnen Sie mit den offensichtlichen Duplikaten, meist exakten Treffern auf Schlüsselfeldern wie E-Mail oder Domain. Sind Sie sicher, dass ein Paar kein Duplikat ist, lehnen Sie es ab, damit es nicht wiederkommt.
Wie Sie mit Dedupely jedes Feld auf Ihre Weise abgleichen
In Dedupely bekommt jedes Feld einer Duplikatsuche seinen eigenen Abgleichstyp, von exakt bis zu gemeinsamen Wörtern oder Kerndomain. „Similar“ erkennt Tippfehler und kleine Schreibunterschiede, „Fuzzy“ ähnlich klingende Namen. Sie können Felder kombinieren und falsche Treffer ablehnen oder einen mit KI gebauten Abgleich komplexe Duplikate bei Kontakten, Firmen und Leads finden lassen.
Abgleich funktioniert am besten, wenn Sie wissen, was Sie abgleichen
Exakter, unscharfer, phonetischer, wortbasierter und Domainabgleich erkennen jeweils eine andere Art von Duplikat, und jeder hat blinde Flecken. Erst die Kombination von Feldern macht daraus Suchen, denen Sie vertrauen können.
Die Methode zählt weniger, als Ihre Daten zu kennen. Wissen Sie, was einen Datensatz zum Duplikat macht und wo sich Datensätze überschneiden, fällt die Entscheidung leichter, wie streng jedes Feld sein soll.
Häufige Fragen
Was ist der Unterschied zwischen exaktem und unscharfem Abgleich?
Exakter Abgleich paart Datensätze mit identischen Werten, meist ohne Groß- und Kleinschreibung zu beachten. Unscharfer Abgleich paart ähnliche Werte, etwa Namen mit einem Tippfehler oder fehlendem Buchstaben. Exakt ist sicherer, übersieht aber kleine Unterschiede; unscharf findet mehr Duplikate und mehr falsche Treffer.
Was ist phonetischer Abgleich?
Phonetischer Abgleich vergleicht, wie Namen klingen, statt wie sie geschrieben werden, sodass Sean und Shawn oder Smith und Smyth passen. Er wandelt jeden Namen in einen Code nach seinen Lauten um. Er funktioniert am besten bei Namen und zusammen mit einem weiteren Feld, da viele Namen ähnlich klingen.
Warum mehr als ein Feld nutzen, um Duplikate zu finden?
Weil außerhalb von Schlüsselfeldern wie E-Mail oder Domain ein gemeinsamer Wert selten beweist, dass zwei Datensätze dasselbe sind. Zwei Kontakte namens John Smith können verschiedene Personen sein, aber gleicher Name, gleiche Firma und gleiche Telefonnummer zusammen sind ein starker Beleg. Jedes Feld kann seinen eigenen Abgleichstyp nutzen, streng bei manchen Feldern und flexibel bei anderen.
Wie vermeide ich beim Deduplizieren falsche Treffer?
Beginnen Sie streng, mit exakten Treffern bei Schlüsselfeldern wie E-Mail oder Domain, und führen Sie diese zuerst zusammen. Lockern Sie ein Feld nach dem anderen und prüfen Sie die Ergebnisse vor dem Merge. Lassen Sie private E-Mail-Domains weg und lehnen Sie Paare ab, bei denen Sie sicher sind, dass es keine Duplikate sind, damit sie nicht wiederkommen.
Welchen Abgleichstyp sollte ich verwenden?
Das hängt vom Feld ab und davon, was ein Duplikat für Ihr Team bedeutet. Exact passt für E-Mails und IDs, fuzzy für getippte Namen, phonetic für Namen mit abweichenden Schreibweisen und domain matching für Firmen. Viele Suchen kombinieren mehrere, jede so streng, wie das Feld es braucht.

 Oder mit Google registrieren

 Pipedrive Marketplace