

Résumé
- La correspondance exacte trouve les fiches aux valeurs identiques, en ignorant en général les majuscules.
- La correspondance fuzzy repère les fautes de frappe, et la correspondance phonétique les noms qui se prononcent pareil.
- Le rapprochement multi-champs combine plusieurs champs, une seule valeur commune ne suffit donc pas pour correspondre.
- Une correspondance trop souple apparie des fiches différentes, et une trop stricte rate des doublons.
- Dedupely vous laisse choisir la rigueur de la correspondance de chaque champ lors de la recherche de doublons.
Tout outil de dédoublonnage, intégré à un CRM ou ajouté par-dessus, doit répondre à une question : ces deux fiches sont-elles la même ? La façon dont il répond s'appelle le rapprochement.
Le rapprochement semble technique, mais les idées derrière sont simples, et les connaître aide à lire les résultats de n'importe quel outil. Certaines méthodes comparent les valeurs lettre par lettre, d'autres tolèrent de petites différences, d'autres encore comparent la prononciation des noms. Beaucoup de vraies recherches combinent plusieurs champs.
Dans cet article, vous verrez comment fonctionne chaque type de correspondance, ce qu'il repère et ce qu'il rate. Vous verrez aussi pourquoi connaître vos propres doublons compte plus que la méthode choisie.
Correspondance exacte
La correspondance exacte apparie les fiches dont les valeurs sont identiques. C'est la méthode la plus prévisible et le point de départ le plus sûr.
Ce que repère la correspondance exacte
Deux contacts avec jane.doe@example.com, ou deux entreprises avec example.com comme domaine. La correspondance exacte ignore souvent la casse, donc Jane.Doe@Example.com correspond aussi.
Ce sont en général les doublons évidents : le même champ clé, saisi deux fois. C'est un bon premier lot à fusionner.
Ce que la correspondance exacte rate
Un espace en trop, une lettre manquante ou un autre format de téléphone, et une correspondance exacte échoue. « +1 (555) 010-2030 » et « 5550102030 » sont le même numéro, mais pas le même texte.
C'est pourquoi beaucoup d'outils nettoient les valeurs avant de les comparer : suppression des espaces, du formatage des numéros ou du www d'un site.
Correspondance approximative
La correspondance approximative apparie des valeurs proches, même si elles ne sont pas identiques. Elle mesure combien de modifications il faut pour passer d'une valeur à l'autre.
Ce que repère la correspondance approximative
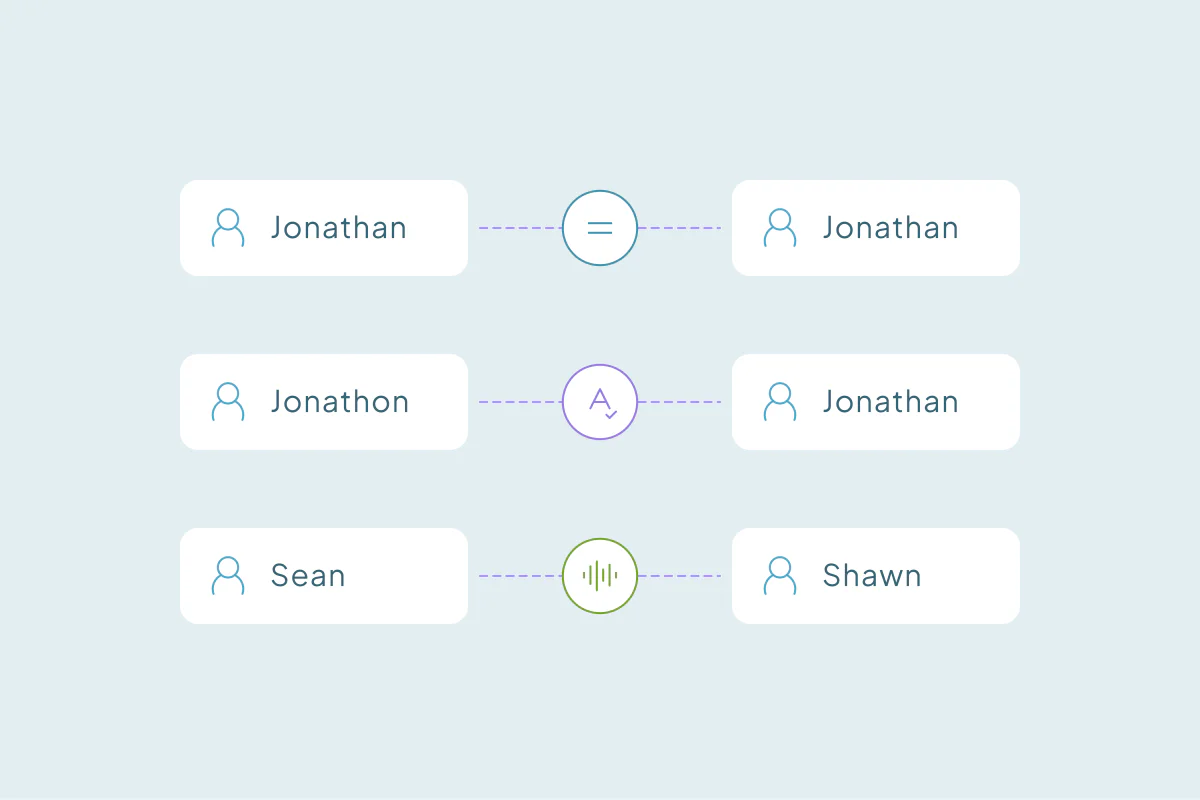
Fautes de frappe et petites différences : « Jonathon » et « Jonathan », « Acme Corp » et « Acme Crop », ou un e-mail avec une lettre inversée. Les données saisies par des personnes en sont pleines.
Ce que rate la correspondance approximative
Les valeurs courtes sont risquées. « Dan » et « Jan » diffèrent d'une lettre, comme beaucoup de noms d'entreprise courts qui appartiennent à des sociétés différentes.
La correspondance approximative a en général un seuil : à partir de quand c'est assez proche. Un seuil bas attrape plus de doublons et plus de fausses correspondances. Un seuil haut est plus sûr mais en rate davantage.
Correspondance phonétique
La correspondance phonétique compare la prononciation des valeurs plutôt que leur orthographe. Elle transforme chaque nom en un code selon ses sons, puis compare les codes.
Ce que repère la correspondance phonétique
Orthographes différentes d'un même nom : Sean et Shawn, ou Smith et Smyth. Certaines méthodes phonétiques apparient aussi Catherine et Kathryn, d'autres non. De telles paires peuvent échapper à la correspondance approximative quand l'orthographe diffère de plus d'une ou deux lettres.
Ce que rate la correspondance phonétique
Les codes phonétiques reposent sur la prononciation des noms dans une langue, souvent l'anglais. Les noms d'autres langues peuvent recevoir des codes qui ne reflètent pas leur prononciation.
Elle regroupe aussi des noms qui se prononcent pareil mais appartiennent à des personnes différentes. La correspondance phonétique fonctionne mieux sur les noms, combinée à un autre champ.
Rapprochement par mots et par domaine
Deux autres méthodes gèrent les cas que les autres ratent. Elles sont courantes pour les fiches entreprise.
Correspondance par mots
La correspondance par mots compare les mots d'une valeur, quel que soit leur ordre. « Northwind Traders » et « Traders Northwind » correspondent, et « Northwind Traders Inc. » aussi si l'outil ignore les suffixes comme Inc. ou LLC.
Certains outils reconnaissent aussi les surnoms courants, comme Robert et Bob, que ni la correspondance approximative ni la phonétique ne repéreraient.
Correspondance par domaine
Correspondance par domaine compare le domaine principal d'un e-mail ou d'un site web. Des adresses comme sales@example.com et support@example.com partagent example.com, et les deux fiches désignent donc une seule entreprise.
Les domaines d'e-mail personnels comme gmail.com cassent cette méthode, car des millions de personnes sans lien les partagent. Il faut les exclure.
Correspondance multichamp
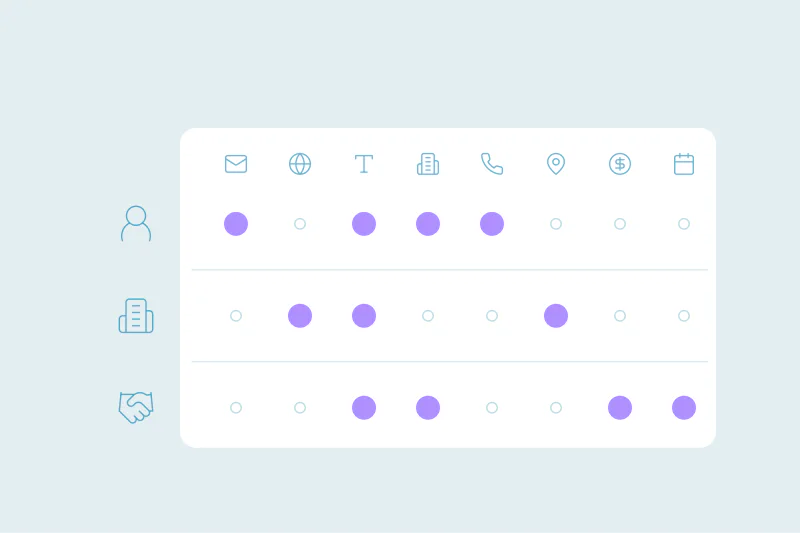
Hors champs clés comme l'e-mail ou le domaine, un seul champ prouve rarement que deux fiches sont identiques. La correspondance multichamp exige que plusieurs champs concordent avant de rapprocher des fiches.
Combiner des champs
Deux contacts nommés John Smith peuvent être deux personnes. Deux John Smith dans la même entreprise avec le même numéro sont bien plus probablement une seule.
Chaque champ de la combinaison peut utiliser son propre type de correspondance : l'e-mail exact, le nom phonétique, l'entreprise par mots. C'est ainsi qu'une recherche devient stricte là où il faut et souple là où c'est possible.
Combiner des recherches
Certains doublons partagent un e-mail ; d'autres seulement un nom et un téléphone. Une seule recherche ne couvre pas les deux, donc beaucoup de nettoyages utilisent plusieurs combinaisons en parallèle.
Les types de correspondance en un coup d'œil
| Type de correspondance | Ce qu'il détecte | Exemple | Attention à |
|---|---|---|---|
| Exact | Valeurs identiques | Même e-mail, quelle que soit la casse | Différences de mise en forme |
| Approximatif | Fautes de frappe et lettres manquantes | Jonathon et Jonathan | Valeurs courtes |
| Phonétique | Noms qui se ressemblent à l'oreille | Sean et Shawn | Les noms d'autres langues |
| Par mots | Les mêmes mots dans n'importe quel ordre, en ignorant des termes comme Inc. | Northwind Traders Inc. et Northwind Traders | Des mots génériques communs à beaucoup d'entreprises |
| Domaine | Même domaine racine | sales@ et support@ dans une même entreprise | Domaines de messagerie personnels |
| Plusieurs champs | Les fiches qui concordent sur plusieurs champs | Même nom, entreprise et téléphone | Champs souvent vides |
Trop large ou trop stricte
Le rapprochement peut échouer dans deux sens, et beaucoup de configurations font les deux quelque part.
- Trop souple : des fiches différentes sont rapprochées. Deux personnes aux noms proches, ou deux agences sur un même domaine, se retrouvent dans une correspondance, et la fusionner les combinerait.
- Trop stricte : de vrais doublons restent séparés. La même personne avec une faute dans son nom, ou un téléphone dans un autre format, ne correspond jamais.
Le rapprochement ne fait qu'associer des fiches ; la fusion est une étape à part. Malgré tout, une fausse correspondance fusionnée est plus difficile à corriger qu'un doublon manqué. C'est pourquoi beaucoup d'équipes commencent strictes et assouplissent un champ à la fois.
Savoir ce qu'est un doublon dans votre propre CRM
Le vrai problème survient en général avant tout type de correspondance : ne pas savoir ce qui fait d'une fiche un doublon dans votre propre CRM. Ce qu'une équipe considère comme un doublon, une autre peut ne pas le faire.
Regardez où vos fiches se chevauchent
Commencez par regarder comment les doublons apparaissent dans vos données. Partagent-ils un e-mail, un téléphone, un domaine d'entreprise ? Quels champs sont remplis de façon fiable, et lesquels sont souvent vides ou faux ?
Deux agences qui partagent un domaine peuvent être des doublons pour une équipe et des clients distincts pour une autre. Les données seules ne le disent pas.
Puis fixez le type de correspondance de chaque champ
Une fois que vous savez à quoi ressemble un doublon, la correspondance suit. Vous pouvez choisir quels champs combiner, et le degré de souplesse ou de rigueur de chacune.
Commencez par les doublons évidents, en général des correspondances exactes sur des champs clés comme l'e-mail ou le domaine. Quand vous êtes sûr qu'une paire n'est pas un doublon, rejetez-la pour qu'elle ne revienne pas.
Comment Dedupely vous laisse rapprocher chaque champ à votre façon
Dans Dedupely, chaque champ d'une recherche de doublons a son propre type de correspondance, de l'exact aux mots communs ou au domaine principal. « Similar » repère les fautes de frappe et les petites différences d'orthographe, et « Fuzzy » les noms qui se prononcent pareil. Vous pouvez combiner des champs et rejeter les fausses correspondances, ou laisser un rapprochement conçu par IA trouver les doublons complexes dans les contacts, entreprises et leads.
La correspondance marche mieux quand on sait ce qu'on rapproche
Les correspondances exacte, approximative, phonétique, par mots et par domaine repèrent chacune un type de doublon, et chacune a ses angles morts. C'est en combinant des champs qu'on en fait des recherches fiables.
La méthode compte moins que la connaissance de vos données. Une fois que vous savez ce qui fait d'une fiche un doublon et où les fiches se chevauchent, décider de la rigueur de chaque champ devient plus simple.
Questions fréquentes
Quelle différence entre correspondance exacte et approximative ?
La correspondance exacte rapproche les fiches aux valeurs identiques, en ignorant généralement la casse. La correspondance approximative rapproche des valeurs proches, comme des noms avec une faute ou une lettre manquante. L'exacte est plus sûre mais manque les petites différences ; l'approximative attrape plus de doublons et plus de fausses correspondances.
Qu'est-ce que la correspondance phonétique ?
La correspondance phonétique compare la prononciation des noms plutôt que leur orthographe, et Sean et Shawn ou Smith et Smyth correspondent. Elle transforme chaque nom en un code selon ses sons. Elle fonctionne mieux sur les noms et combinée à un autre champ, car beaucoup de noms se prononcent pareil.
Pourquoi utiliser plus d'un champ pour trouver les doublons ?
Parce qu'en dehors des champs clés comme l'e-mail ou le domaine, une valeur partagée prouve rarement que deux fiches sont identiques. Deux contacts nommés John Smith peuvent être des personnes différentes, mais le même nom, la même entreprise et le même téléphone ensemble sont une preuve solide. Chaque champ peut utiliser son propre type de correspondance, strict sur certains champs et souple sur d'autres.
Comment éviter les fausses correspondances lors du dédoublonnage ?
Commencez strict, avec des correspondances exactes sur des champs clés comme l'e-mail ou le domaine, et fusionnez-les d'abord. Assouplissez un champ à la fois et examinez les résultats avant de fusionner. Écartez les domaines de messagerie personnelle, et rejetez les paires dont vous êtes sûr qu'elles ne sont pas des doublons pour qu'elles ne reviennent pas.
Quel type de correspondance utiliser ?
Cela dépend du champ et de ce qu'un doublon signifie pour votre équipe. Exact convient aux e-mails et aux ID, fuzzy aux noms saisis à la main, phonetic aux noms aux orthographes variables et domain matching aux entreprises. Beaucoup de recherches en combinent plusieurs, chacune réglée à la rigueur dont ce champ a besoin.

 Ou inscrivez-vous avec Google

 Pipedrive Marketplace