

TL;DR
- La corrispondenza esatta trova record con valori identici, di solito ignorando maiuscole e minuscole.
- La corrispondenza fuzzy intercetta i refusi, e quella fonetica i nomi che suonano uguali.
- La corrispondenza su più campi combina diversi campi, quindi un solo valore condiviso non basta per corrispondere.
- Una corrispondenza troppo ampia abbina record diversi, e una troppo rigida non coglie i duplicati.
- Dedupely ti permette di scegliere quanto rigida è la corrispondenza di ogni campo quando cerchi i duplicati.
Ogni strumento di deduplicazione, integrato in un CRM o aggiunto sopra, deve rispondere a una domanda: questi due record sono lo stesso? Il modo in cui risponde si chiama corrispondenza.
La corrispondenza sembra tecnica, ma le idee dietro sono semplici, e conoscerle aiuta a leggere i risultati di qualsiasi strumento. Alcuni metodi confrontano i valori lettera per lettera, altri ammettono piccole differenze e altri confrontano come suonano i nomi. Molte ricerche reali combinano più campi.
In questo articolo vedrai come funziona ogni tipo di corrispondenza, cosa intercetta e dove sbaglia. Vedrai anche perché conoscere i tuoi duplicati conta più del metodo che scegli.
Corrispondenza esatta
La corrispondenza esatta abbina record con valori identici. È il metodo più prevedibile e il punto di partenza più sicuro.
Cosa intercetta la corrispondenza esatta
Due contatti con jane.doe@example.com, o due aziende con example.com come dominio. La corrispondenza esatta spesso ignora le maiuscole, quindi corrisponde anche Jane.Doe@Example.com.
Di solito sono i duplicati evidenti: lo stesso campo chiave, inserito due volte. Sono un buon primo gruppo da unire.
Cosa sfugge alla corrispondenza esatta
Uno spazio in più, una lettera mancante o un formato di telefono diverso, e una corrispondenza esatta fallisce. "+1 (555) 010-2030" e "5550102030" sono lo stesso numero, ma non lo stesso testo.
Per questo molti strumenti puliscono i valori prima di confrontarli: tolgono spazi, la formattazione dei telefoni o il www di un sito.
Corrispondenza approssimativa
La corrispondenza approssimativa abbina valori simili, anche quando non sono identici. Misura quante modifiche servono per trasformare un valore nell'altro.
Cosa intercetta la corrispondenza approssimativa
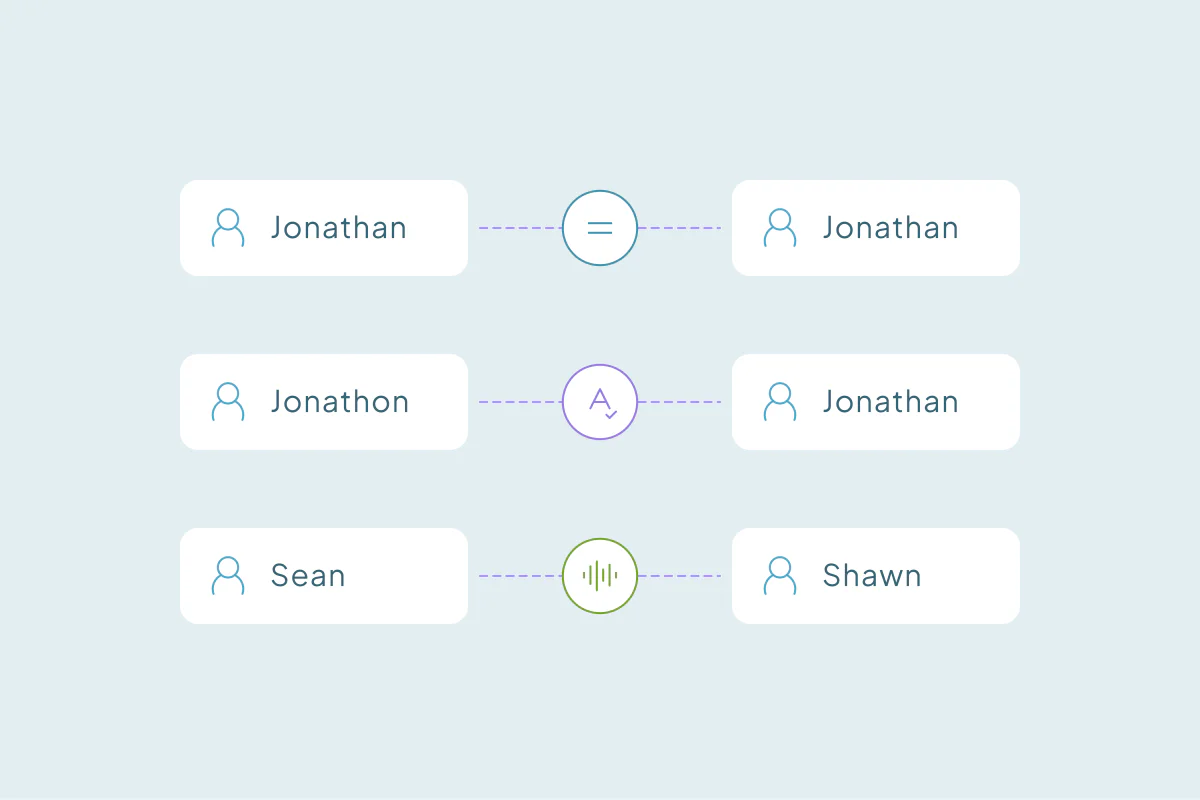
Refusi e piccole differenze: "Jonathon" e "Jonathan", "Acme Corp" e "Acme Crop", o un'email con una lettera scambiata. I dati digitati dalle persone ne sono pieni.
Dove sbaglia la corrispondenza approssimativa
I valori brevi sono rischiosi. "Dan" e "Jan" differiscono di una lettera, come molti nomi aziendali brevi che appartengono a imprese diverse.
La corrispondenza approssimativa ha di solito una soglia: quanto vicino basta. Una soglia bassa intercetta più duplicati e più false corrispondenze. Una alta è più sicura ma ne perde di più.
Corrispondenza fonetica
La corrispondenza fonetica confronta come suonano i valori invece di come si scrivono. Trasforma ogni nome in un codice in base ai suoni, poi confronta i codici.
Cosa intercetta la corrispondenza fonetica
Grafie alternative dello stesso nome: Sean e Shawn, o Smith e Smyth. Alcuni metodi fonetici abbinano anche Catherine e Kathryn, altri no. Coppie come queste possono sfuggire alla corrispondenza approssimativa quando la grafia differisce di più di una o due lettere.
Dove sbaglia la corrispondenza fonetica
I codici fonetici si basano su come suonano i nomi in una lingua, spesso l'inglese. I nomi di altre lingue possono ricevere codici che non riflettono la loro pronuncia.
Raggruppa anche nomi che suonano simili ma appartengono a persone diverse. La corrispondenza fonetica funziona meglio sui nomi, combinata con un altro campo.
Corrispondenza per parole e per dominio
Altri due metodi gestiscono i casi che gli altri non colgono. Sono comuni per i record aziendali.
Corrispondenza per parole
La corrispondenza per parole confronta le parole di un valore, in qualunque ordine. "Northwind Traders" e "Traders Northwind" corrispondono, e anche "Northwind Traders Inc." può corrispondere se lo strumento ignora suffissi come Inc. o LLC.
Alcuni strumenti riconoscono anche soprannomi comuni, come Robert e Bob, che né la corrispondenza approssimativa né quella fonetica coglierebbero.
Corrispondenza per dominio
Corrispondenza per dominio confronta il dominio principale di un'email o di un sito web. Indirizzi come sales@example.com e support@example.com condividono example.com, quindi entrambi i record indicano un'unica azienda.
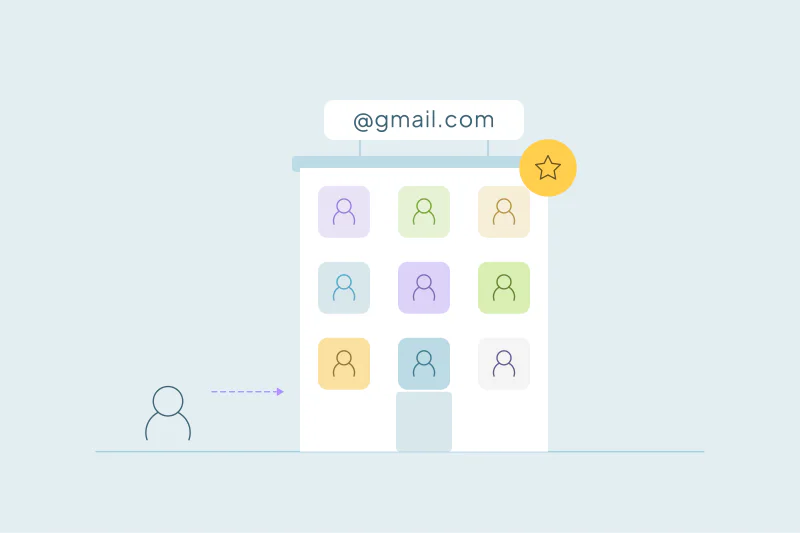
I domini email personali come gmail.com rompono questo metodo, perché li condividono milioni di persone senza legami. Vanno esclusi.
Corrispondenza su più campi
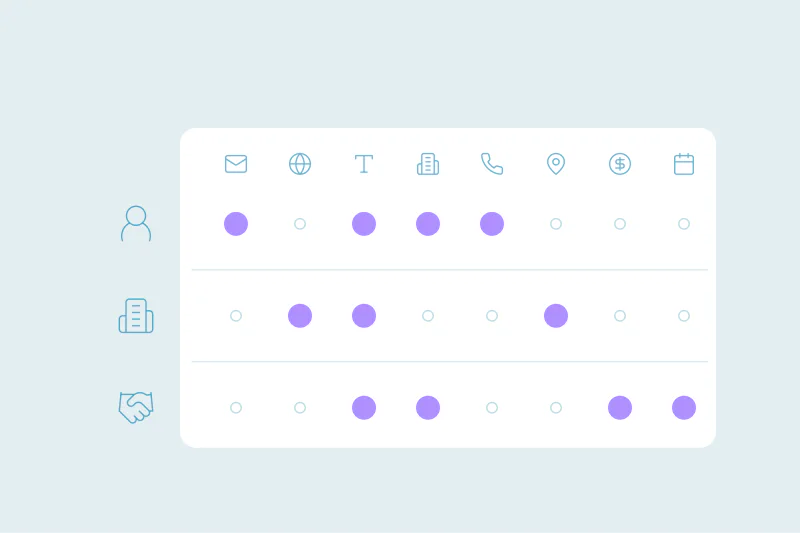
Al di fuori dei campi chiave come email o dominio, un singolo campo raramente prova che due record sono uguali. La corrispondenza multicampo richiede che più campi coincidano prima di abbinare i record.
Combinare i campi
Due contatti di nome John Smith possono essere due persone. Due John Smith nella stessa azienda con lo stesso numero di telefono è molto più probabile che siano uno.
Ogni campo della combinazione può usare il proprio tipo di corrispondenza: l'email esatta, il nome fonetico, l'azienda per parole. È così che una ricerca diventa rigida dove deve e flessibile dove può.
Combinare le ricerche
Alcuni duplicati condividono un'email; altri solo un nome e un telefono. Una ricerca non copre entrambi i casi, quindi molte pulizie usano più combinazioni in parallelo.
I tipi di corrispondenza in breve
| Tipo di corrispondenza | Cosa cattura | Esempio | Fai attenzione a |
|---|---|---|---|
| Esatta | Valori identici | Stessa email, con qualsiasi uso delle maiuscole | Differenze di formattazione |
| Fuzzy | Refusi e lettere mancanti | Jonathon e Jonathan | Valori brevi |
| Fonetica | Nomi che suonano simili | Sean e Shawn | Nomi di altre lingue |
| Per parole | Le stesse parole in qualsiasi ordine, ignorando termini come Inc. | Northwind Traders Inc. e Northwind Traders | Parole generiche condivise da molte aziende |
| Dominio | Stesso dominio principale | sales@ e support@ in una stessa azienda | Domini email personali |
| Più campi | Record che concordano su più campi | Stesso nome, azienda e telefono | Campi spesso vuoti |
Troppo ampia o troppo rigida
La corrispondenza può sbagliare in due direzioni, e molte configurazioni sbagliano in entrambe da qualche parte.
- Troppo largo: record diversi vengono abbinati. Due persone con nomi simili, o due filiali con un solo dominio, finiscono in una corrispondenza, e unirla le combinerebbe.
- Troppo rigida: i veri duplicati restano separati. La stessa persona con un refuso nel nome, o un telefono in un altro formato, non corrisponde mai.
La corrispondenza si limita ad accoppiare i record; unire è un passo a parte. Comunque, una falsa corrispondenza unita è più difficile da sistemare di un duplicato mancato. Per questo molti team partono rigidi e allentano un campo alla volta.
Sapere cos'è un duplicato nel tuo CRM
Il problema più grande di solito viene prima di qualsiasi tipo di corrispondenza: non sapere cosa rende un record un duplicato nel tuo CRM. Ciò che un team considera un duplicato, un altro potrebbe non farlo.
Guarda dove si sovrappongono i tuoi record
Inizia guardando come compaiono i duplicati nei tuoi dati. Condividono un'email, un telefono, un dominio aziendale? Quali campi sono compilati in modo affidabile, e quali sono spesso vuoti o sbagliati?
Due filiali che condividono un dominio possono essere duplicati per un team e clienti separati per un altro. I dati da soli non lo dicono.
Poi imposta il tipo di corrispondenza di ogni campo
Quando sai com'è un duplicato, la corrispondenza viene da sé. Puoi decidere quali campi combinare, e quanto larga o rigorosa deve essere ciascuna.
Parti dai duplicati evidenti, di solito corrispondenze esatte su campi chiave come email o dominio. Quando sei sicuro che una coppia non è un duplicato, rifiutala così non torna.
Come Dedupely ti fa confrontare ogni campo a modo tuo
In Dedupely, ogni campo di una ricerca di duplicati ha il proprio tipo di corrispondenza, dall'esatta alle parole condivise o al dominio principale. "Similar" intercetta refusi e piccole differenze di grafia, e "Fuzzy" i nomi che suonano simili. Puoi combinare i campi e rifiutare le false corrispondenze, o lasciare che un confronto costruito con l'IA trovi duplicati complessi in contatti, aziende e lead.
La corrispondenza funziona meglio quando sai cosa stai confrontando
Corrispondenza esatta, approssimativa, fonetica, per parole e per dominio colgono ciascuna un tipo diverso di duplicato, e ognuna ha i suoi punti ciechi. È la combinazione dei campi a trasformarle in ricerche affidabili.
Il metodo conta meno che conoscere i tuoi dati. Una volta che sai cosa rende un record un duplicato e dove i record si sovrappongono, decidere quanto rigoroso debba essere ogni campo diventa più facile.
Domande frequenti
Qual è la differenza tra corrispondenza esatta e approssimativa?
La corrispondenza esatta abbina record con valori identici, di solito ignorando le maiuscole. La corrispondenza approssimativa abbina valori vicini, come nomi con un refuso o una lettera mancante. L'esatta è più sicura ma perde le piccole differenze; l'approssimativa trova più duplicati e più false corrispondenze.
Cos'è la corrispondenza fonetica?
La corrispondenza fonetica confronta come suonano i nomi invece di come si scrivono, quindi Sean e Shawn o Smith e Smyth corrispondono. Trasforma ogni nome in un codice in base ai suoni. Funziona meglio sui nomi e insieme a un altro campo, perché molti nomi suonano simili.
Perché usare più di un campo per trovare i duplicati?
Perché, al di fuori dei campi chiave come email o dominio, un valore condiviso raramente prova che due record siano lo stesso. Due contatti di nome John Smith possono essere persone diverse, ma stesso nome, azienda e telefono insieme sono una prova solida. Ogni campo può usare il proprio tipo di corrispondenza, rigido su alcuni campi e flessibile su altri.
Come evito le false corrispondenze quando deduplico?
Parti in modo rigoroso, con corrispondenze esatte su campi chiave come email o dominio, e unisci prima quelle. Allenta un campo alla volta e rivedi i risultati prima di unire. Escludi i domini email personali e rifiuta le coppie che sei certo non siano duplicati, così non tornano.
Quale tipo di corrispondenza devo usare?
Dipende dal campo e da cosa significa un duplicato per il tuo team. Exact va bene per email e ID, fuzzy per i nomi digitati, phonetic per i nomi con grafie alternative e domain matching per le aziende. Molte ricerche ne combinano diversi, ognuno con il rigore che serve a quel campo.

 Oppure registrati con Google

 Pipedrive Marketplace