


Duplicate Searches sind die Logik hinter jedem Scan, den Sie in Dedupely durchführen - basierend auf den Feldern, Matching-Optionen und Filtern, die Sie konfiguriert haben. Das bedeutet, dass Ihre Ergebnisse, egal ob exakt oder völlig daneben, direkt davon abhängen, wie Ihre Duplicate Search aufgebaut ist.
Dieser Leitfaden hilft Ihnen dabei:
- Verstehen Sie, wie Duplicate Searches funktionieren
- Richten Sie Match-Optionen ein, die abbilden, wie Sie Duplikate sehen
- Filter ergänzen, die genau die richtigen Dubletten treffen
- Testen, anpassen und die richtigen Datensätze zusammenführen
Was ist eine Duplicate Search?
Eine Duplicate Search ist ein gespeicherter Satz von Matching-Optionen, bei dem Sie bestimmen, was ein Duplikat ist. Sie entscheiden:
- Welche Felder verglichen werden (z. B. E-Mail, Telefon, Firmenname)
- Wie streng oder tolerant jeder Abgleich sein soll
- Ob Sie Filter einsetzen, um Ihre Suchen einzugrenzen
Jede Duplicate Search läuft mit eigener Logik. Sie können sie jederzeit scannen, bearbeiten oder klonen, um Abgleichoptionen zu testen, ohne das Original zu beeinflussen.
Felder und Abgleichoptionen
Felder sind die Datenpunkte, die Dedupely aus Ihrem CRM zieht, etwa E-Mail-Adressen oder Vornamen.
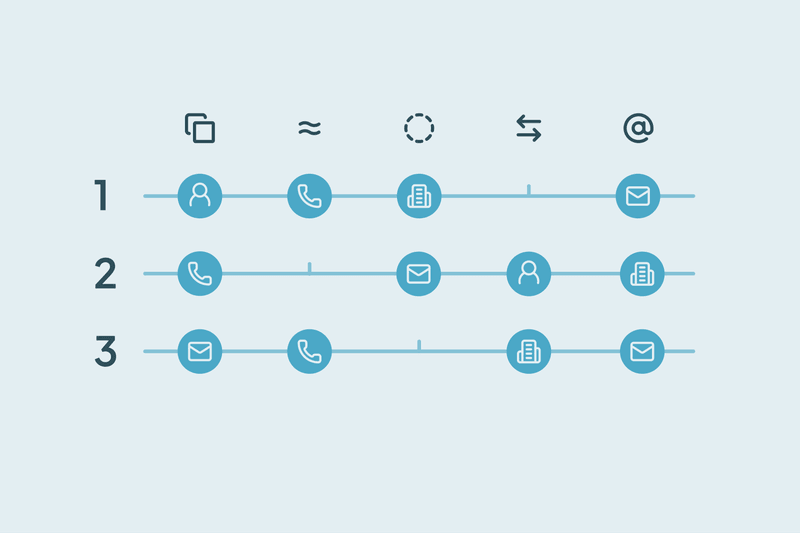
Match-Optionen legen fest, wie diese Felder verglichen werden:
- Exakt: Muss identisch sein
- Ähnlich: Kleine Abweichungen erlaubt (etwa Tippfehler oder Satzzeichen)
- Fuzzy: Findet Abweichungen von ein bis zwei Buchstaben, mit eingebautem phonetischem Algorithmus
- Similar Words (beliebige Reihenfolge): Nützlich bei vertauschter Wortreihenfolge (etwa „John Smith“ vs. „Smith John“)
- Erstes Wort: Gleicht ab, wie viele der ersten Wörter übereinstimmen sollen
- Zum Schluss: Gleicht anhand der Anzahl letzter Wörter ab, die Sie festlegen
- Domain-Root: Zum Vergleich von E-Mail-Domains (z. B. @company.com)
Was Sie matchen und wie Sie es matchen, verändert die Ergebnisse komplett:
- Gründliche Match-Optionen grenzen die Ergebnisse ein
- Großzügige Einstellungen erweitern sie
Matching richtig durchdenken
Beim Abgleich geht es darum, herauszuarbeiten, was Datensätze in Ihrem Fall zu Duplikaten macht.
Einige Beispiele:
- E-Mail + Name mit exakter Übereinstimmung = sichere Duplikate
- Vorname, Nachname und Telefon mit Ähnlich-Treffer + Firma mit Similar Words = gut für Callcenter-Daten oder Lead-Listen
- Vorname mit Fuzzy-Match + Adresse mit Exact-Match = ideal für Postdaten
Sie müssen nicht jedes Feld einbeziehen, nur die, die beim sinnvollen Abgleich helfen. Ziel sind alle Duplikate, nicht nur die offensichtlichen.
Tipp: Führen Sie zuerst die offensichtlichen Dubletten zusammen, danach die lockereren Optionen.
Filter: Den Scan eingrenzen
Sie können die Felder, die Dedupely scannt, durch Eingrenzung Ihrer Duplicate Search filtern.
Ein paar Beispiele, was möglich ist:
- Nur Datensätze einbeziehen, die nach einem bestimmten Datum erstellt wurden
- Datensätze eines bestimmten Vertriebsmitarbeiters durchsuchen
- Nach leeren Werten filtern, etwa Dubletten ohne E-Mail-Adresse
- Eine Lifecycle-Phase nach der anderen bearbeiten (z. B. Leads statt Kunden)
Filter sind optional, geben Ihnen aber Kontrolle, ohne zusätzliche Abgleichlogik zu erfordern.
Fortgeschrittene Methoden zur Nutzung von Duplicate Searches
Duplicate Searches lassen sich exakt auf Ihre Anforderungen zuschneiden:
- Feingranulare Match-Optionen über mehrere Werte hinweg nutzen
- Mehrere Werte mit unterschiedlicher Strenge kombinieren (z. B. E-Mail exakt + Telefon ähnlich)
- Mit Filtern die Datensätze eines Teams oder einen bestimmten Datenbestand eingrenzen
- Separate Duplicate Searches für Leads, Contacts, Accounts oder ältere Datensätze
So könnten verschiedene Teams Duplicate Searches nutzen:
- Vertrieb legt vermutlich am meisten Wert auf E-Mail + Name + zugeordnete Deals
- Customer Success matchen möglicherweise über Firma + Domain-Root
- Ops müssen möglicherweise Adresse + Telefon im gesamten CRM korrigieren
Duplicate-Search-Tipps (diesen Teil speichern)
- Klein anfangen. Ein einziges Feld mit strenger Übereinstimmung ist bereits ein großer erster Schritt.
- Versuchen Sie nicht, alles in einer Suche zu erfassen, verwässert das die Ergebnisse.
- Verwenden Sie drei bis vier Match-Optionen.
- Klonen Sie Ihre Duplicate Searches um neue Logik gefahrlos zu testen.
- Nicht nach einzelnen Feldern abgleichen. Das kann zu Fehltreffern führen.
- Vor dem Zusammenführen immer eine Vorschau ansehen. Sieht etwas nicht nach einer eindeutigen Dublette aus, passen Sie die Logik an.
Duplicate Searches sind der Ausgangspunkt in Dedupely, sie geben Ihnen mehr Klarheit, mehr Kontrolle und bessere Merge-Ergebnisse. Wenn Sie definieren, was ein Duplikat für Sie bedeutet, erledigt Dedupely den Rest.

 Oder mit Google registrieren

 HubSpot Marketplace












