


Die meisten CRM-Nutzer halten Dubletten für leicht erkennbar: gleiche E-Mail, gleiche Telefonnummer, gleicher Firmenname. So sauber zeigen sich Dubletten aber selten; meist stecken sie hinter Schreibvarianten, abweichenden Formaten und fehlenden Feldern - und wenn Sie sie beim Abgleich nicht korrekt erfassen, ist jede folgende Zusammenführung riskant.
Dieser Guide zeigt Ihnen, wie Sie Dubletten sicher erkennen. Sie erfahren den Unterschied zwischen offensichtlichen und verdeckten Dubletten, welche Felder am zuverlässigsten sind, wie die Abgleichsoptionen wirken und wie Sie Ihr Setup testen, bevor Sie automatisieren.
Was ist der Unterschied zwischen offensichtlichen und versteckten Duplikaten?
- Eindeutige Duplikate sind eindeutig: zwei Datensätze mit derselben E-Mail-Adresse, Telefonnummer oder Domain. Sie lassen sich sicher abgleichen und bedenkenlos zusammenführen.
- Versteckte Dubletten sind kniffliger:
- „Chris Johnson“ vs. „Christopher Johnson“
- “Brightline Technologies” vs. “Bright Line Tech”
- Ein Datensatz hat eine Geschäfts-E-Mail, ein anderer eine Mobilnummer – beide gehören zur selben Person
Offensichtliche Duplikate sind selten. Der größte Aufwand steckt in versteckten Duplikaten, und genau dort zählt die Abgleichlogik am meisten.
Welche Felder eignen sich am besten, um Duplikate zu finden?
Auch wenn einzelne Felder starke Identifikatoren sind, empfehlen wir, mindestens zwei Felder zu kombinieren.
- Stark in Kombination:
- Vorname + Nachname + E-Mail
- Firmenname + Adresse + Postleitzahl
- Vorname + Nachname + Telefon
- Unzuverlässige Felder:
- Position
- Notizen
- Freitextfelder
Mit welchen Match-Optionen startet man am sichersten?
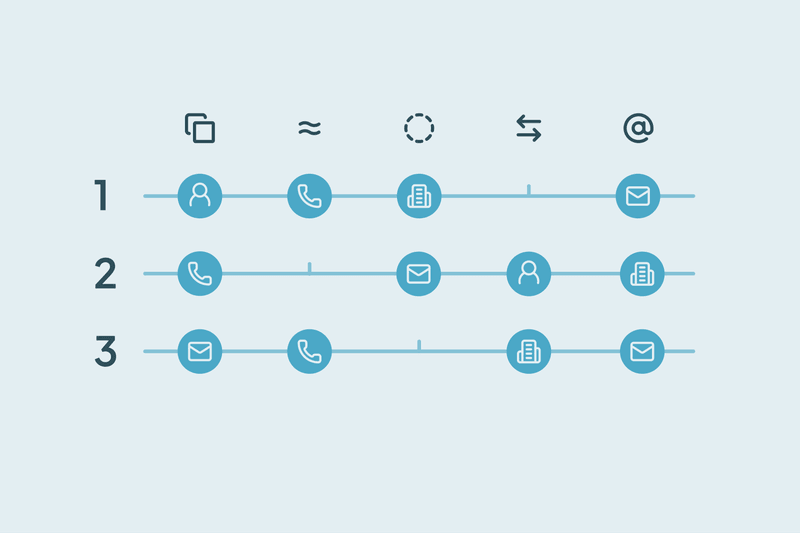
In Dedupely wählen Sie Match-Optionen für jedes Feld, auf das Sie sich verlassen, damit Sie festlegen, was ein Duplikat ist. Verfügbare Match-Optionen:
- Exakt Treffer: Felder müssen exakt übereinstimmen
- Ähnliche Übereinstimmung: Erkennt kleine Schreibunterschiede.
- Fuzzy Treffer: Erkennt ähnliche Varianten wie „Chris“ und „Christopher“.
- Similar Words (Any Order)-Abgleich: Findet Treffer mit vertauschter Wortreihenfolge (z. B. “Brightline Technologies” und “Technologies Brightline”).
- Domain-Rootmatch: Entfernt Subdomains und gleicht auf die Hauptdomain ab (z. B. “mail.greenfield.io“ vs. „greenfield.io”).
Best Practice:
- Beginnen Sie mit exakter Übereinstimmung auf Vorname + Nachname + E-Mail
- Ergänzen Sie Ähnlich/Fuzzy für Namen und Firmennamen, sobald Sie die Genauigkeit geprüft haben.
- Nutzen Sie Domain Root für Firmen, um Formatunterschiede zu erfassen.
Sie können diese Duplicate Searches speichern und wiederverwenden. So müssen Sie die Logik nicht jedes Mal neu erstellen.
Wie teste ich mein Match-Setup, um False Positives und False Negatives zu vermeiden?
Match-Logik muss getestet werden, bevor Sie ihr im großen Maßstab vertrauen. Ein einfacher Ablauf:
- Starten Sie einen Scan mit den gewählten Match-Optionen.
- Prüfen Sie 5–10 Trefferpaare manuell.
- Markieren Sie, welche echte Duplikate und welche Fehltreffer sind.
- Wenn falsche Treffer auftauchen, verschärfen Sie die Schwellenwerte oder ergänzen Sie weitere Felder.
- Wiederholen Sie den Scan, bis die Ergebnisse durchgehend korrekt sind.
- Wenn Sie sicher sind, speichern Sie die Logik als Duplicate Search für wiederholte Verwendung.
Tests verhindern zwei typische Risiken: zwei verschiedene Personen versehentlich zusammenzuführen (False Positives) und Dubletten ganz zu übersehen (False Negatives).
Gute Treffer sind die Grundlage sicherer Merges
Dublettenbereinigung beginnt beim Abgleich, und ohne saubere Abgleichlogik sind Zusammenführungen entweder riskant oder unvollständig.
Wenn Sie zuverlässige Felder verwenden, die richtigen Matching-Optionen anwenden und Ihre Einrichtung testen, können Sie echte Duplikate konsistent erkennen. Duplicate Searches ermöglichen es Ihnen dann, den Prozess zu wiederholen, ohne von vorne zu beginnen.


 Oder mit Google registrieren

 HubSpot-Nutzer












