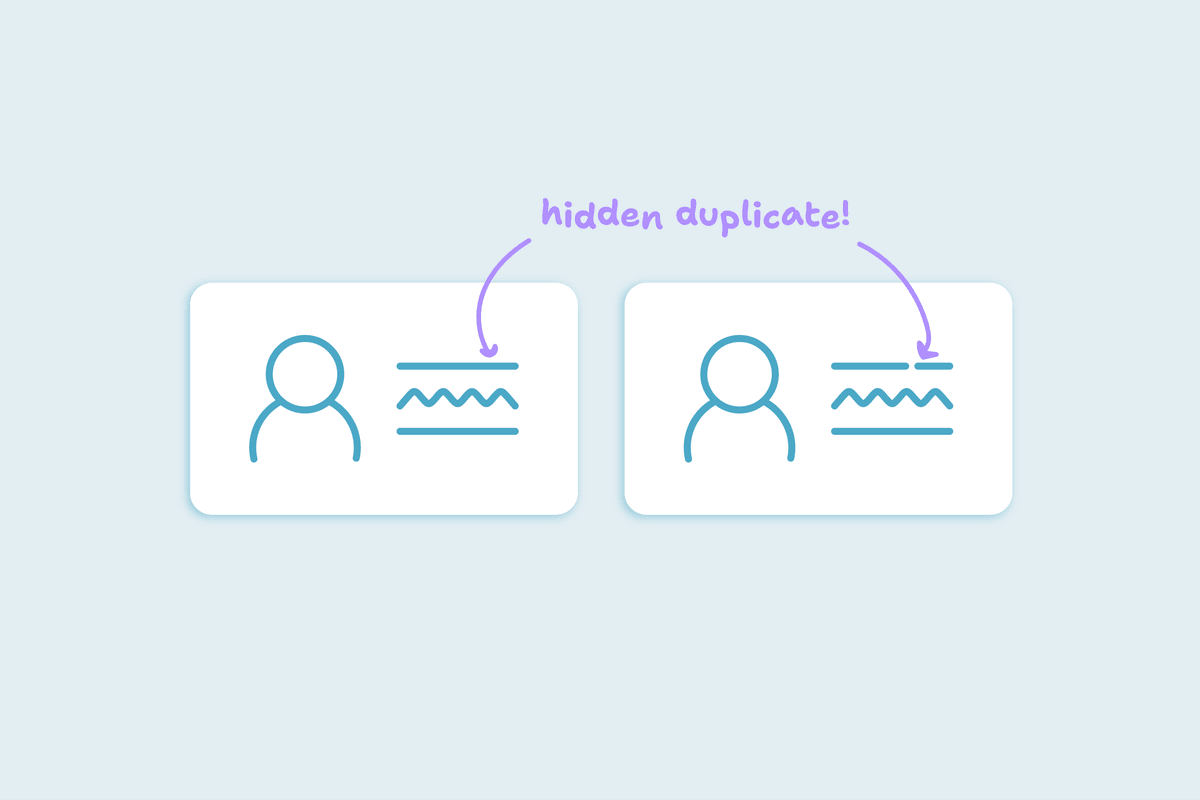


La mayoría de usuarios de CRM cree que los duplicados se ven a simple vista: mismo email, mismo teléfono, mismo nombre de empresa. Pero casi nunca aparecen tan claros; suelen esconderse tras variaciones de escritura, diferencias de formato y campos vacíos, y si no los detectas bien en la fase de coincidencia, todas las fusiones posteriores son un riesgo.
Esta guía le muestra cómo identificar duplicados con seguridad. Verá la diferencia entre duplicados evidentes y ocultos, qué campos son más fiables, cómo funcionan las opciones de coincidencia y cómo probar su configuración antes de automatizarla.
¿Qué diferencia hay entre duplicados evidentes y ocultos?
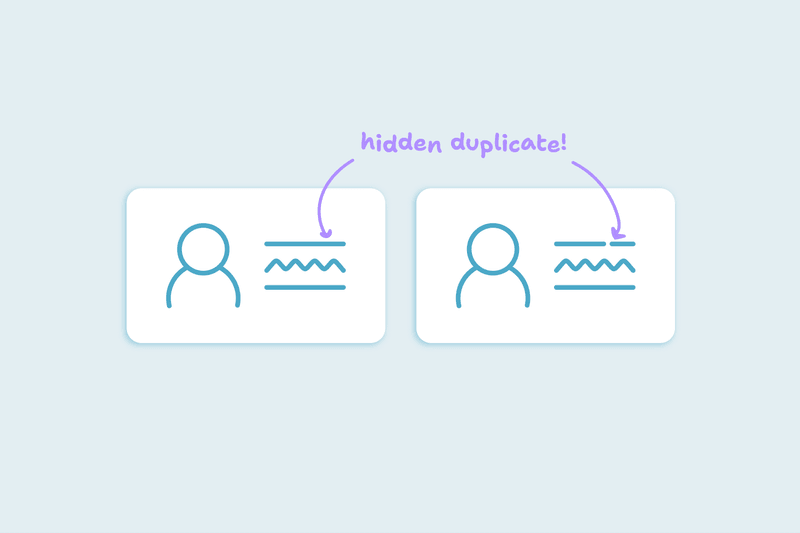
- Duplicados evidentes son claros: dos registros con el mismo email, teléfono o dominio. Se pueden emparejar con seguridad y fusionar sin dudar.
- Duplicados ocultos son más complicados:
- “Chris Johnson” vs “Christopher Johnson”
- “Brightline Technologies” vs “Bright Line Tech”
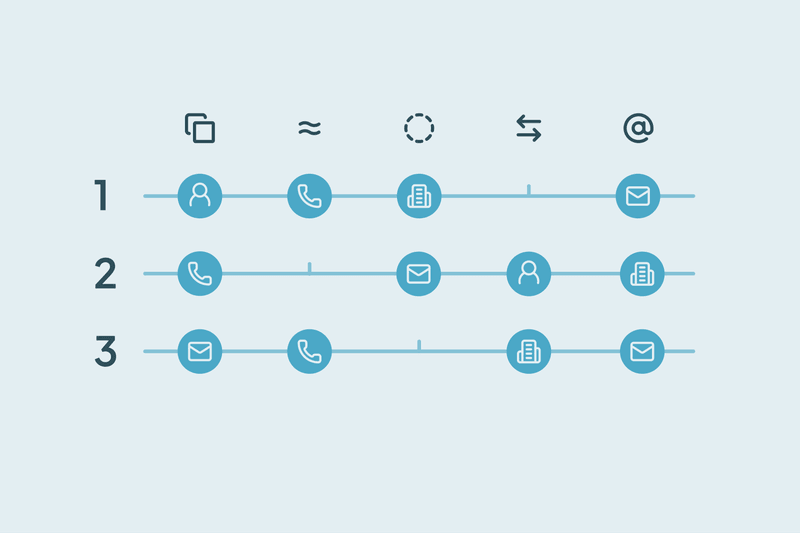
- Un registro tiene un email de trabajo, otro un número de móvil, y ambos son de la misma persona
Los duplicados evidentes son pocos. El grueso del trabajo está en los ocultos, y ahí es donde más importa la lógica de coincidencia.
¿Qué campos son más fiables para encontrar duplicados?
Aunque algunos campos son identificadores sólidos, recomendamos combinar al menos dos.
- Muy eficaz combinado:
- Nombre + Apellidos + Email
- Nombre de empresa + Dirección + Código postal
- Nombre + Apellidos + Teléfono
- Campos poco fiables:
- Cargo
- Notas
- Campos de texto libre
¿Con qué opciones de coincidencia conviene empezar?
En Dedupely, eliges opciones de coincidencia para cada campo en el que te apoyas, así decides qué es un duplicado. Las opciones de coincidencia disponibles son:
- Exacta coincidencia: Los campos deben coincidir exactamente
- Coincidencia similar: Detecta pequeñas diferencias de escritura.
- Fuzzy coincidencia: Detecta variaciones parecidas, como “Chris” y “Christopher”.
- Coincidencia Similar Words (Any Order): Encuentra coincidencias con las palabras en distinto orden (p. ej., “Brightline Technologies” frente a “Technologies Brightline”).
- Domain Rootmatch: Elimina los subdominios para comparar solo el dominio principal (p. ej., “mail.greenfield.io” vs “greenfield.io”).
Buena práctica:
- Empieza con coincidencia Exacta en Nombre + Apellidos + Email
- Añade coincidencia Similar/Aproximada para nombres y nombres de empresa cuando hayas comprobado la precisión.
- Usa la raíz del dominio en empresas para detectar diferencias de formato.
Puedes guardar estos criterios en Duplicate Searches reutilizables. Así no reconstruyes la lógica cada vez.
¿Cómo pruebo mi configuración de coincidencia para evitar falsos positivos o negativos?
La lógica de coincidencia hay que probarla antes de confiar en ella a gran escala. Un ciclo sencillo:
- Ejecuta un análisis con las opciones de coincidencia elegidas.
- Revisa manualmente entre 5 y 10 pares coincidentes.
- Marca cuáles son duplicados reales y cuáles falsas coincidencias.
- Si aparecen coincidencias falsas, ajusta los umbrales o añade campos de apoyo.
- Repite el escaneo hasta que los resultados sean siempre precisos.
- Una vez confiado, guarda la lógica como una Duplicate Search para reutilizarla.
Probar evita dos riesgos habituales: fusionar por error personas distintas (falsos positivos) y no detectar duplicados (falsos negativos).
Las buenas coincidencias son la base de una fusión segura
La deduplicación empieza por la coincidencia: sin una lógica de coincidencia sólida, las fusiones son inseguras o incompletas.
Cuando usas campos confiables, aplicas las opciones de coincidencia correctas y pruebas tu configuración, puedes identificar duplicados reales de forma consistente. Las Duplicate Searches entonces te permiten repetir el proceso sin empezar de cero.

 O regístrate con Google

 Usuario de HubSpot