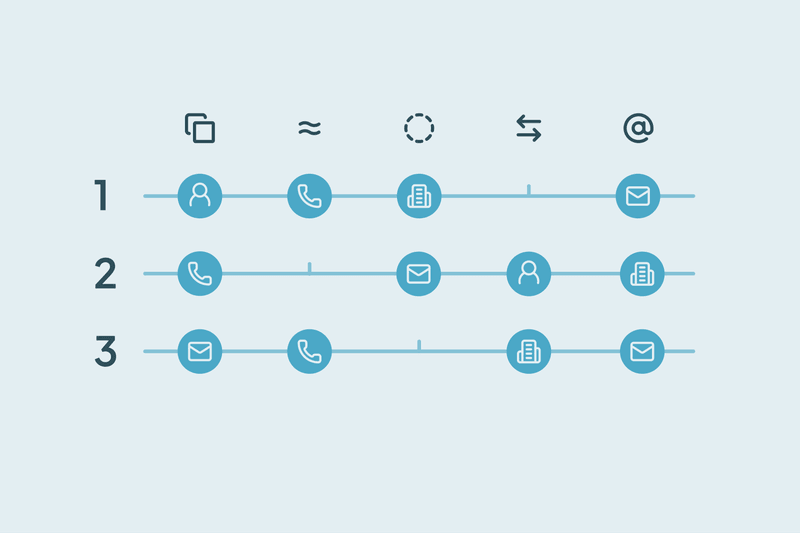
Beaucoup d'équipes CRM tentent de traiter tous les types de doublons dans une seule recherche. Résultat : des analyses lentes, des résultats imprévisibles et des fusions incohérentes. Le problème ne vient pas de la logique de rapprochement, mais de la structure. Une recherche fonctionne mieux quand elle est ciblée : chacune doit traiter un seul type de doublon.
Ce guide s'appuie sur ce qui est déjà couvert dans Le guide complet des Duplicate Searches dans Dedupely. Cet article explique les champs, types de correspondance et filtres en détail. Celui-ci montre comment organiser et utiliser plusieurs Duplicate Searches pour obtenir des résultats précis et reproductibles.
Comprendre les limites d'une Duplicate Search
Quand une Duplicate Search mélange plusieurs types de correspondance, la logique devient incohérente. Les correspondances exactes entrent en concurrence avec les indulgentes, les résultats s'étendent inégalement. Les filtres stricts et larges appliqués ensemble réduisent la fiabilité.
Chaque objet du CRM a ses propres schémas de données : les leads reposent souvent sur les noms et les e-mails, les comptes sur les domaines ou les raisons sociales. Un seul jeu d'options de rapprochement ne peut pas détecter efficacement les doublons dans tous ces cas.
Une Duplicate Search ne doit jamais tout trouver ; elle doit confirmer un seul schéma de duplication, par exemple « adresses e-mail identiques » ou « noms de sociétés similaires ».
Créez des Duplicate Searches distinctes dans Dedupely pour chaque schéma de doublon
Le moyen le plus efficace de garder le contrôle est de diviser la détection des doublons en plusieurs Duplicate Searches. Chacune représente un scénario de correspondance clair.
Servez-vous de ces distinctions comme repère :
- Par type d’objet : Les Contacts, Comptes, Personnes et objets personnalisés (selon votre CRM) ont souvent besoin de leurs propres Duplicate Searches
- Par source de données : Imports, formulaires et intégrations n’ont pas la même fiabilité champ par champ
- Par objectif de correspondance : Certains doublons se repèrent par e-mail, d’autres par domaine ou par téléphone
Exemples :
- Contacts : Prénom + E-mail = correspondance exacte
- Comptes : Entreprise : correspondance exacte + E-mail : correspondance Domain Root + Téléphone : correspondance similaire
- Imports historiques : Prénom + Nom = correspondance exacte + Adresse = correspondance similaire
Chaque Duplicate Search devrait répondre à une question : « Quels doublons correspondent exactement à ce modèle ? »
Uniformisez la nomenclature et la documentation
Les Duplicate Searches se multiplient vite dès qu'une équipe affine sa logique. Un nommage cohérent prévient la confusion et aide à comprendre ce que chaque recherche fait.
Restez court et structuré :
- Formater les noms en
[Field] + [Field] + [Logic]tels queFirst Name + Last Name + Exact MatchouCompany Name + Address + First 2 words - Notez brièvement dans le champ description les options de rapprochement et les filtres
- Évitez les noms passe-partout comme « Principal » ou « Tous les enregistrements », qui n’apportent aucune clarté
- Organisez les Duplicate Searches (Actif, Test, Archivé)
Une dénomination claire et des notes rendent les Duplicate Searches réutilisables et faciles à examiner des mois plus tard.
Si vous voulez en savoir plus sur les options de rapprochement, consultez cet article.
Tester la logique de correspondance en la clonant
Chaque fois que vous devez tester une nouvelle logique, dupliquez une Duplicate Search existante plutôt que de la modifier directement. La duplication conserve la configuration éprouvée tout en permettant une expérimentation rapide.
Pour tester :
- Dupliquer la Duplicate Search originale
- Modifiez un seul paramètre de rapprochement à la fois, par exemple passer un champ d’une correspondance Exacte à Similaire
- Lancez une analyse pour comparer les différences de résultats
- Gardez l'original comme référence et renommez votre recherche de test clairement, par exemple,
First Name + Last Name + Phone Number + Exact + Test1
Cette approche affine la logique de rapprochement sans interrompre le travail en cours ni perdre une configuration fiable.
Examinez et maintenez régulièrement les Duplicate Searches
Les Duplicate Searches exigent le même entretien que les autres processus CRM. Les structures de champs changent, les sources de données évoluent et les priorités de l'équipe changent.
Passez-les en revue régulièrement :
- Supprimez les Duplicate Searches qui dupliquent la logique ou qui ne sont plus utilisées
- Vérifiez que les filtres correspondent toujours à la structure actuelle de votre CRM
- Mettez à jour les critères de rapprochement si des champs ont été ajoutés ou renommés
- Conservez un enregistrement interne concis de qui a créé ou mis à jour chaque Duplicate Search.
Une revue trimestrielle suffit à garder une logique de correspondance propre et alignée sur vos données réelles.
Appliquez des Duplicate Searches structurées pour des résultats mesurables
Un système bien structuré de Duplicate Searches offre des analyses plus rapides et une meilleure précision. Il facilite aussi l'audit et le partage des fusions en équipe. Les équipes qui séparent les Duplicate Searches par logique voient moins de faux positifs et peuvent déléguer l'analyse en toute confiance. Chaque recherche devient une unité reproductible que d'autres peuvent comprendre et réutiliser.
La précision vient de la structure : les Duplicate Searches petites et ciblées offrent plus de contrôle qu'une configuration grande et complexe.
Pour le détail de la configuration des champs, des types de correspondance et des filtres, consultez Le guide complet des Duplicate Searches dans Dedupely.


 Ou inscrivez-vous avec Google