

Muchos equipos intentan resolver todos los tipos de duplicados en una sola búsqueda. El resultado suele ser escaneos lentos, resultados impredecibles y fusiones inconsistentes. El problema no es la lógica de coincidencia, sino la estructura que hay detrás. Las búsquedas funcionan mejor cuando están enfocadas: cada una debe cubrir un solo patrón de duplicado.
Esta guía parte de lo que ya se explica en La guía completa para Duplicate Searches en Dedupely. Ese artículo explica campos, tipos de coincidencia y filtros en detalle. El propósito de este es mostrar cómo organizar y usar múltiples Duplicate Searches para obtener resultados precisos y repetibles.
Entiende qué limita una Duplicate Search
Cuando una Duplicate Search mezcla varios tipos de coincidencia, la lógica de comparación se vuelve inconsistente. Las coincidencias exactas compiten con las flexibles, así que los resultados se expanden de forma desigual. Los filtros estrictos y amplios aplicados juntos reducen la fiabilidad.
Cada objeto del CRM tiene sus propios patrones de datos: los leads suelen depender de nombres y emails, mientras que las cuentas se apoyan en dominios o nombres de empresa. Un único conjunto de opciones de coincidencia no puede detectar duplicados de forma eficaz en todos esos patrones.
Una Duplicate Search no debe esperarse que encuentre todo; solo debe confirmar un patrón de duplicación, como "correos idénticos" o "nombres de empresa similares".
Crea Duplicate Searches separadas en Dedupely para patrones de duplicados distintos
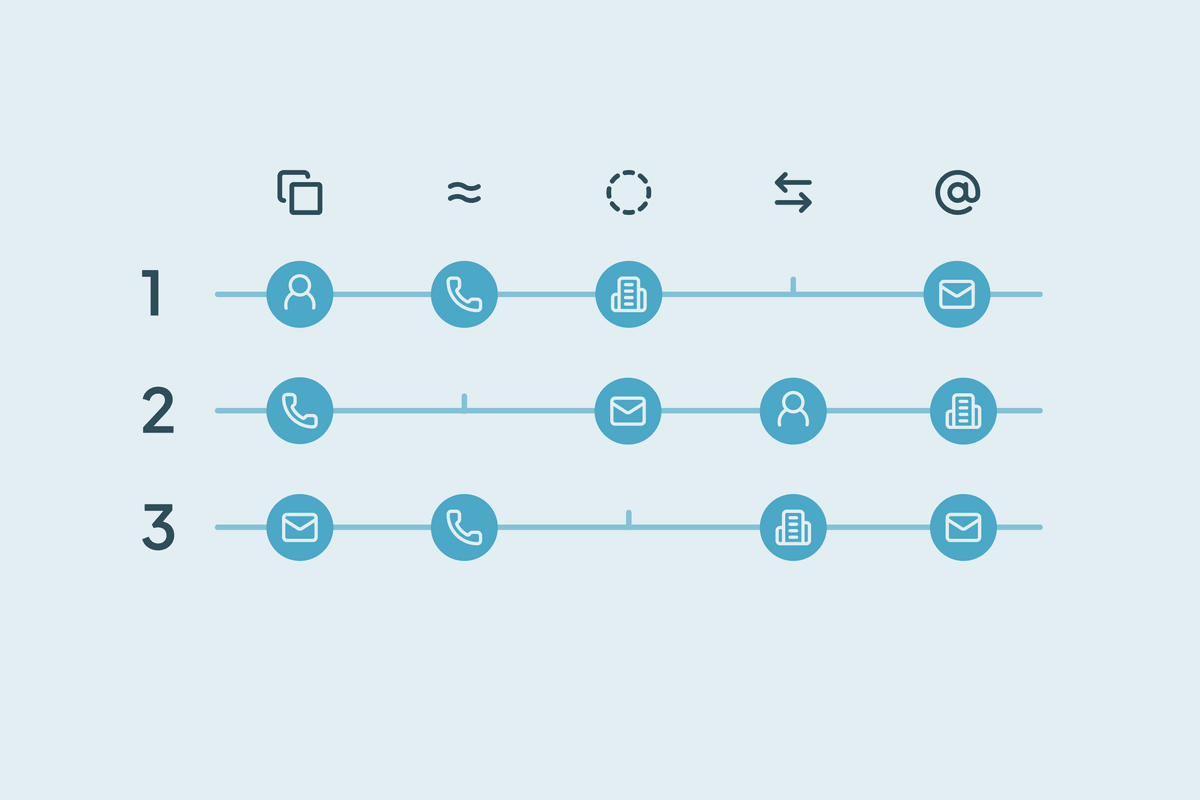
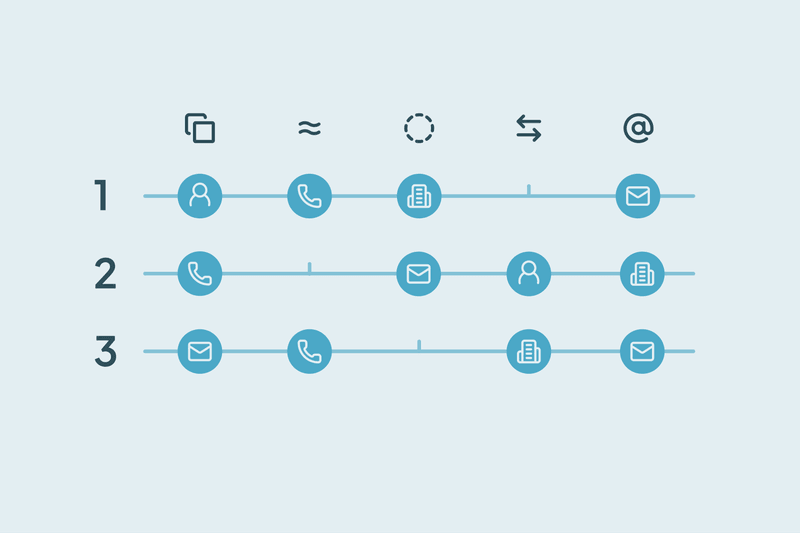
La forma más efectiva es dividir la detección de duplicados en múltiples Duplicate Searches. Cada una representa un escenario de coincidencia distinto.
Usa estas distinciones como guía:
- Por tipo de objeto: Contactos, Cuentas, Personas y objetos personalizados (según tu CRM) a menudo necesitan sus propias Duplicate Searches
- Por origen de datos: Las importaciones, los formularios y las integraciones suelen tener distinta precisión por campo
- Por objetivo de coincidencia: Unos duplicados se detectan por email, otros por dominio o por teléfono
Ejemplos:
- Contactos: Nombre + Email = Coincidencia exacta
- Cuentas: Empresa: coincidencia exacta + Email: coincidencia por raíz del dominio + Teléfono: coincidencia similar
- Importaciones antiguas: Nombre + Apellidos = coincidencia exacta + Dirección = coincidencia similar
Cada Duplicate Search debe responder una pregunta: "¿Qué duplicados se ajustan a este patrón exacto?"
Mantén la nomenclatura y la documentación coherentes
Las Duplicate Searches se multiplican rápidamente cuando un equipo comienza a refinar la lógica. La nomenclatura consistente evita confusiones y ayuda a cualquiera a entender qué hace cada búsqueda.
Hazlo corto y estructurado:
- Formatear nombres como
[Field] + [Field] + [Logic]comoFirst Name + Last Name + Exact MatchoCompany Name + Address + First 2 words - Añade notas breves en el campo de descripción sobre las opciones de coincidencia y los filtros
- Evita nombres genéricos como “Principal” o “Todos los registros”, que no aportan claridad
- Organiza Duplicate Searches (Activas, Prueba, Archivadas)
Nomenclatura clara y notas hacen que las Duplicate Searches sean reutilizables y fáciles de revisar meses después.
Si quieres saber más sobre las opciones de coincidencia, consulte este artículo.
Prueba la lógica de coincidencia clonando
Cada vez que necesites probar una nueva lógica, clona una Duplicate Search existente en lugar de cambiarla directamente. Clonar preserva la configuración probada mientras permite experimentar rápidamente.
Para probarlo:
- Clonar la Duplicate Search original
- Cambia un parámetro de coincidencia cada vez, por ejemplo pasar un campo de coincidencia Exacta a Similar
- Ejecuta un análisis para comparar las diferencias en los resultados
- Mantén el original como referencia y renombra la búsqueda de prueba claramente, por ejemplo,
First Name + Last Name + Phone Number + Exact + Test1
Este proceso ayuda a afinar la lógica de coincidencia sin interrumpir el trabajo en curso ni perder una configuración fiable.
Revisa y mantén tus Duplicate Searches regularmente
Las Duplicate Searches requieren el mismo mantenimiento que otros procesos de CRM. Los campos cambian, los orígenes de datos evolucionan y el enfoque del equipo se desplaza.
Revísalos de forma periódica:
- Elimina Duplicate Searches con lógica duplicada o que no uses recientemente
- Comprueba que los filtros siguen encajando con la estructura actual de tu CRM
- Actualiza las opciones de coincidencia si se han añadido o renombrado campos
- Mantén un registro interno breve de quién creó o actualizó cada Duplicate Search
Con una revisión trimestral basta para mantener la lógica de coincidencia limpia y ajustada a los datos reales.
Aplica Duplicate Searches estructuradas para resultados medibles
Un sistema bien estructurado de Duplicate Searches proporciona escaneos más rápidos y mayor precisión. También facilita auditar las fusiones e intercambiarlas entre equipos. Los equipos que separan Duplicate Searches por lógica obtienen menos falsos positivos y pueden delegar el escaneo con confianza. Cada búsqueda se convierte en una unidad repetible que otros pueden entender y reutilizar.
La precisión en la deduplicación viene de la estructura: Duplicate Searches pequeñas y enfocadas dan más control que una configuración única y compleja.
Para los detalles de configuración de campos, tipos de coincidencia y filtros, consulta La guía completa para Duplicate Searches en Dedupely.

 O regístrate con Google