


TL;DR
- A desduplicação torna-se complexa quando registos não partilham dados fiáveis suficientes para provar uma correspondência.
- Diferentes grupos de registos, como regiões ou filiais, frequentemente precisam de critérios diferentes.
- O maior obstáculo em escala é ter confiança para fusionar milhares de registos de uma só vez.
- Quanto mais campos fortes correspondem, como nome, email e empresa, mais seguro é o merge automático.
- Dedupely permite-lhe definir critérios para cada grupo e fazer merge em massa de milhares de registos com controlo total.
Quando as equipas descrevem um projeto de deduplicação complexo, muitas vezes começam pelo tamanho da base de dados. O tamanho torna a limpeza mais pesada.
A nossa equipa de sucesso do cliente vê as partes mais difíceis nos dados: quanto é que os registos se sobrepõem e quantos grupos precisam das suas próprias regras. A maior delas é saber com que certeza pode mesclar milhares de uma vez. Neste artigo, vai ver o que torna uma limpeza complexa, o que apenas parece complexo e como criar confiança para mesclar em escala.
Complexo, ou apenas grande?
| Complica uma limpeza | Parece complexo mas geralmente não é |
|---|---|
| Dados sobrepostos insuficientes para provar que dois registos são o mesmo | Um conjunto de dados massivo com duplicados fáceis de identificar |
| Grupos de registos que precisam de critérios de correspondência diferentes ou campos personalizados específicos da sua equipa | Vários objetos, como Companies, Contacts e Deals |
| Regras campo a campo para qual valor vence, ou comportamento de fusão que a CRM não suporta | Várias equipas com interesse nos dados |
| Dados em idiomas ou caracteres que a pessoa que faz a limpeza não consegue ler facilmente | Associações confusas entre registos |
O que torna um projeto de desduplicação complexo
Vários destes voltam a uma pergunta: consegue saber, apenas pelos registos, que dois deles são o mesmo? Eis o que a nossa equipa de sucesso vê mais frequentemente.
Dados sobrepostos insuficientes
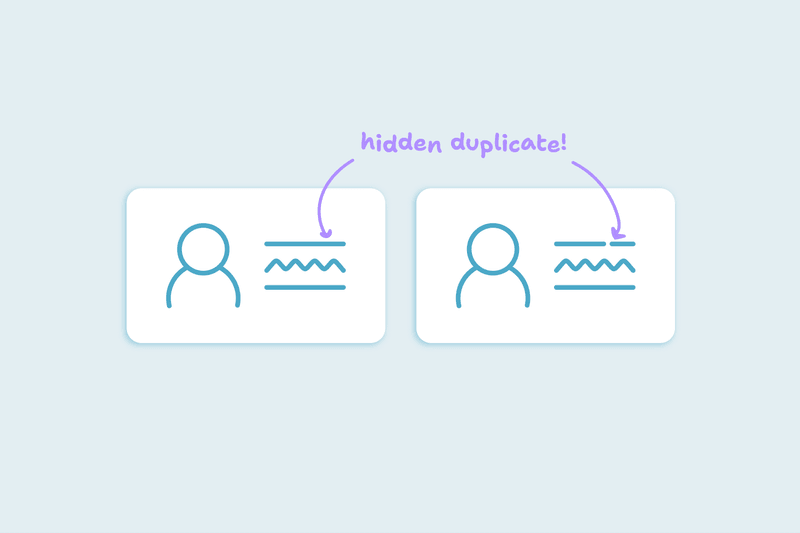
Por vezes, uma equipa sabe que dois registos são a mesma pessoa. Conhecem o cliente pessoalmente, ou têm informações que existem fora do CRM.
Mas nada nos registos o prova. Um tem nome e telefone, o outro tem nome e email pessoal. É muito difícil construir uma busca assim, porque a evidência não está nos dados.
Grupos diferentes precisam de critérios diferentes
Regiões, cidades, fases de negócio, escalões de subscrição, fontes e campanhas podem precisar cada uma da sua própria definição de duplicado. Muita dessa lógica encaixa agora numa pesquisa.
Às vezes não funciona. Quando certos grupos nunca devem ser correspondidos um com o outro, precisam de pesquisas separadas.
Uma empresa com sub-regiões é um bom exemplo. Para algumas equipas, apenas o domínio principal importa, seja qual for o seu sufixo. Para outras, cada sub-região deve ser sempre mantida separada.
Campos personalizados e critérios específicos da equipa
Cada equipa utiliza o seu CRM de forma ligeiramente diferente. Alguns dependem de campos personalizados para decidir o que torna dois registos iguais, como um número de conta interno.
Esses critérios têm de ser compreendidos antes de alguém poder correspondê-los. Ninguém fora da equipa sabe o que significam por defeito.
Regras para qual valor vence
Numa limpeza simples, uma regra abrange todos os campos. Numa complexa, diferentes campos precisam de regras diferentes. O proprietário pode vir de um registo, o número de telefone do mais recente, e o ciclo de vida do mais avançado.
Algumas equipas querem comportamento de consolidação que o CRM não suporta nativamente. Por exemplo, preferem o registo mais recente, mas o CRM mantém o antigo. Essa incompatibilidade causa disputas de propriedade.
Precisa de uma conversa cuidadosa sobre o que é possível antes da limpeza começar.
Dados ilegíveis
As barreiras linguísticas tornam cada decisão mais lenta. Quando os registos usam um idioma ou caracteres que a pessoa que limpa não consegue ler facilmente, é difícil julgar se dois nomes correspondem.
O que parece complexo mas geralmente não é
Um grande volume de dados torna a decisão mais assustadora. Com critérios claros, porém, 10.000 duplicatas podem ser mais fáceis de limpar do que uma base de dados muito menor e desorganizada. Uma base de dados com um milhão de registos pode ser gerível quando as suas duplicatas são fáceis de identificar.
Vários objetos, como Empresas HubSpot, Contactos Salesforce ou Negócios Pipedrive, são geralmente trabalhados um de cada vez. Por vezes, a ordem é importante, e quando é depende da situação.
Várias equipas com interesse nos dados não contribuem tanto quanto as pessoas esperam. A maioria das limpezas tem uma pessoa a geri-las e dois ou três backups normalmente é suficiente.
As associações são mantidas quando os registos se unem. Por vezes, os duplicados são parte da razão pela qual as associações parecem confusas.
A confiança é o fator mais importante
A parte assustadora de uma limpeza grande é clicar merge em 5.000 ou 10.000 registos. Ninguém consegue analisar tantos um a um, portanto a decisão tem de assentar nos critérios.
Precisa de atingir o ponto em que vê os critérios e diz: sim, são definitivamente duplicados, e é seguro mesclar. Até aí, as equipas tendem a esperar, e os duplicados ficam.
60% das equipas param o seu projeto de deduplicação por medo de perder dados ou quebrar sistemas ligados.
Encontrem os critérios juntos
Os critérios são frequentemente descobertos ao longo do caminho. O trabalho começa por compreender os dados, depois questiona o que a equipa considera um duplicado.
De lá, estreita os critérios até a equipa estar confortável a unificar em massa. Cada ronda exclui um tipo de correspondência incerta, até que sobra um conjunto com o qual todos concordam.
As regras têm de decidir da mesma forma sempre
Não pode decidir 5.000 mesclagens uma de cada vez. As regras para qual valor vence têm de tomar a mesma decisão em milhares de mesclagens.
É por isso que ajuda testar as regras num grupo pequeno primeiro. Pré-visualize o resultado mesclado para alguns conjuntos que representem seus casos extremos, depois aplique as mesmas regras ao resto.
Quando automatizar: três ou quatro campos de correspondência forte
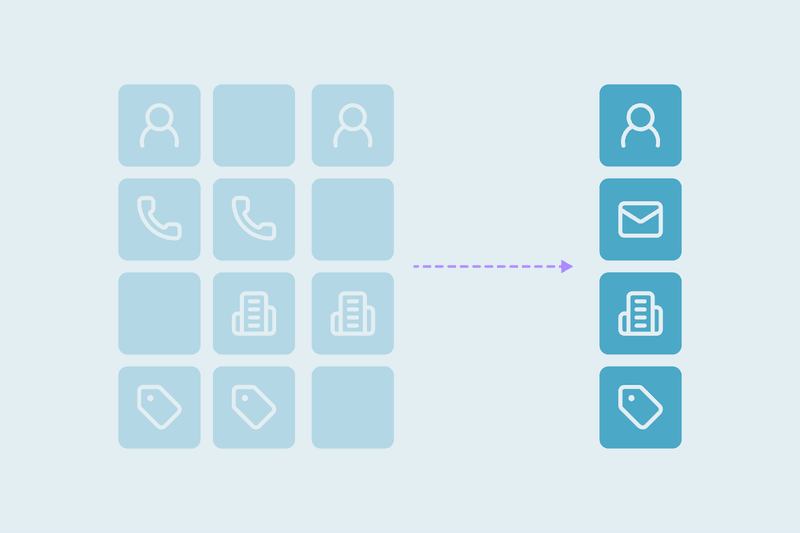
Mais informação confiável em comum = mais confiança. Nome, apelido, email e empresa todos iguais é muito mais seguro automatizar do que apenas nome.
Em geral, três ou quatro campos de correspondência forte dão-lhe muito mais confiança para ativar automação. Com menos, envie as correspondências para revisão.
Em resumo, quanto mais certa a correspondência, mais pode automatizar ou fazer merge em massa. Quanto mais for um caso especial, mais necessita de revisão manual.
Correspondência alimentada por IA ou buscas que constrói?
Ambos têm um lugar, dependendo do caso. O matching alimentado por AI encontra padrões complexos, por vezes aqueles que não pensaria procurar.
As Duplicate Searches que constrói encontram os duplicados que sabe precisar. A utilidade depende de quão bem conhece os seus duplicados.
Como Dedupely o ajuda a mesclar milhares de registos com confiança
No Dedupely, consegue construir Duplicate Searches com critérios diferentes para cada grupo de registos e usar correspondência com IA ao lado delas. Define regras para qual valor vence em cada campo e pré-visualiza cada fusão, para poder fazer bulk merge das correspondências que tem a certeza e enviar o resto para revisão. O nosso guia para planeamento de um projeto de deduplicação CRM mostra como abordar uma limpeza de grande escala em fases.
Veja quais dos seus duplicados são seguros para mesclar em massa
Construa confiança antes de fazer bulk merge
O que torna uma limpeza complexa está nos dados: registos que partilham pouco demais para provar uma correspondência, grupos que precisam de critérios próprios, e campos que precisam de regras próprias para qual valor vence. Mais importante que tudo isto é a confiança, ter certeza bastante para mesclar milhares de registos de uma vez.
Essa confiança vem de critérios acordados e refinados, até que cada correspondência seja uma que faria merge sem verificação. Com três ou quatro campos em concordância, o merge em massa e automático ficam seguros, e os casos extremos restantes recebem revisão manual.
Perguntas frequentes
Como lida com desduplicação complexa à escala?
Comece por compreender os dados e acordar no que a sua equipa considera um duplicado. Refine os critérios até que todos se sintam à vontade para fundir em massa, e defina regras que decidem consistentemente qual valor ganha. Funda automaticamente as correspondências onde vários campos concordam, e envie os casos extremos para revisão.
O que torna a deduplicação de CRM complexa?
Várias coisas, geralmente nos dados em si: registos podem não partilhar informação suficiente para provar que são iguais. Grupos podem precisar de critérios de correspondência diferentes, campos personalizados podem ter significado específico da equipa, e campos podem precisar de regras próprias para qual valor prevalece. Dados em idiomas desconhecidos e a confiança para fazer merge de milhares de uma vez aumentam a dificuldade.
É mais difícil desduplicar uma base de dados CRM grande?
Não necessariamente. O tamanho torna a decisão mais intimidante, mas com critérios claros, 10.000 duplicados podem ser mais fáceis de limpar do que uma base de dados muito menor e desordenada. O que importa mais é se os registos partilham informações suficientemente fiáveis para provar que são a mesma pessoa ou empresa.
Quantos campos devem corresponder antes de automatizar a fusão?
Como regra geral, três ou quatro campos de correspondência forte. Primeiro nome, último nome, e-mail e empresa a corresponder é muito mais seguro automatizar do que dois registos que partilham apenas o primeiro e último nome. Com menos campos fortes, envie correspondências para revisão antes de fazer merge.
Deve usar correspondência de IA ou as suas próprias regras para encontrar duplicados?
Use ambos, dependendo do caso: correspondência com IA encontra padrões complexos que pode não pensar em procurar. Regras que cria encontram os duplicados que já conhece e funcionam melhor quando conhece bem os seus dados. Quanto mais certa uma correspondência, mais pode fundir em massa.

 Ou registe-se com o Google

 Pipedrive Marketplace












