


TL;DR
- Deduplizierung wird komplex, wenn Datensätze nicht genug zuverlässige Daten teilen, um eine Übereinstimmung zu beweisen.
- Unterschiedliche Gruppen von Datensätzen, wie Regionen oder Tochtergesellschaften, erfordern oft unterschiedliche Kriterien.
- Die größte Herausforderung bei großen Datenmengen ist das Vertrauen, tausende Datensätze auf einmal zusammenzuführen.
- Je mehr kritische Felder übereinstimmen, desto sicherer ist automatische Zusammenführung.
- Dedupely lässt Sie Kriterien für jede Gruppe festlegen und Tausende Datensätze mit voller Kontrolle zusammenführen.
Wenn Teams komplexe Deduplizierungs-Projekte beschreiben, beginnen sie oft mit der Datenmenge. Das macht die Bereinigung schwerer erscheinen.
Unser Customer Success Team sieht die schwierigeren Teile in den Daten: wie viele Datensätze sich überschneiden und wie viele Gruppen eigene Regeln brauchen. Der größte Punkt ist, wie sicher Sie sein können, bevor Sie Tausende auf einmal zusammenführen. In diesem Beitrag erfahren Sie, was eine Bereinigung komplex macht, was sich nur komplex anfühlt, und wie Sie Vertrauen aufbauen, um in großem Maßstab zusammenzuführen.
Komplex oder einfach nur umfangreich?
| Macht eine Bereinigung kompliziert | Wirkt kompliziert, ist es aber meist nicht |
|---|---|
| Zu wenig überlappende Daten, um zu beweisen, dass zwei Records identisch sind. | Ein großer Datenbestand mit leicht zu erkennenden Duplikaten |
| Datensatzgruppen, die unterschiedliche Abgleichskriterien benötigen oder teamspezifische Felder erfordern | Mehrere Objekte wie Unternehmen, Kontakte und Deals |
| Feldweise Regeln für gewinnende Werte oder Zusammenführungsverhalten, das das CRM nicht unterstützt | Mehrere Teams mit Mitsprache in den Daten |
| Daten in Sprachen oder Zeichen, die der Aufräumende nicht leicht liest | Verwirrte Verknüpfungen zwischen Datensätzen |
Was ein Deduplication-Projekt komplex macht
Viele davon laufen auf eine Frage hinaus: Können Sie allein aus den Datensätzen erkennen, dass zwei davon gleich sind? Das sehen unsere Customer-Success-Teams am häufigsten.
Nicht genug übereinstimmende Daten
Manchmal weiß ein Team, dass zwei Datensätze die gleiche Person sind. Sie kennen den Kunden persönlich oder haben Informationen außerhalb des CRM.
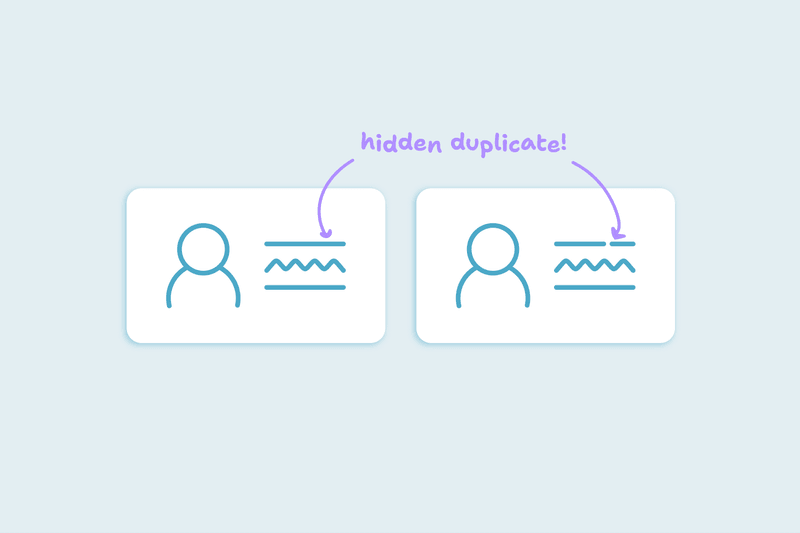
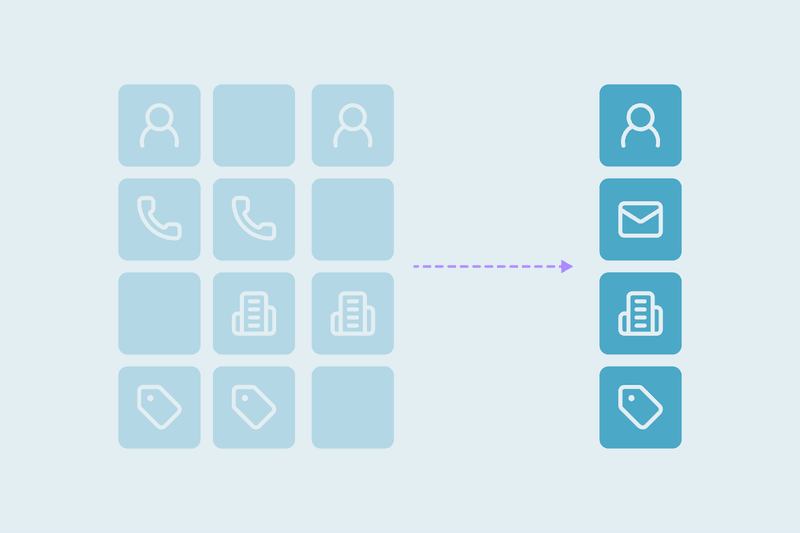
Aber nichts in den Datensätzen beweist dies. Der eine hat einen Namen und eine Telefonnummer, der andere einen Namen und eine private E-Mail. Das ist schwer um eine Suche zu bauen, da der Beweis nicht in den Daten steckt.
Verschiedene Gruppen brauchen verschiedene Kriterien
Regionen, Städte, Deal-Phasen, Abonnement-Stufen, Quellen und Kampagnen können jeweils eigene Duplikat-Definitionen brauchen. Viel dieser Logik passt jetzt in eine Suche.
Manchmal nicht. Wenn bestimmte Gruppen niemals zusammengefasst werden dürfen, benötigen sie separate Suchen.
Ein Unternehmen mit Subregionen ist ein gutes Beispiel. Für manche Teams zählt nur die Hauptdomain. Für andere muss jede Subregion getrennt bleiben.
Benutzerdefinierte Felder und teamspezifische Kriterien
Jedes Team nutzt sein CRM anders. Manche verlassen sich auf benutzerdefinierte Felder, um zu entscheiden, was zwei Datensätze gleich macht, etwa eine interne Kontonummer.
Diese Kriterien müssen verstanden werden, bevor jemand sie abgleichen kann. Niemand außerhalb des Teams weiß, was sie standardmäßig bedeuten.
Regeln für die Wertgewichtung
Einfache Aufräumen: eine Regel für alle Felder. Komplexe: jedes Feld eine eigene. Eigentümer aus einem Datensatz, Telefon aus dem neuesten, Lebenszyklusphase aus dem fortgeschrittensten.
Einige Teams wünschen sich Merge-Verhalten, das das CRM nicht unterstützt, also alles außer der Standard-Einstellung. Ein Team möchte beispielsweise, dass der neueste Datensatz gewinnt, aber das CRM behält standardmäßig den älteren. Diese Unstimmigkeit führt zu Eigentümerkonflikten.
Bevor die Bereinigung beginnt, ist ein sorgfältiges Gespräch darüber erforderlich, was möglich ist.
Daten, die schwer zu lesen sind
Sprachbarrieren verlangsamen jede Entscheidung. Mit Zeichen, die schwer zu lesen sind, lässt sich schwer beurteilen, ob zwei Namen übereinstimmen.
Was kompliziert aussieht, aber einfach ist
Ein großer Datensatz macht die Entscheidung beklemmender wirken. Mit klaren Kriterien sind aber 10.000 Duplikate oft leichter zu bereinigen als eine viel kleinere, ungeordnete Datenbank. Eine Datenbank mit einer Million Datensätzen wird überschaubar, wenn ihre Duplikate leicht zu erkennen sind.
Mehrere Objekte wie HubSpot Companies, Salesforce Contacts oder Pipedrive Deals werden normalerweise einzeln bearbeitet. Manchmal spielt die Reihenfolge eine Rolle, je nach Fall.
Mehrere beteiligte Teams tragen weniger bei als erwartet. Normalerweise leitet eine Person die Bereinigung, und zwei oder drei Vertreter reichen aus.
Zuordnungen bleiben beim Mergen erhalten. Manchmal sind die Duplikate der Grund, warum die Zuordnungen unordentlich aussehen.
Zuverlässigkeit ist der wichtigste Faktor
Das Angespannte: 5.000 oder 10.000 Datensätze zusammenführen. Niemand kann alle überprüfen, also muss die Entscheidung auf den Kriterien basieren.
Sie müssen zu dem Punkt gelangen, an dem Sie die Kriterien überprüfen und sagen: Ja, das sind definitiv Duplikate und sicher zusammenzuführen. Solange das nicht geschieht, warten die Teams ab und die Duplikate bleiben bestehen.
60% der Teams stoppen ihr Deduplication-Projekt aus Angst vor Datenverlust oder Unterbrechung verbundener Systeme.
Definieren Sie die Kriterien gemeinsam
Kriterien entstehen oft während der Arbeit. Zunächst verstehen Sie die Daten, dann fragen Sie das Team, was ein Duplikat ist.
Grenzen Sie die Kriterien dann ein, bis das Team sich beim Bulk-Merge sicher fühlt. Bei jeder Runde schließen Sie einen unsicheren Matching-Typ aus, bis nur noch Übereinstimmungen bleiben, auf die sich alle einigen können.
Regeln müssen jedes Mal gleich entscheiden
Sie können 5.000 Zusammenführungen nicht einzeln entscheiden. Die Merge Rules müssen über Tausende Zusammenführungen hinweg die gleiche Entscheidung treffen.
Daher ist es ratsam, die Regeln zuerst an einer kleinen Gruppe zu testen. Zeigen Sie eine Vorschau des zusammengeführten Ergebnisses für einige Sätze an, die Ihre Grenzfälle repräsentieren, und wenden Sie dann die gleichen Regeln auf den Rest an.
Wann Sie automatisieren: drei oder vier starke Abgleichfelder
Je mehr verlässlich überlappende Informationen vorliegen, desto sicherer können Sie sein. Wenn Vorname, Nachname, E-Mail und Unternehmen übereinstimmen, ist Automatisierung viel sicherer als bei zwei Personen mit gleichem Vor- und Nachnamen.
Als Faustregel gilt: Drei oder vier starke Abgleichfelder geben Ihnen viel mehr Sicherheit, um Automatisierung zu aktivieren. Bei weniger Feldern leiten Sie die Abgleichungen zur Überprüfung weiter.
Je sicherer die Übereinstimmung, desto mehr können Sie automatisieren. Je zweifelhafter, desto mehr braucht es manuelle Überprüfung.
KI-gestütztes Matching oder von Ihnen erstellte Suchen?
Beide haben ihren Platz, je nach Fall. KI-gestütztes Matching findet komplexe Muster, manchmal solche, auf die Sie nicht denken würden.
Suchen, die Sie selbst erstellen, finden die Duplikate, die Sie benötigen. Wie nützlich sie sind, hängt davon ab, wie gut Sie Ihre Duplikate kennen.
Wie Dedupely Ihnen hilft, tausende Datensätze mit Zuversicht zusammenzuführen
In Dedupely können Sie Duplicate Searches mit unterschiedlichen Kriterien für verschiedene Datensatzgruppen erstellen und KI-gestützte Abgleiche einsetzen. Sie definieren, welcher Wert bei jedem Feld bestehen bleibt, und können jede Zusammenführung vorab betrachten. So können Sie sich sicher ein Bulk Merge durchführen und unsichere Datensätze zur Überprüfung freigeben. Unsere Anleitung zu Planung eines CRM-Deduplizierungsprojekts zeigt, wie Sie eine große Bereinigung in Phasen angehen.
Sehen Sie, welche Ihrer Duplikate sich sicher zusammenfassen lassen
Vertrauen aufbauen, bevor Sie Bulk Merge durchführen
Was eine Bereinigung komplex macht, liegt in den Daten: Records mit zu wenig Übereinstimmung, Gruppen mit eigenen Kriterien, Felder mit eigenen Merge Rules für den Gewinnwert. Das Wichtigste ist Vertrauen: Sicherheit genug, um Tausende von Records auf einmal zu mergen.
Dieses Vertrauen entsteht aus Kriterien, auf die sich Ihr Team geeinigt und verfeinert hat, bis jede Übereinstimmung eine ist, die Sie ohne Überprüfung zusammenführen würden. Bei drei oder vier übereinstimmenden Feldern wird Bulk- und automatisches Merging sicher, und die verbleibenden Ausnahmefälle werden manuell überprüft.
Häufige Fragen
Wie handhaben Sie Deduplizierung in großem Maßstab?
Verstehen Sie die Daten und einigen Sie sich auf eine Duplikat-Definition. Verfeinern Sie die Kriterien, bis alle beim Bulk-Merging sicher sind. Legen Sie Gewinnregeln fest, die jedes Mal gleich entscheiden. Mergen Sie automatisch bei mehreren starken Feldübereinstimmungen. Grenzfälle zur manuellen Überprüfung.
Was macht CRM-Deduplizierung komplex?
Verschiedenes, meist in den Daten selbst: Datensätze teilen möglicherweise nicht genug Information. Gruppen brauchen unterschiedliche Kriterien, Custom Fields haben Team-spezifische Bedeutung, Felder brauchen eigene Regeln. Daten in unbekannten Sprachen und die Sicherheit, tausende auf einmal zusammenzuführen, erschweren es zusätzlich.
Ist eine große CRM-Datenbank schwerer zu deduplizieren?
Nicht unbedingt. Mit klaren Kriterien lassen sich 10.000 Duplikate leichter bereinigen als eine kleine DB. Entscheidend: Datensätze müssen genug Information teilen.
Wie viele Felder sollten übereinstimmen, bevor Sie das Merging automatisieren?
Grundsätzlich sollten drei oder vier starke Abgleichfelder verwendet werden. Wenn Vorname, Nachname, E-Mail und Unternehmen alle übereinstimmen, ist es viel sicherer zu automatisieren als zwei Datensätze, die nur Vorname und Nachname teilen. Bei weniger starken Feldern sollten Übereinstimmungen vor dem Merge zur Überprüfung gesendet werden.
KI-Matching oder eigene Regeln zum Finden von Duplikaten?
Nutzen Sie beide, je nach Situation: KI-gestützte Abgleichung findet komplexe Muster, die Sie vielleicht übersehen. Ihre eigenen Regeln finden bekannte Duplikate und funktionieren am besten, wenn Sie Ihre Daten kennen. Grundsatz: Je sicherer der Abgleich, desto mehr können Sie Massenoperationen durchführen.

 Oder mit Google registrieren

 Pipedrive Marketplace












