


TL;DR
- Deduplicering blir komplicerad när poster inte delar tillräckligt med tillförlitlig data för att bevisa en matchning.
- Olika grupper av poster, som regioner eller dotterbolag, behöver ofta olika kriterier.
- Det största hindret i stor skala är att ha tillräckligt förtroende för att slå samman tusentals poster på en gång.
- Ju fler starka fält som matchar, som namn, e-post och företag, desto säkrare är automatisk sammanslagning.
- Dedupely låter dig ställa in kriterier för varje grupp och Bulk Merge tusentals poster med fullständig kontroll.
När team beskriver ett komplext dedupliceringsprojekt börjar de ofta med storleken på databasen. Storlek gör en rensning kännas tyngre.
Vår kundsupport ser ofta de svåraste problemen i data: hur mycket poster överlappar och hur många grupper som behöver sina egna regler. Det viktigaste är hur säker du kan vara innan du slår ihop tusentals poster samtidigt. I det här inlägget får du se vad som gör en rensning komplex, vad som bara känns komplext, och hur du bygger självförtroende för storskalig sammanslutning.
Komplex eller bara stor?
| Gör en rensning komplex | Känns komplext men brukar inte vara det |
|---|---|
| För lite gemensamma data för att bevisa att två poster är densamma | En stor datamängd med dubbletter som är lätta att identifiera |
| Grupper av poster som behöver olika matchningsvillkor eller anpassade fält för ditt team | Flera objekt, som Företag, Kontakter och Affärer |
| Regler för vinnarvärde per fält, eller sammanslagningsbeteende som CRM:et inte stöder | Flera team som är involverade i datan |
| Data på språk eller tecken som den som rensar inte lätt kan läsa | Förvirrade kopplingar mellan poster |
Vad gör ett dedupliceringsprojekt komplext
Flera av dessa kommer tillbaka till en fråga: kan du säga, bara från posterna, att två av dem är samma? Här är vad vårt kundsupportteam ser mest.
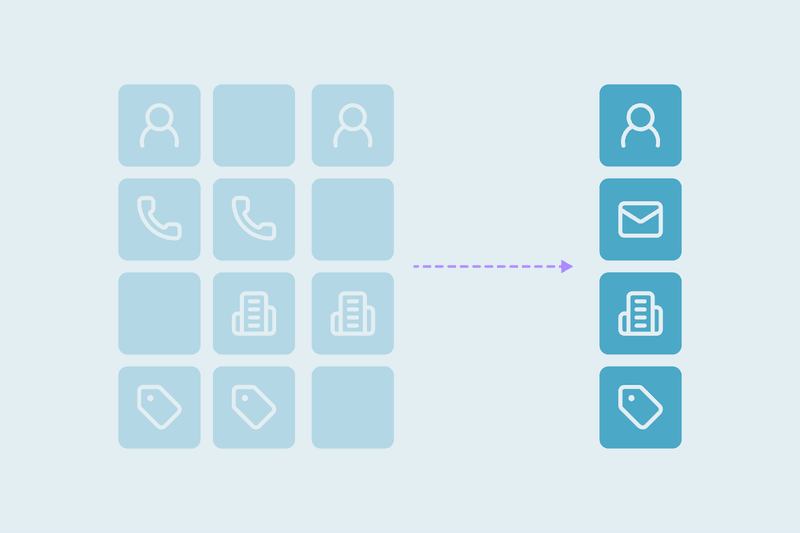
Inte nog med överlappande data
Ibland vet ett team att två poster är samma person. De känner kunden personligen eller har information som finns utanför CRM:en.
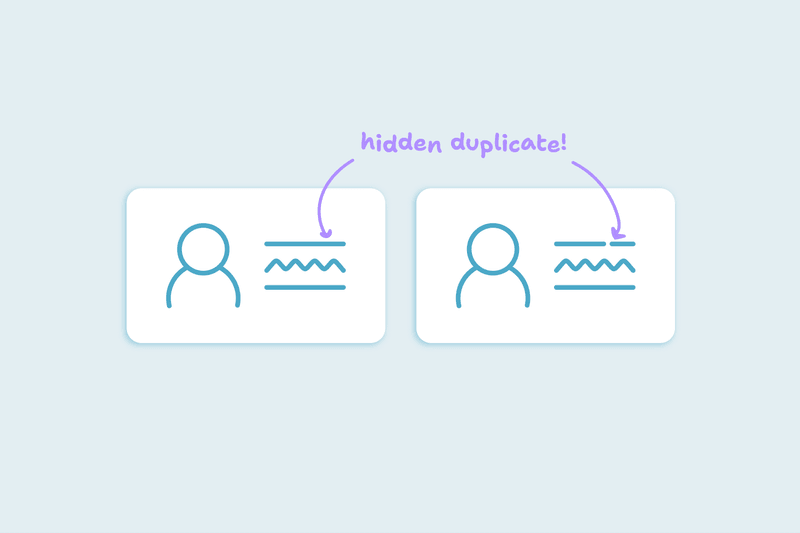
Men ingenting i posterna bevisar det. Den ena har namn och telefon, den andra namn och personlig e-post. Det är svårt att bygga en sökning runt det, för beviset finns inte i data.
Olika grupper behöver olika kriterier
Regioner, städer, affärstadier, prenumerationsnivåer, källor och kampanjer kan var och en behöva sin egen definition av en dubblett. Mycket av denna logik passar nu i en sökning.
Ibland fungerar det inte. När vissa grupper aldrig får matchas med varandra behöver de separata sökningar.
Ett företag med underregioner är ett bra exempel. För vissa team spelar bara huvuddomänen roll, oavsett suffix. För andra måste varje underregion alltid hållas åtskild.
Anpassade fält och teamspecifika kriterier
Varje team använder sin CRM lite olika. Vissa förlitar sig på anpassade fält för att avgöra vilka poster som är desamma, till exempel ett internt kontonummer.
Dessa kriterier måste förstås innan någon kan använda dem för matchning. Ingen utanför ditt team förstår deras betydelse automatiskt.
Regler för vilket värde som vinner
I en enkel rensning täcker en regel alla fält. I en komplex behöver olika fält olika regler. Ägaren kan komma från en post, telefonnumret från den senaste, och livscykelstadiet från det mest avancerade.
Vissa team vill också ha sammanfogningsbeteende som CRM:et inte stöder, vilket vanligtvis är allt som inte är CRM:ets standard. Ett team vill till exempel att den senaste posten ska vinna, men CRM:et behåller den äldre som standard. Den diskrepansen slutar i tvister om ägarskap.
Det kräver ett noggrant samtal om vad som är möjligt innan saneringen börjar.
Data som du inte lätt kan läsa
Språkbarriärer gör varje beslut långsammare. När poster använder ett språk eller tecken som personen som städar inte lätt kan läsa, är det svårt att bedöma om två namn matchar.
Vad som verkar komplext men oftast inte är
En gigantisk datamängd gör beslutet känsligare. Med tydliga kriterier är det dock enklare att rengöra 10 000 dubbletter än en mycket mindre, rörig databas. En databas med en miljon poster kan hanteras när dess dubbletter är lätta att identifiera.
Flera objekt, som HubSpot Companies, Salesforce Contacts eller Pipedrive Deals, hanteras vanligtvis ett i taget. Ibland spelar ordningen roll, och när det är så beror på sammanhanget.
Flera team med ansvar för datan bidrar inte så mycket som man förväntar sig. Flesta städningar hanteras av en person, och två eller tre backup räcker normalt.
Associationer bevaras när poster slås samman. Ibland är dubbletterna en del av anledningen till att associationer ser röriga ut.
Säkerhet är den viktigaste faktorn
Det skrämmande med en stor rensning är att klicka slå ihop på 5 000 eller 10 000 poster. Ingen kan granska så många en och en, så beslutet måste vila på kriterierna.
Du måste nå den punkt där du tittar på kriterierna och säger: ja, dessa är definitivt dubbletter och de är säkra att slå samman. Tills dess tenderar team att vänta och dubbletter kvarstår.
60 % av teamen slutar sitt dubbletthanteringsprojekt av rädsla för dataförlust eller att bryta anslutna system.
Hitta kriterierna tillsammans
Kriterierna upptäcks ofta under vägen. Arbetet börjar med att förstå uppgifterna, sedan fråga vad laget anser är en dublett.
Därifrån begränsar du kriterierna tills teamet är bekvämt med att slå samman i bulk. Varje omgång utesluter en typ av matchning som folk var osäkra på, tills det som återstår är en mängd som alla håller med om.
Regler måste besluta på samma sätt varje gång
Du kan inte besluta 5 000 sammanfogningar en efter en. Reglerna för vilket värde som vinner måste fatta samma beslut på tusentals sammanfogningar.
Därför är det bra att testa reglerna på en liten grupp först. Förhandsgranska det sammanfogade resultatet för några exempel som representerar dina kantfall, sedan använd samma regler på resten.
När du ska automatisera: tre eller fyra starka matchningsfält
Ju mer pålitlig överlappande information du har, desto säkrare kan du automatisera. Namn, e-post och företag som matchar är mycket säkrare än två personer med samma för- och efternamn.
Som regel ger tre eller fyra starka matchningsfält mycket större självförtroende att slå på automation. Med färre, skicka matchningarna till granskning.
Kort sagt, ju säkrare matchningen, desto mer kan du automatisera eller bulk merge. Ju mer det är ett kantfall, desto mer behöver en person granska det.
AI-driven matchning eller sökningar du bygger själv?
Båda har sin plats, beroende på fallet. AI-driven matchning hittar komplexa mönster, ibland sådana du inte skulle tänka att söka efter.
De sökningar du bygger själv hittar de dubbletter du vet behöver slås samman. Hur användbara de är beror på hur väl du känner dina dubbletter.
Hur Dedupely hjälper dig slå ihop tusentals poster tryggt
I Dedupely kan du skapa Duplicate Searches med olika kriterier för varje grupp poster och använda AI-baserad matchning tillsammans med dem. Du ställer in regler för vilka värden som vinner på varje fält och förhandsgranskar varje sammanslagning, så du kan Bulk Merge de matchningar du är säker på och skicka resten till granskning. Vår guide till planering av ett CRM-dedupliceringsprojekt visar hur du genomför en stor rensning i faser.
Bygg förtroende innan du slår ihop massvis
En rengöring blir komplex på grund av data: poster som delar för lite för att bevisa en matchning, grupper som behöver egna kriterier och fält som behöver egna regler för vilket värde som gäller. Det viktigaste är dock förtroendet: att vara säker nog för att sammanfoga tusentals poster på en gång.
Det förtroendet kommer från kriterier som ditt team har enats om och förbättrat tills varje matchning kan slås samman utan granskning. Med tre eller fyra starka fält som överensstämmer blir massiv och automatisk sammanslåning säker, och de kantfall som återstår får granskning.
Vanliga frågor
Hur hanterar du komplex deduplicering i stor skala?
Börja med att förstå datan och komma överens om vad ditt team anser är en dublett. Begränsa kriterierna tills alla är bekväma att slå samman i bulk och ställ in regler för vinnande värden som beslutar på samma sätt varje gång. Slå automatiskt samman matchningar där flera starka fält överensstämmer och skicka kantfall till granskning.
Vad gör CRM-deduplikering komplex?
Flera saker, vanligtvis i själva uppgifterna: poster kanske inte delar tillräckligt information för att bevisa att de är samma. Grupper kan behöva olika matchningskriterier, anpassade fält kan bära teamspecifik betydelse, och fält kan behöva egna regler för vilka värden som gäller. Data på främmande språk och självförtroendet att slå ihop tusentals på en gång lägger till det.
Är det svårare att deduplicera en större CRM-databas?
Inte nödvändigtvis. Storleken gör beslutet kännas skrämmande, men med tydliga kriterier kan 10 000 dubbletter vara lättare att rensa än en mycket mindre, rörig databas. Vad som spelar större roll är om posterna delar tillräckligt pålitlig information för att bevisa att de är samma person eller företag.
Hur många fält bör matcha innan du automatiserar sammanslagning?
Som en allmän regel, tre eller fyra starka matchningsfält. Förnamn, efternamn, email och företag som alla matchar är mycket säkrare att automatisera än två poster som bara delar förnamn och efternamn. Med färre starka fält skickar du matchningar för granskning innan de slås samman.
Bör du använda AI-matchning eller dina egna regler för att hitta dubbletter?
Använd både, beroende på fallet: AI-driven matchning kan hitta komplexa mönster du kanske inte tänkt på. Regler du själv bygger hittar de dubbletter du redan vet om, och fungerar bäst när du känner dina data väl. Oavsett hur säker en matchning är, desto mer kan du sammanfoga i bulk.

 Eller registrera dig med Google

 Pipedrive Marketplace












