


TL;DR
- La deduplicación se complica cuando los registros no comparten datos confiables suficientes para confirmar una coincidencia.
- Los distintos grupos de registros, como regiones o filiales, a menudo necesitan criterios diferentes.
- El mayor obstáculo a escala es tener la confianza suficiente para fusionar miles de registros a la vez.
- Cuantos más campos importantes coincidan, como nombre, correo y empresa, más segura es la fusión automática.
- Dedupely te permite establecer criterios para cada grupo y fusionar en lote miles de registros con control total.
Cuando los equipos describen un proyecto de deduplicación complejo, a menudo comienzan con el tamaño de la base de datos. El tamaño hace que la limpieza parezca más pesada.
Nuestro equipo de éxito ve las partes difíciles: cuánto se superponen los registros y cuántos grupos necesitan reglas propias. Lo más importante es cuánta confianza tienes antes de fusionar miles a la vez. En este artículo verás qué hace que una limpieza sea compleja, qué solo lo parece, y cómo ganar seguridad para fusionar a escala.
¿Complejo o simplemente grande?
| Complica la limpieza | Parece complejo pero generalmente no. |
|---|---|
| Demasiados pocos datos coincidentes para probar que dos registros son iguales | Un gran conjunto de datos con duplicados claros. |
| Grupos de registros que necesitan criterios de coincidencia distintos o campos personalizados específicos de tu equipo | Varios objetos, como Empresas, Contactos y Tratos |
| Reglas campo a campo sobre qué valor prevalece, o comportamiento de combinación que el CRM no admite | Varios equipos con intereses en los datos |
| Datos en idiomas o caracteres que la persona que limpia no puede leer fácilmente | Asociaciones confusas entre registros |
Qué hace que un proyecto de deduplicación sea complejo
Muchos de estos se reducen a una pregunta: ¿puedes saber, solo con los registros, que dos son iguales? Esto es lo que ve más nuestro equipo de éxito del cliente.
Datos insuficientes para solapar
A veces un equipo sabe que dos registros son la misma persona. Conocen al cliente personalmente, o tienen información que está fuera del CRM.
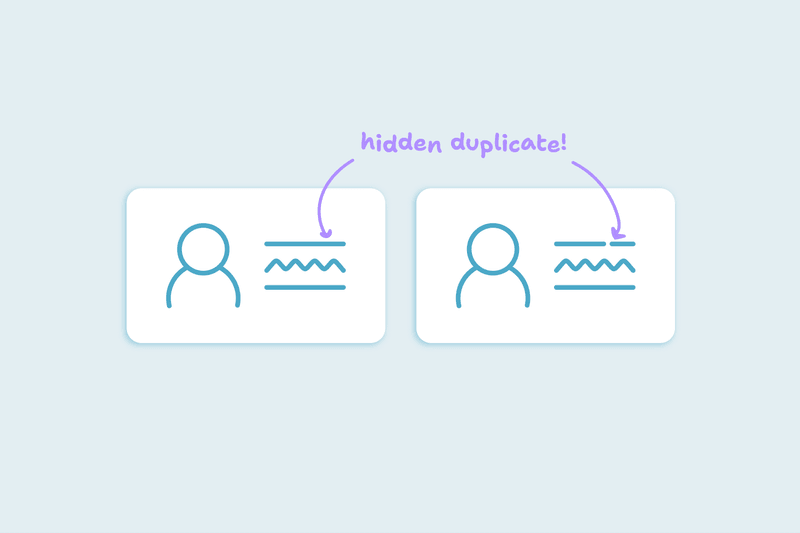
Pero nada dentro de los registros lo prueba. Uno tiene nombre y teléfono, el otro tiene nombre y correo personal. Es muy difícil construir una búsqueda alrededor de eso, porque la evidencia no está en los datos.
Diferentes grupos necesitan criterios diferentes
Regiones, ciudades, etapas de trato, niveles de suscripción, fuentes y campañas pueden necesitar su propia definición de duplicado. Mucha de esa lógica cabe ahora en una búsqueda.
A veces no. Cuando ciertos grupos nunca deben combinarse, necesitan búsquedas separadas.
Una empresa con subregiones es un buen ejemplo. Para algunos equipos, solo importa el dominio principal, sea cual sea su sufijo. Para otros, cada subregión debe mantenerse siempre separada.
Campos personalizados y criterios específicos del equipo
Cada equipo usa su CRM de forma diferente. Algunos confían en campos personalizados para decidir qué registros son iguales, como números de cuenta internos.
Esos criterios deben entenderse antes de usarlos. Nadie fuera del equipo entiende qué significan por defecto.
Reglas para cuál valor gana.
En una limpieza simple, una regla cubre todos los campos. En una compleja, cada campo necesita su propia regla. El propietario puede venir de un registro, el teléfono del más reciente, y la etapa del ciclo de vida de la más avanzada.
Algunos equipos también quieren un comportamiento de fusión que el CRM no soporta, que suele ser cualquier cosa que no sea la predeterminada del CRM. Por ejemplo, un equipo quiere que gane el registro más nuevo, pero el CRM mantiene el antiguo por defecto. Ese desajuste termina en disputas de propiedad.
Requiere una conversación cuidadosa sobre lo que es posible antes de que comience la limpieza.
Datos que no se pueden leer fácilmente
Las barreras del idioma ralentizan cada decisión. Cuando los registros usan un idioma o caracteres que la persona que limpia no puede leer fácilmente, es difícil juzgar si dos nombres coinciden.
Lo que suena complejo pero no lo es
Un conjunto de datos masivo hace que la decisión parezca aterradora. Con criterios claros, 10.000 duplicados pueden ser más fáciles de limpiar que una base de datos mucho más pequeña y desordenada. Una base de datos con un millón de registros puede ser manejable cuando sus duplicados son fáciles de identificar.
Varios objetos, como Empresas en HubSpot, Contactos en Salesforce u Ofertas en Pipedrive, se trabajan uno a uno. A veces el orden importa, según el caso.
Varios equipos con interés en los datos no aportan tanto como se espera. La mayoría de limpiezas las gestiona una sola persona, y dos o tres respaldos suelen ser suficientes.
Las asociaciones se mantienen cuando se combinan registros. A veces los duplicados son parte de la razón por la que las asociaciones se ven desordenadas.
La confianza es el factor clave
La parte intimidante de una limpieza grande es hacer clic en fusionar 5.000 o 10.000 registros. Nadie puede revisarlos uno a uno, así que la decisión debe basarse en los criterios.
Necesitas llegar al punto donde digas: sí, estos son duplicados y es seguro combinarlos. Hasta entonces los equipos esperan y los duplicados persisten.
El 60% de los equipos detiene su proyecto de deduplicación por miedo a perder datos o romper sistemas conectados.
Encuentra los criterios juntos
Los criterios se descubren a menudo en el camino. El trabajo comienza entendiendo los datos, luego preguntando qué el equipo considera un duplicado.
A partir de ahí, ajustas los criterios hasta que el equipo se sienta cómodo fusionando en lote. Cada ronda excluye un tipo de coincidencia que no tenían clara, hasta que queda un conjunto con el que todos están de acuerdo.
Las reglas deben decidir de la misma manera cada vez
No puedes decidir 5.000 combinaciones una a una. Las reglas sobre qué valor gana deben tomar la misma decisión en miles de combinaciones.
Por eso conviene probar las reglas en un grupo pequeño. Obtén vista previa de algunos conjuntos que representen tus casos extremos y aplica las mismas reglas al resto.
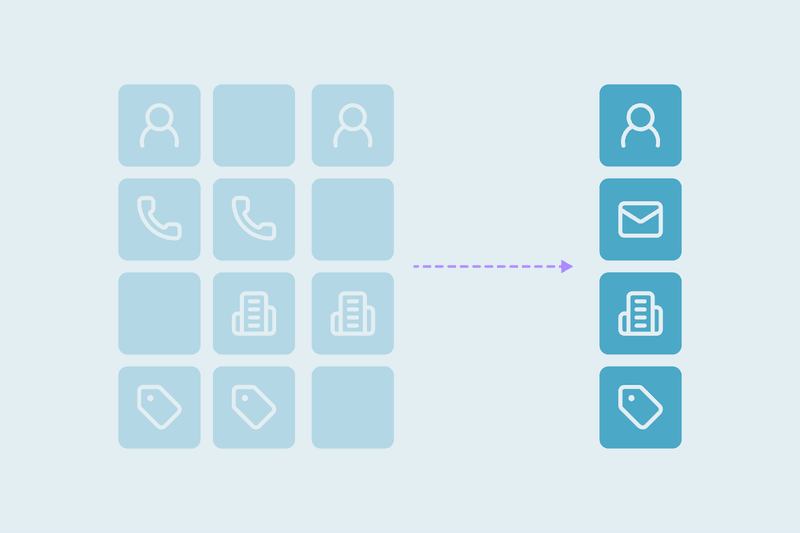
Cuándo automatizar: tres o cuatro campos de coincidencia fuertes.
Cuanta más información coincidente tengas, más seguro puedes estar. Si coinciden nombre, apellido, correo y empresa, es mucho más seguro automatizar que si dos personas comparten nombre y apellido.
Por regla general, tres o cuatro campos de coincidencia sólidos te dan mucha más confianza para activar la automatización. Con menos, envía las coincidencias a revisión.
En resumen, cuanto más segura la coincidencia, más puedes automatizar o fusionar en lote. Cuanto más sea un caso especial, más necesita que lo revise una persona.
¿Coincidencia con IA o búsquedas que construyes tú?
Ambos tienen su lugar, dependiendo del caso. La búsqueda impulsada por IA encuentra patrones complejos, a veces los que no pensarías buscar.
Las búsquedas que creas tú mismo encuentran los duplicados que sabes que necesitas encontrar. Lo útiles que sean depende de cuán bien conoces tus duplicados.
Cómo Dedupely te ayuda a fusionar miles de registros con confianza
En Dedupely, creas Duplicate Searches con criterios distintos para cada grupo de registros y usas coincidencia basada en IA. Estableces reglas para qué valor gana en cada campo y previsualizas cada fusión, así que puedes Bulk Merge las coincidencias seguras y enviar el resto a revisión. Nuestra guía de planificación de un proyecto de deduplicación de CRM muestra cómo abordar una limpieza grande en fases.
Identifica cuáles duplicados son seguros para fusionar en lote
Crea confianza antes de hacer una Bulk Merge
Lo que hace compleja una limpieza está en los datos: registros que comparten demasiado poco para probar una coincidencia, grupos que necesitan sus propios criterios, y campos que necesitan sus propias reglas para el valor ganador. Por encima de todo está la confianza, estar lo bastante seguro para fusionar miles de registros a la vez.
Esa confianza viene de criterios que tu equipo ha acordado y refinado hasta que cada coincidencia es una que fusionarías sin revisar. Con tres o cuatro campos sólidos en acuerdo, la fusión en lote y automática se vuelve segura, y los casos excepcionales restantes reciben revisión humana.
Preguntas frecuentes
¿Cómo gestionar la deduplicación compleja a gran escala?
Empieza por entender los datos y acordar qué considera duplicado tu equipo. Estrecha los criterios hasta que todos estén cómodos fusionando en lote, e establece reglas sobre qué valor prevalece que decidan igual siempre. Fusiona automáticamente donde varios campos fuertes concuerdan, y envía los casos límite a revisión.
¿Qué hace compleja la deduplicación de CRM?
Varios factores, generalmente en los datos: los registros pueden no compartir suficiente información para probar que son iguales. Los grupos pueden necesitar criterios de búsqueda diferentes, los campos personalizados pueden tener significado específico del equipo, y cada campo puede necesitar su propia regla para determinar qué valor gana. Los datos en idiomas desconocidos y la confianza para fusionar miles a la vez lo complican aún más.
¿Es más difícil desduplicar una base de datos de CRM grande?
No necesariamente. El tamaño hace que parezca más arriesgado, pero con criterios claros, 10,000 duplicados pueden ser más fáciles de limpiar que una base de datos más pequeña pero desorganizada. Lo importante es si los registros comparten información confiable para probar que son la misma persona o empresa.
¿Cuántos campos deben coincidir antes de automatizar la fusión?
Por regla general, tres o cuatro campos de coincidencia sólida. Nombre, apellido, correo y empresa coincidiendo es más seguro automatizar que solo nombre y apellido compartidos. Con menos campos sólidos, envía coincidencias a revisión antes de fusionar.
¿Deberías usar coincidencia de IA o tus propias reglas para hallar duplicados?
Usa ambas según el caso. La coincidencia impulsada por IA encuentra patrones que podrías no buscar. Las reglas propias encuentran duplicados que ya conoces y funcionan mejor si dominas bien los datos. Cuanto más segura la coincidencia, más puedes fusionar en lote.

 O regístrate con Google

 Pipedrive Marketplace












