


Résumé
- La déduplication devient complexe quand les enregistrements ne partagent pas assez de données fiables pour prouver une correspondance.
- Différents groupes d'enregistrements, comme les régions ou filiales, ont souvent besoin de critères différents.
- Le plus grand obstacle à grande échelle : avoir assez de confiance pour fusionner des milliers d'enregistrements à la fois.
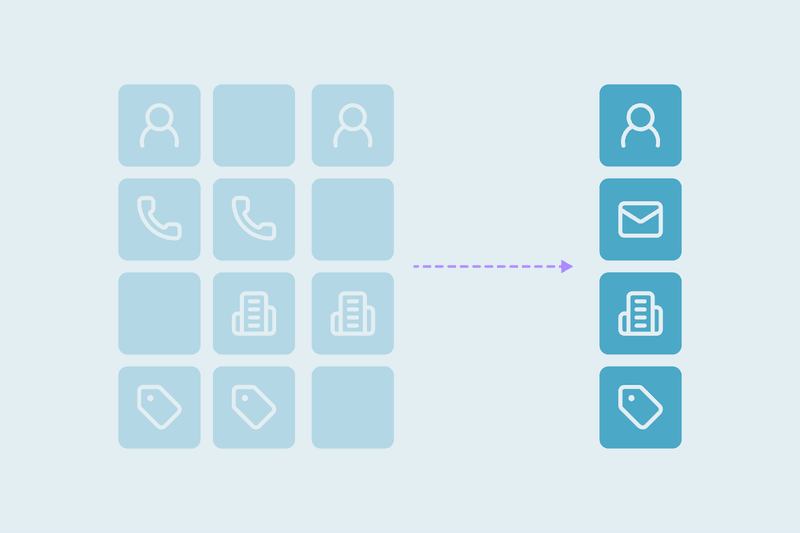
- Plus il y a de champs forts qui correspondent, comme le nom, l'email et l'entreprise, plus la fusion automatique est sûre.
- Dedupely vous permet de définir les critères par groupe et fusionner en masse des milliers d'enregistrements.
Quand les équipes décrivent un projet de déduplication complexe, elles commencent souvent par la taille de la base de données. La taille rend le nettoyage plus lourd.
Notre équipe de succès client voit les aspects délicats: le chevauchement d'enregistrements et les groupes qui ont besoin de règles propres. L'essentiel est la confiance avant de fusionner des milliers d'enregistrements à la fois. Découvrez ce qui rend un nettoyage complexe, ce qui ne l'est qu'en apparence, et comment générer la confiance pour fusionner à grande échelle.
Complexe ou simplement volumineux ?
| Rend un nettoyage complexe | Semble complexe mais généralement ne l'est pas |
|---|---|
| Données insuffisantes pour prouver qu'il s'agit du même enregistrement | Un grand volume de données avec des doublons faciles à identifier |
| Groupes d'enregistrements nécessitant des critères de correspondance différents, ou champs personnalisés de votre équipe | Plusieurs objets, comme Companies, Contacts et Deals |
| Règles champ par champ pour les valeurs gagnantes, ou comportements de fusion non supportés par le CRM | Plusieurs équipes ayant un intérêt dans les données |
| Données dans des langues ou des caractères que la personne nettoyant ne peut pas facilement lire | Des associations désordonnées entre les enregistrements |
Ce qui rend un projet de déduplication complexe
Plusieurs d'entre eux reviennent à une question : pouvez-vous dire, à partir des enregistrements seuls, que deux d'entre eux sont identiques ? Voici ce que notre équipe de succès clients voit le plus souvent.
Pas assez de données en commun
Parfois, une équipe sait que deux enregistrements sont la même personne. Elle connaît le client personnellement ou possède des infos qui n'existent pas dans le CRM.
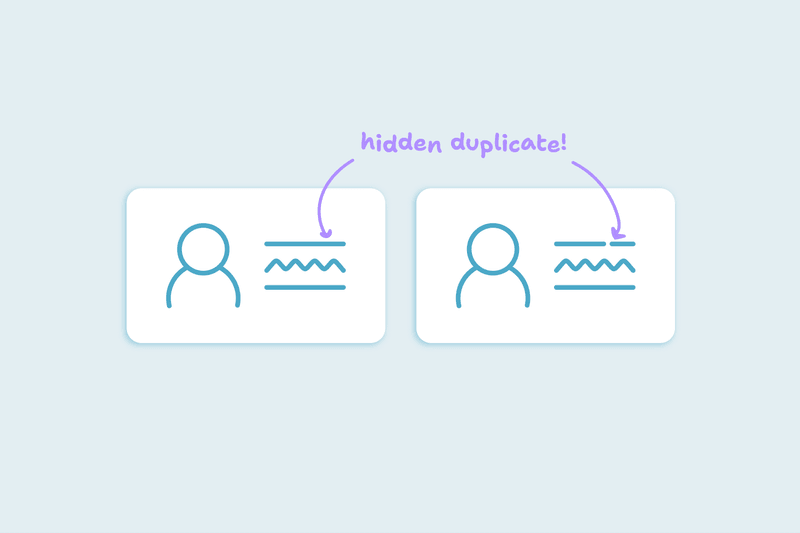
Mais rien dans les enregistrements ne le prouve. L'un a un nom et un numéro, l'autre a un nom et un email personnel. C'est très difficile à construire une recherche là-dessus, car la preuve n'est pas dans les données.
Les différents groupes ont besoin de critères différents
Les régions, villes, étapes commerciales, niveaux d'abonnement, sources et campagnes peuvent chacun nécessiter leur propre définition d'un doublon. Beaucoup de cette logique peut maintenant se faire en une seule recherche.
Pas toujours. Quand certains groupes ne doivent jamais être appairés ensemble, ils ont besoin de recherches séparées.
Une entreprise avec des sous-régions est un bon exemple. Pour certaines équipes, seul le domaine principal importe, quel que soit son suffixe. Pour d'autres, chaque sous-région doit toujours rester séparée.
Champs personnalisés et critères spécifiques à l'équipe
Chaque équipe utilise son CRM légèrement différemment. Certaines s'appuient sur des champs personnalisés pour déterminer ce qui fait que deux enregistrements sont identiques, comme un numéro de compte interne.
Ces critères doivent être compris avant que chacun puisse les utiliser pour une correspondance. Personne en dehors de l'équipe ne sait ce qu'ils signifient par défaut.
Règles déterminant la valeur conservée
Dans un nettoyage simple, une règle couvre tous les champs. Dans un complexe, différents champs ont besoin de règles différentes. Le propriétaire peut venir d'un enregistrement, le numéro de téléphone du plus récent, et l'étape du cycle de vie du plus avancé.
Certaines équipes veulent un comportement de fusion que le CRM ne supporte pas. Par exemple, vous voulez que le plus récent l'emporte, mais le CRM garde l'ancien par défaut. Cette différence crée des conflits de propriété.
Une conversation prudente sur ce qui est possible doit précéder le nettoyage.
Données illisibles
Les barrières linguistiques ralentissent chaque décision. Si les enregistrements utilisent une langue ou des caractères difficiles à lire, il est dur de juger si deux noms correspondent.
Ce qui semble complexe mais ne l'est généralement pas
Un ensemble de données massif rend la décision plus effrayante. Avec des critères clairs, 10 000 doublons peuvent être plus faciles à nettoyer qu'une base de données beaucoup plus petite et désorganisée. Une base avec un million d'enregistrements peut être gérée quand ses doublons sont faciles à identifier.
Plusieurs objets, comme les Sociétés HubSpot, les Contacts Salesforce ou les Transactions Pipedrive, se traitent généralement un par un. Parfois, l'ordre compte, selon le contexte.
Plusieurs équipes concernées par les données n'ajoutent pas autant que les gens l'espèrent. La plupart des nettoyages sont gérés par une personne, et deux ou trois suppléants suffisent normalement.
Les associations sont conservées lors de la fusion des enregistrements. Parfois, les doublons contribuent au désordre des associations.
La confiance est le facteur clé
La partie effrayante d'un grand nettoyage est de fusionner 5 000 ou 10 000 enregistrements. Personne ne peut examiner autant d'entre eux un par un, donc la décision doit reposer sur les critères.
Vous devez atteindre le point où vous regardez les critères et dites: oui, ce sont définitivement des doublons et sûrs à fusionner. Jusqu'à là, les équipes attendent et les doublons restent.
60 % des équipes arrêtent leur projet de dédoublonnage par peur de perdre des données ou de casser les systèmes liés.
Trouvez les critères ensemble
Les critères sont souvent découverts en cours de route. Le travail commence par comprendre les données, puis en demandant ce que l'équipe considère comme un doublon.
À partir de là, vous affinez les critères jusqu'à ce que l'équipe soit à l'aise pour fusionner en masse. Chaque tour exclut un type de correspondance dont les gens n'étaient pas sûrs, jusqu'à ce qu'il ne reste qu'un ensemble sur lequel tout le monde est d'accord.
Les règles doivent décider de la même façon à chaque fois
Vous ne pouvez pas décider 5 000 fusions une par une. Les règles déterminant la valeur gagnante doivent prendre la même décision pour des milliers de fusions.
Testez les règles sur un petit groupe d'abord. Prévisualisez le résultat pour quelques ensembles représentant vos cas limites, puis appliquez les mêmes règles au reste.
Quand automatiser : trois ou quatre champs de correspondance forts
Plus l'information commune est fiable, plus vous êtes confiant. Quand prénom, nom, email et entreprise correspondent, c'est bien plus sûr à automatiser que deux personnes partageant un prénom et nom.
En règle générale, trois ou quatre champs de correspondance solides vous donnent bien plus confiance pour activer l'automatisation. Avec moins, envoyez les correspondances à révision.
En résumé, plus la correspondance est certaine, plus vous pouvez l'automatiser ou la fusionner en masse. Inversement, les cas limites exigent une révision manuelle.
Correspondance assistée par l'IA ou recherches que vous construisez vous-même ?
Les deux ont leur place selon le cas. La correspondance par IA détecte des motifs complexes, y compris ceux auxquels on ne penserait pas.
Les recherches que vous créez trouvent les doublons que vous visez. Leur utilité dépend de votre compréhension de vos données.
Comment Dedupely vous aide à fusionner des milliers d'enregistrements en toute confiance
Dans Dedupely, créez des recherches de doublons avec des critères différents pour chaque groupe et complétez avec la correspondance par IA. Définissez les règles pour les valeurs gagnantes par champ, prévisualisez chaque fusion. Fusionnez en masse les correspondances sûres, envoyez le reste en examen. Notre guide planifier un projet de déduplication CRM montre comment aborder un grand nettoyage par phases.
Gagnez en confiance avant de fusionner en masse
La complexité du nettoyage réside dans les données : enregistrements partageant peu de similitudes, groupes nécessitant des critères propres, champs nécessitant des règles propres. Mais surtout : la confiance pour fusionner des milliers d'enregistrements à la fois.
Cette confiance provient de critères que votre équipe a convenus et affinés jusqu'à ce que vous puissiez fusionner toute correspondance sans vérification. Avec trois ou quatre champs solides concordants, la fusion en masse et automatique devient sûre, et les cas limites restants reçoivent un examen humain.
Questions fréquentes
Comment gérez-vous le dédoublonnage complexe à grande échelle ?
Commencez par comprendre les données et convenir de ce que votre équipe considère comme un doublon. Affinez les critères jusqu'à ce que tous soient à l'aise pour fusionner en masse, et établissez des règles pour les valeurs retenues qui décident pareil à chaque fois. Fusionnez automatiquement quand plusieurs champs forts concordent, et envoyez les cas limites en révision.
Qu'est-ce qui rend la déduplication CRM complexe ?
Plusieurs choses, généralement dans les données elles-mêmes : les enregistrements peuvent ne pas partager assez d'informations pour prouver qu'ils sont les mêmes. Les groupes peuvent avoir besoin de critères de correspondance différents, les champs personnalisés peuvent avoir une signification propre à l'équipe, et les champs peuvent avoir besoin de leurs propres règles pour savoir quelle valeur gagne. Les données dans des langues inhabituelles et la confiance pour fusionner des milliers à la fois y contribuent.
Une grande base de données CRM est-elle plus difficile à dédupliquer ?
Pas nécessairement. La taille rend la décision plus effrayante, mais avec des critères clairs, 10 000 doublons peuvent être plus faciles à nettoyer qu'une base de données beaucoup plus petite et désordonnée. Ce qui compte davantage est de savoir si les enregistrements partagent suffisamment d'informations fiables pour prouver qu'ils sont la même personne ou entreprise.
Combien de champs doivent correspondre avant d'automatiser la fusion ?
En général, trois ou quatre champs solides pour la correspondance. Quand le prénom, nom, email et entreprise correspondent tous, c'est beaucoup plus sûr à automatiser que si seulement le prénom et nom correspondent. Avec moins de champs solides, envoyez les correspondances à la révision avant fusion.
Faut-il utiliser la correspondance IA ou vos propres règles pour trouver les doublons ?
Utilisez les deux selon le cas : la correspondance assistée par IA trouve les schémas complexes que vous ne penseriez pas à chercher. Les règles que vous créez trouvent les doublons que vous connaissez déjà, et fonctionnent mieux quand vous maîtrisez vos données. Plus une correspondance est certaine, plus vous pouvez la fusionner en masse.

 Ou inscrivez-vous avec Google

 Pipedrive Marketplace












