


TL;DR
- La deduplicazione diventa complessa quando i record non condividono abbastanza dati affidabili per provare una corrispondenza.
- Diversi gruppi di record, come regioni o filiali, spesso richiedono criteri diversi.
- L'ostacolo maggiore è la fiducia necessaria per unire migliaia di record contemporaneamente.
- Più campi importanti corrispondono (nome, email, azienda), più sicura è la fusione automatica.
- Dedupely consente di impostare criteri per ogni gruppo e unire in massa migliaia di record con controllo totale.
Quando i team descrivono un progetto di deduplicazione complesso, spesso iniziano dalla dimensione del database. La dimensione rende la pulizia più pesante.
Il nostro team di customer success vede le difficoltà nascoste nei dati: quanto i record si sovrappongono e quanti gruppi hanno bisogno di regole personalizzate. La sfida più grande è avere la certezza prima di unire migliaia di record contemporaneamente. In questo articolo scoprirai cosa rende complessa una ripulitura, cosa solo sembra complessa, e come acquistare fiducia per unire su larga scala.
Complesso, o semplicemente grande?
| Rende complessa la pulizia | Sembra complesso ma di solito non lo è |
|---|---|
| Troppi pochi dati sovrapposti per provare che due record sono uguali | Un dataset massiccio con duplicati facili da identificare. |
| Gruppi di record che richiedono criteri di corrispondenza diversi o campi personalizzati specifici del tuo team | Più oggetti, come Companies, Contacts e Deals |
| Regole campo per campo per scegliere quale valore vince, o comportamenti di unione che il CRM non supporta | Diversi team con una parte in gioco nei dati |
| Dati in lingue o caratteri che chi pulisce non può leggere facilmente | Associazioni disordinate tra record |
Cosa rende complesso un progetto di deduplicazione
Molti di questi tornano a una domanda: puoi dire dai soli record che due di loro sono gli stessi? Ecco cosa rileva più spesso il nostro team di customer success.
Dati sovrapposti insufficienti
A volte un team sa che due record sono la stessa persona. Conoscono il cliente personalmente, oppure hanno informazioni che vivono fuori dal CRM.
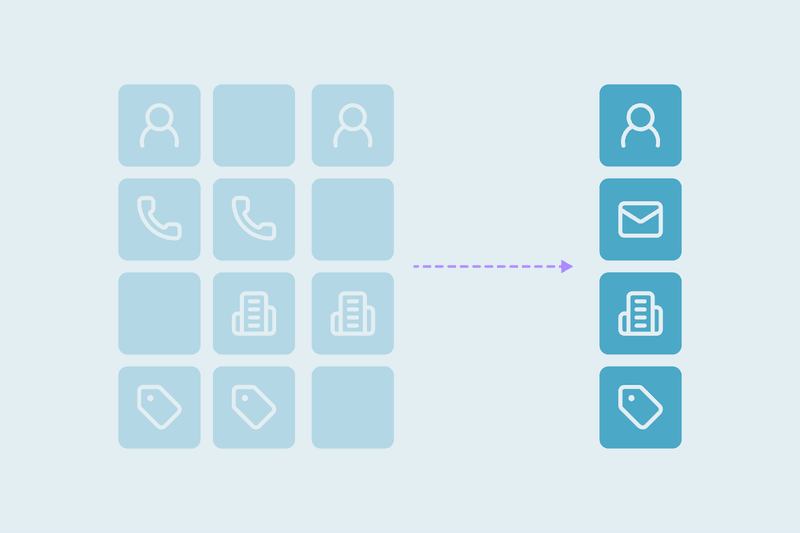
Ma nulla nei record lo prova. Uno ha nome e telefono, l'altro nome e email personale. È difficile costruire una ricerca su questo, perché le prove non sono nei dati.
Gruppi diversi necessitano criteri diversi
Regioni, città, fasi di trattativa, livelli di abbonamento, fonti e campagne possono ognuno avere la propria definizione di duplicato. Molta di questa logica rientra ora in una sola ricerca.
A volte no. Quando determinati gruppi non devono mai essere abbinati l'uno all'altro, hanno bisogno di ricerche separate.
Un'azienda con sottoregioni è un buon esempio. Per alcuni team, conta solo il dominio principale, indipendentemente dal suffisso. Per altri, ogni sottoregione deve essere sempre tenuta separata.
Campi personalizzati e criteri specifici del team
Ogni team usa il suo CRM un po' diversamente. Alcuni si affidano a campi personalizzati per decidere cos'è un duplicato, come un numero di account interno.
I criteri devono essere compresi prima di usarli. Nessuno al di fuori del team sa cosa significano per impostazione predefinita.
Regole per quale valore prevale
In una pulizia semplice, una regola copre ogni campo. In una complessa, campi diversi richiedono regole diverse. Il proprietario potrebbe provenire da un record, il numero di telefono dal più recente e la fase del ciclo di vita da quella più avanzata.
Alcuni team vogliono anche un comportamento di unione che il CRM stesso non supporta, cioè di solito qualsiasi cosa che non sia l'impostazione predefinita del CRM. Ad esempio, un team vuole che il record più recente vinca, ma il CRM mantiene quello più vecchio per impostazione predefinita. Quella mancata corrispondenza finisce in controversie sulla proprietà.
Ha bisogno di una conversazione attenta su ciò che è possibile prima che la pulizia inizi.
Dati difficili da leggere
Le barriere linguistiche rallentano ogni decisione. Quando i record usano una lingua o caratteri che la persona che pulisce non può leggere facilmente, è difficile giudicare se due nomi corrispondono.
Quello che sembra complesso ma di solito non lo è
Un dataset enorme rende la decisione più intimidatoria. Con criteri chiari, però, 10.000 duplicati possono essere più facili da pulire di un database piccolo e disordinato. Un database con un milione di record diventa gestibile quando i duplicati sono facili da identificare.
Molti oggetti, come HubSpot Companies, Salesforce Contacts o Pipedrive Deals, di solito si elaborano uno alla volta. A volte l'ordine conta e dipende dal caso.
Diversi team con interessi nei dati non contribuiscono tanto quanto ci si aspetta. La maggior parte delle pulizie ha una persona che le gestisce: normalmente due o tre backup sono sufficienti.
Le associazioni si conservano quando i record si uniscono. A volte i duplicati sono la causa di associazioni disordinate.
La confidenza è il fattore più importante
La parte spaventosa di una pulizia su larga scala è cliccare fusione su 5.000 o 10.000 record. Nessuno può revisionarli uno per uno, quindi la decisione deve basarsi sui criteri.
Devi raggiungere il punto dove guardi i criteri e dici: sì, sono decisamente duplicati e sicuri da unire. Fino ad allora, i team aspettano e i duplicati rimangono.
Il 60% dei team interrompe il progetto di deduplicazione per paura di perdere dati o rompere sistemi connessi.
Trova insieme i criteri
I criteri vengono spesso scoperti lungo il percorso. Inizia capendo i dati, poi definisci cosa il team considera un doppione.
Da lì, restringi i criteri finché il team non è a suo agio a fare fusioni in bulk. Ogni round esclude un tipo di corrispondenza di cui le persone non erano sicure, fino a quando ciò che rimane è un insieme su cui tutti sono d'accordo.
Le regole devono decidere nello stesso modo ogni volta
Non puoi decidere 5.000 unioni una per una. Le regole per quale valore vince devono prendere la stessa decisione su migliaia di unioni.
Ecco perché è utile testare le regole su un piccolo gruppo per primo. Visualizza l'anteprima del risultato unito per alcuni set che rappresentano i tuoi casi limite, poi applica le stesse regole al resto.
Quando automatizzare: tre o quattro campi di corrispondenza forti
Più dati sovrapponibili e affidabili, più fiducia puoi avere. Nome, cognome, email e azienda che corrispondono sono molto più sicuri da automatizzare di due persone che condividono il nome.
Come regola generale, tre o quattro campi di corrispondenza forte ti danno molta più fiducia per attivare l'automazione. Con meno, invia le corrispondenze a revisione.
In breve: più è certo il match, più puoi automatizzare o fare merge in blocco. Più è un caso limite, più ha bisogno di revisione manuale.
Corrispondenza basata su AI o Duplicate Searches che crei tu?
Entrambi hanno un posto, a seconda del caso. La corrispondenza basata su IA trova schemi complessi, a volte quelli che non penseresti di cercare.
Le ricerche che create voi stessi trovano i duplicati che sapete di dover trovare. L'utilità dipende da quanto bene conoscete i vostri duplicati.
Come Dedupely ti aiuta a unire migliaia di record con fiducia
In Dedupely, puoi creare Duplicate Searches con criteri diversi per ogni gruppo di record e usare la corrispondenza basata su IA insieme. Imposti regole per quale valore vince su ogni campo, visualizzi un'anteprima di ogni unione, quindi fai Bulk Merge dei record che sei sicuro di unire e invia il resto a Manual Review. La nostra guida a pianificazione di un progetto di deduplicazione CRM mostra come affrontare una pulizia di grandi dimensioni per fasi.
Costruisci fiducia prima di fare un Bulk Merge
Ciò che rende una pulizia complessa risiede nei dati: record che condividono troppo poco per provare una corrispondenza, gruppi che hanno bisogno dei propri criteri, e campi che hanno bisogno delle proprie regole per quale valore vince. Sopra tutto questo è la fiducia, essere abbastanza sicuri da unire migliaia di record contemporaneamente.
Questa fiducia viene dai criteri che il tuo team ha concordato e perfezionato. Con tre o quattro campi forti in comune, l'unione in massa e quella automatica diventano sicure, e i casi limite ricevono revisione manuale.
Domande frequenti
Come affronti la deduplicazione complessa su larga scala?
Inizia comprendendo i dati e accordandoti su cosa il tuo team considera un duplicato. Riduci i criteri finché tutti non si sentono a loro agio a fondere in blocco, e stabilisci regole per quale valore prevalga che decidono allo stesso modo ogni volta. Fondi automaticamente i match dove diversi campi forti concordano, e invia i casi particolari alla revisione.
Cosa rende complessa la deduplicazione del CRM?
Diversi fattori, di solito nei dati stessi: i record potrebbero non condividere abbastanza informazioni per provare che sono uguali. I gruppi potrebbero richiedere criteri di corrispondenza diversi, i campi personalizzati potrebbero avere significati specifici del team e i campi potrebbero richiedere regole proprie per quale valore vince. I dati in lingue sconosciute e la fiducia di unire migliaia di record aggiungono complessità.
Un grande database CRM è più difficile da deduplicare?
Non necessariamente. La dimensione rende la decisione più spaventosa, ma con criteri chiari, 10.000 duplicati possono essere più facili da pulire rispetto a un database molto più piccolo e disordinato. Ciò che conta di più è se i record condividono informazioni affidabili sufficienti per provare che sono la stessa persona o azienda.
Quanti campi devono corrispondere prima di automatizzare l'unione?
Come regola generale, tre o quattro campi di corrispondenza forti. Nome, cognome, email e azienda che corrispondono tutti è molto più sicuro da automatizzare di due record che condividono solo nome e cognome. Con meno campi, invia i match alla revisione prima del merge.
Dovresti usare l'abbinamento AI o le tue stesse regole per trovare i duplicati?
Usa entrambi, a seconda del caso. La corrispondenza basata su AI trova modelli complessi che potresti non cercare. Le tue regole trovano i duplicati che già conosci e funzionano meglio quando conosci bene i dati. Più è certa una corrispondenza, più puoi unirla in blocco.

 Oppure registrati con Google

 Pipedrive Marketplace












