Kundhistoria
Hur ett SaaS-företag sammanslöt över 58 000 duplicerade Pipedrive-poster från sin migrering från HubSpot, med Dedupely
- Pipedrive
- Efter en CRM-migrering
- Efter en listimport
- SaaS

- 58,000+ duplicerade poster slagna samman
- 29,000+ matchningar sammanfogade
- 2.5x hur mycket större organisationslistan blev efter migrationen
En matchning är en uppsättning dubblettsposter sammanslutna till en enda post. Varje matchning innehåller minst två poster, så antalet sammanslutna poster är minst två gånger antalet matchningar.
Varifrån dubletter kom
En prospektlista, importerad mer än en gång
Företaget är en SaaS-verksamhet i Asien-Stillahavet som bygger en inlärningsplattform för arbetsgivare. Dess grundare och VD satte upp försäljningsprocessen själv och migrerade från HubSpot till Pipedrive. Planen var enkel: föra över en prospektlista på cirka 26 000 företag och börja sälja från den.
Migreringen tog mer än ett försök:
- Den första importen kom inte fram som förväntat. Listan exporterades som ett kalkylblad, importerades till Pipedrive, men när datan inte hamnade rätt importerades den på nytt.
- Ett migreringsverktyg flyttade allt igen. Efter det flyttades hela kontot över med ett migreringsverktyg, och det var då dupliceringarna dök upp.
- Varje duplicerad post innehöll olika data. Posten från gamla CRM:et hade den fullständiga adressen, LinkedIn-sidan, antalet anställda och beskrivningen. Andra hade bara ett land, skrivet i olika format.
Resultatet var cirka 64 000 Organisationer där det borde ha funnits omkring 26 000, två och en halv gånger det verkliga antalet.
Vad dupliceringar orsakade
En databas som ingen kunde läsa
Med 64 000 organisationer på skärmen fanns det inget sätt att veta vilka poster som var verkliga. Data för ett enda företag var fördelat över två, tre, fyra och ibland fem poster, var och en innehöll en annan del av informationen. Pipedrive:s duplikatkontroll flaggade omkring 9 000, vilket inte täckte allt.
De bästa uppgifterna måste överleva
Rensningen var tvungen att behålla de mer kompletta uppgifterna från det gamla CRM:et. En sammanslagning som behöll fel post skulle kasta bort exakt det som importen var avsedd att föra över. Det bekymret höll CRM:et oförändrat: efter att ha sett fler dubletter hamna på de första, var det sista grundaren ville var att skapa fler problem innan han fick en klar bild av uppgifterna.
Hur dubbletter löstes
-
1. Matcha på namn, försmala sedan med adressen
Med Dedupely:s customer success-team började grundaren från en sökning på organisationsnamn. Ensamt returnerade namnet cirka 26 000 matcher, för breda för att lita på, eftersom två olika företag kan dela ett namn. Att lägga till adressen med Exact matching minskade det till 4 211 matcher. Att byta adressen till Similar Words på de första tre orden, så små skillnader i hur en adress är skriven inte blockerar en matchning, höjde det till 4 868.
-
2. Behåll posten med mest data
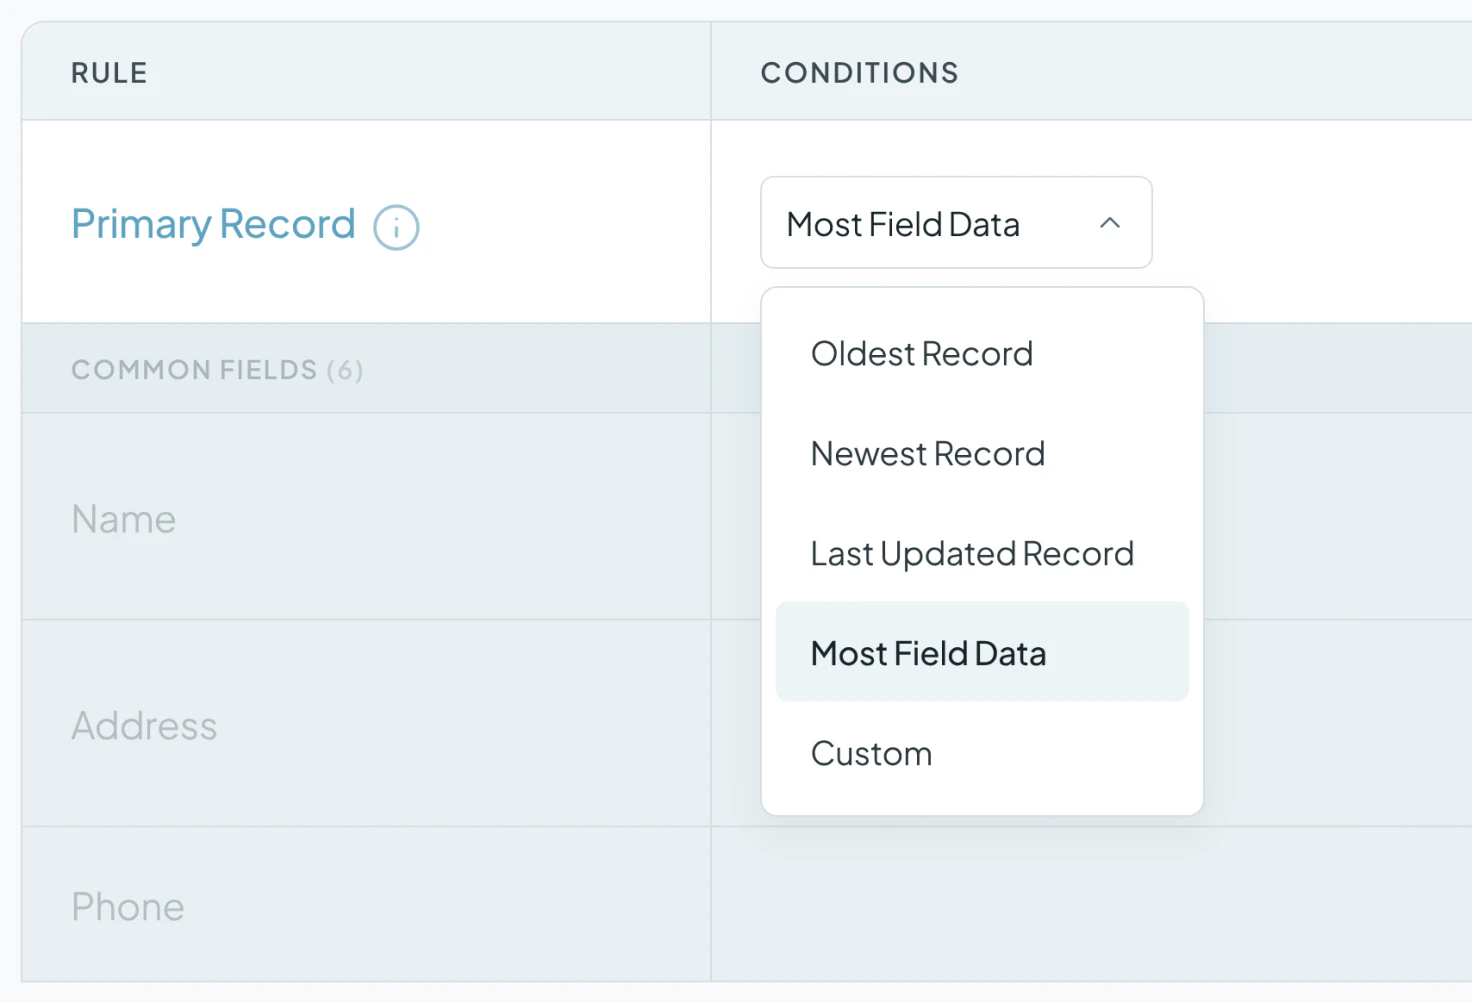
Merge Rules bestämde vad som skulle överleva. Primary Record-regeln ställdes in på Most Field Data, så varje sammanfogning slår samman övriga poster in i den som innehåller mest information. Sammanfogningsförhandsgranskningen visar de vinnande värdena i fetstil innan något händer, och tomma värden skriver aldrig över befintlig data.
En testsammanslagning av två poster, kontrollerad direkt i Pipedrive, bekräftade det: LinkedIn-sidan, antalet anställda och beskrivningen från gamla CRM:et var alla fortfarande där. Efter det slogs matchningar samman i bulk, i vågor, i bakgrunden.
-
3. Om det fortfarande finns dubbletter, ändra matchningsfälten
Efter de första tusentals sammanslagningarna var sökningen nästan tom, men många dubbletter var fortfarande synliga i Pipedrive. Adressen var problemet. Många dubbletter hade en annan adress eller ingen alls, och tomma värden räknas inte som matchning, så sökningen hoppade över dem.
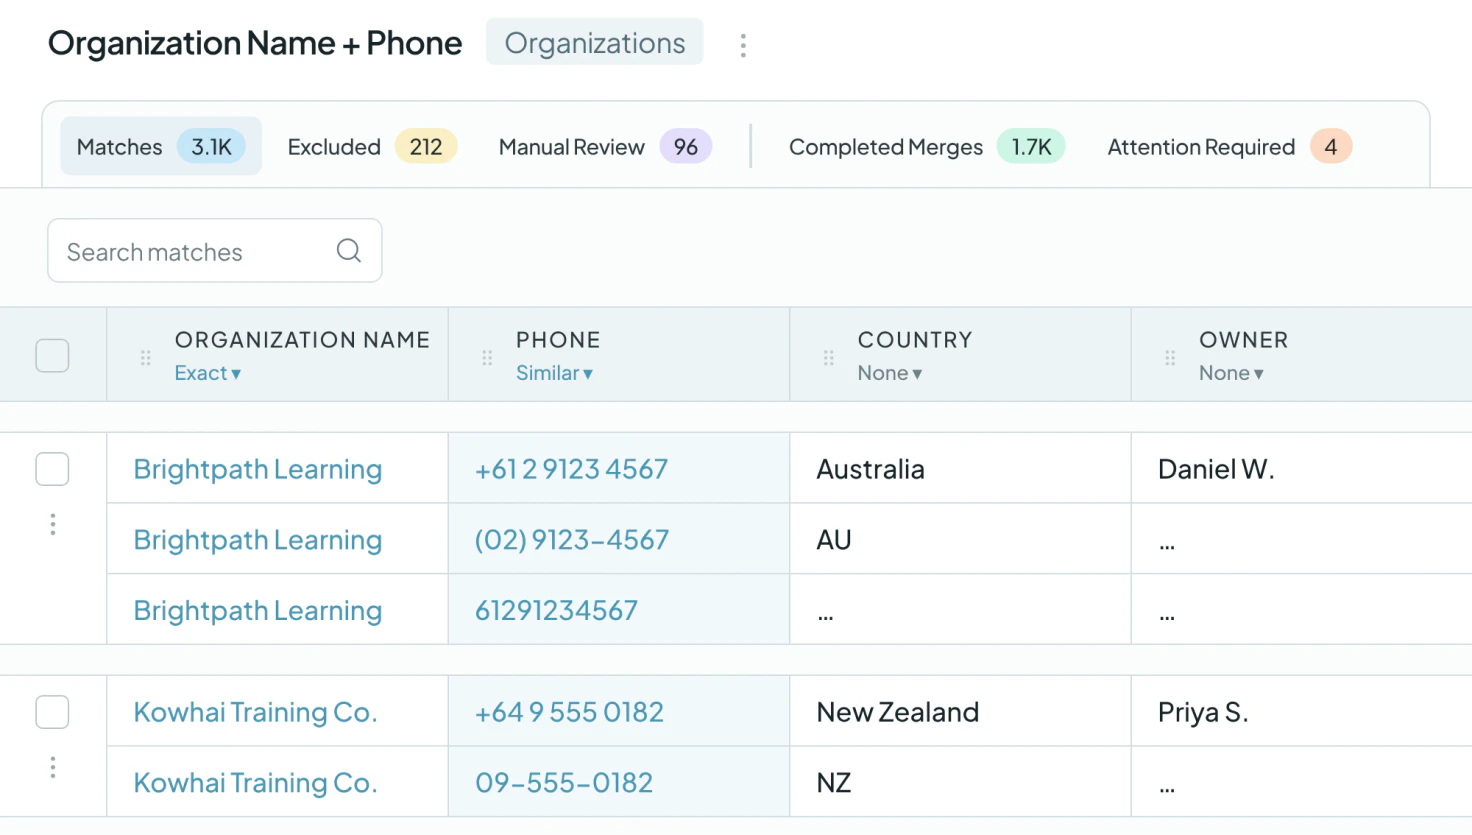
Lösningen var att sluta matcha på adressen och istället matcha på namn och telefon, med Telefon inställd på Similar så landskoder, mellanslag och bindestreck inte kommer i vägen. En testsammanslagning av ett företag med fyra poster lämnade exakt ett i Pipedrive. Från där var planen en serie bulksammanslagningar, var och en fångade en grupp som den föregående missade: namn och telefon, namn och adress igen, sedan de två första orden i namnet.
Vad deduplicering förändrade
58 000+ dubblettposter sammanfogade
Företaget har sammanslutit mer än 29 000 matchningar och kombinerat minst 58 000 dubblettsposter. Idag synkroniserar kontot 26 551 poster.
Från ingen aning till de data den ville ha
I början sa grundaren att han inte hade någon aning om vad han såg. När han såg att den första sammanfogningen behöll LinkedIn-sidan, antalet anställda och beskrivningen från den gamla CRM:en, sa han att det var exakt vad han hade försökt göra. Efter andra omgången sa han att han hade gått tillväga på fel sätt och att sessionen hade hjälpt.

- Kundhistoria 9,092 personmatchningar sammanslutnaPipedrive Rekrytering
Hur ett rekryteringsföretag minskade sin Pipedrive-personlista med en tredjedel efter att en import hade duplicerat nästan alla, med Dedupely
Läs historien - Kundhistoria 20,000+ duplicerade poster slagna sammanPipedrive SaaS
Hur ett AI-telefonsvar-företag slutade att manuellt kontrollera Pipedrive och slog samman 20 000+ dubblettpostningar med Dedupely
Läs historien - Kundhistoria 200+ kontomatchningar sammanslutna i månaden, i snittSalesforce Detaljhandel
Hur en återförsäljare fick sitt säljteam att sluta gissa vilket konto som skulle användas i Salesforce med Dedupely
Läs historien













