 Dedupely Intelligence


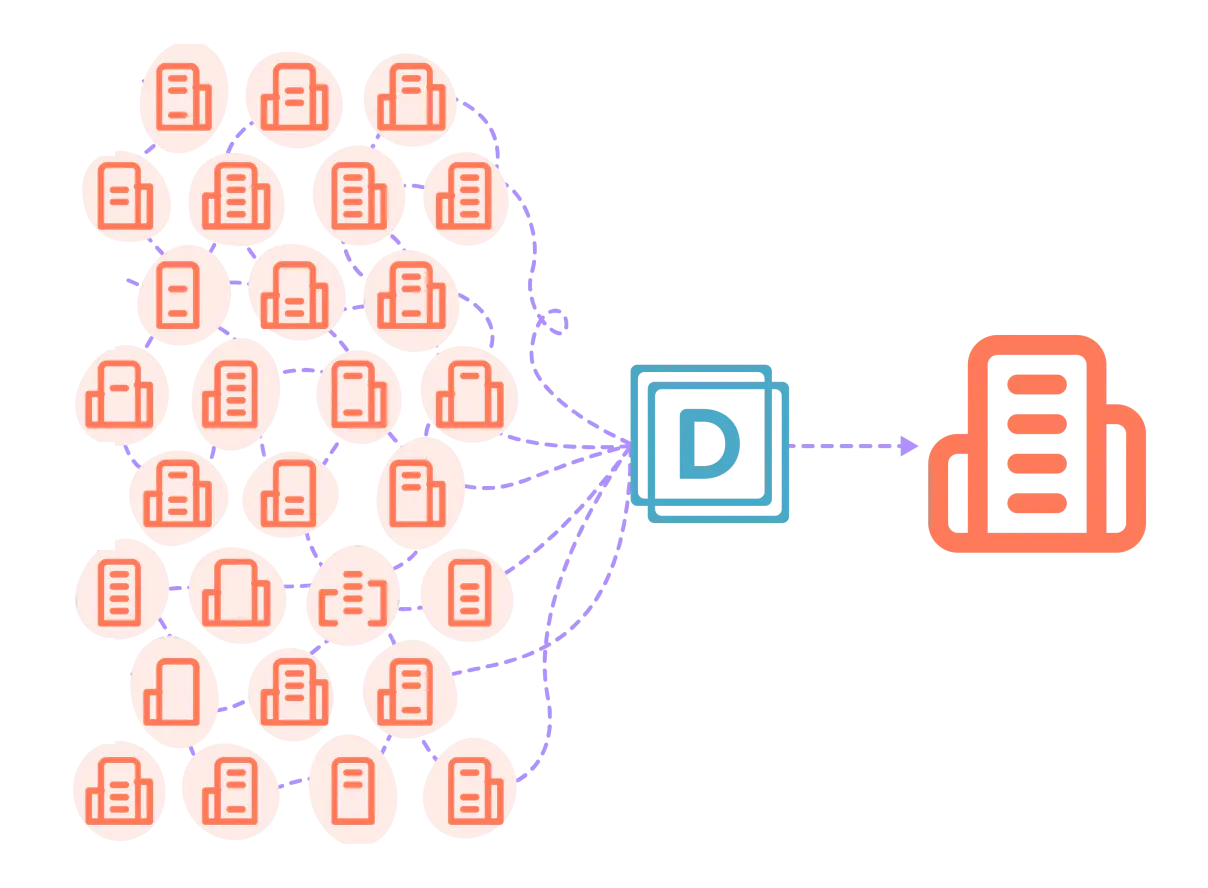


Mesclar registros de empresa no HubSpot traz risco operacional imediato. Como a mesclagem de empresas elimina definitivamente os IDs dos registros secundários, refaz as cronologias de atividade e consolida propriedades, uma mesclagem mal pensada pode substituir campos personalizados sem aviso ou alterar as associações de negócios principais. De fato, 40% das equipes adiam a limpeza do CRM com medo de mesclar os dados errados, perder histórico ou quebrar associações.
Fazer uma mesclagem em massa com segurança exige abandonar a revisão manual par a par e as exportações genéricas de CSV, e passar a usar uma lógica de seleção determinística, regras de retenção de campos e verificação faseada.
Como mesclar empresas do HubSpot em massa
- Escolha o objeto
Abra o HubSpot no Dedupely e selecione Companies.
- Escolha os campos visíveis:
Escolha identificadores da empresa, como domínio, nome ou telefone. Use campos de apoio para distinguir empresas diferentes com nomes semelhantes.
- Edite as opções de correspondência por campo:
Decida se a correspondência deve ser mais rigorosa ou mais tolerante. Clique na seta sob o nome de cada campo para alternar entre Exact, Similar, Fuzzy, Similar Words ou Domain Root.
- Configure Merge Rules
Abra Merge Rules e escolha o registro e os valores que prevalecem. Verifique o proprietário, os dados de contato e os campos usados pelos seus fluxos de trabalho.
- Revise as correspondências
Clique em Scan e abra View Match Details nos grupos que pretende mesclar. Confirme que representam a mesma pessoa ou empresa e verifique os valores que prevalecem. Não selecione correspondências incertas.
- Teste uma pequena mesclagem
Mescle uma pequena amostra revisada. Verifique os registros resultantes, as atividades e as associações no CRM antes de mesclar mais. Pare e ajuste as regras se o resultado for diferente do que você esperava.
- Mescle os grupos revisados
Selecione os grupos de duplicados que você revisou e clique em Merge. Use Select all X matches apenas depois de verificar todo o conjunto de resultados.
Correspondência para além do domínio exato
A detecção nativa de duplicados assenta sobretudo em correspondências exatas de domínio (empresa.com = empresa.com). Na prática, 25% das empresas verificam que as ferramentas nativas deixam passar duplicados por pequenas diferenças de formatação, pontuação ou ortografia, e outras nem sequer têm domínio preenchido. Encontrar esses registros exige ir além dos filtros de correspondência exata.
Correspondência pela raiz do domínio
Remover prefixos (www.), sufixos e variações de domínio de topo (.com, .org, .co.uk) permite que a correspondência por raiz do domínio agrupe filiais regionais e sites alternativos. Assim, as correspondências de domínio que não são exatas ficam à vista para revisão antes de qualquer mesclagem automática.
Correspondência por outros campos identificadores
Quando os registros não têm nenhum valor de domínio, a correspondência pode rodar independentemente com base em outras propriedades-chave. Adicionar campos como nome da empresa (exato ou aproximado), telefone, ID fiscal ou IDs internos personalizados garante que os duplicados órfãos sejam identificados mesmo sem dados de domínio.
Critérios de Seleção do Registro Principal
Automatizar a eliminação de duplicados em massa exige resultados de união previsíveis. Escolher o registro principal ao acaso ou depender só da avaliação manual cria bloqueios graves.
Uma estratégia estruturada de registro principal assenta numa lógica de sistema clara:
- Registro mais antigo: Preserva as origens de conversão originais, a atribuição de marketing do primeiro contato e as datas de criação originais.
- Registro mais recente: Dá prioridade às contas com atividade recente do comercial e comunicação de vendas atualizada.
- Registro atualizado mais recentemente: Vincula o status de registro principal aos registros alterados recentemente por ferramentas integradas ou por limpeza manual.
- Mais dados preenchidos: Escolhe o registro com mais propriedades preenchidas para reduzir ao mínimo a perda de campos.
- Lógica dos campos personalizados: Permite aos administradores escolher qualquer propriedade do registro como critério de seleção do registro principal.
Preservação de Propriedades e Resolução de Conflitos
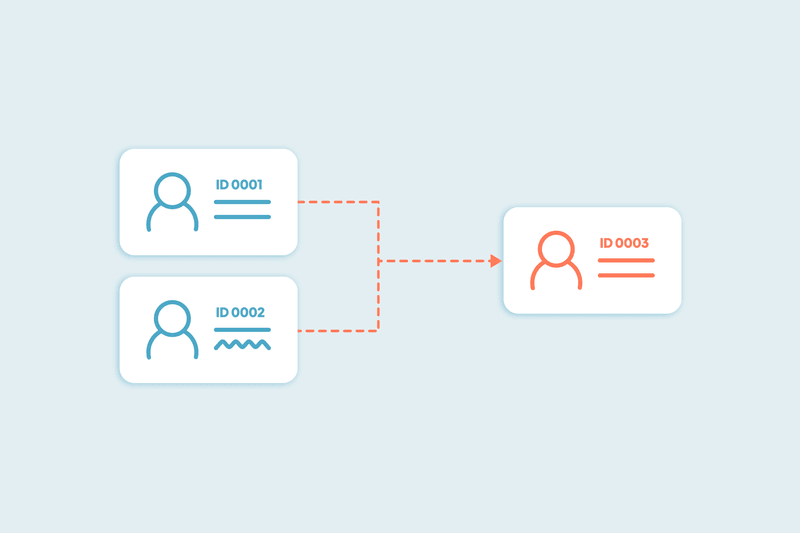
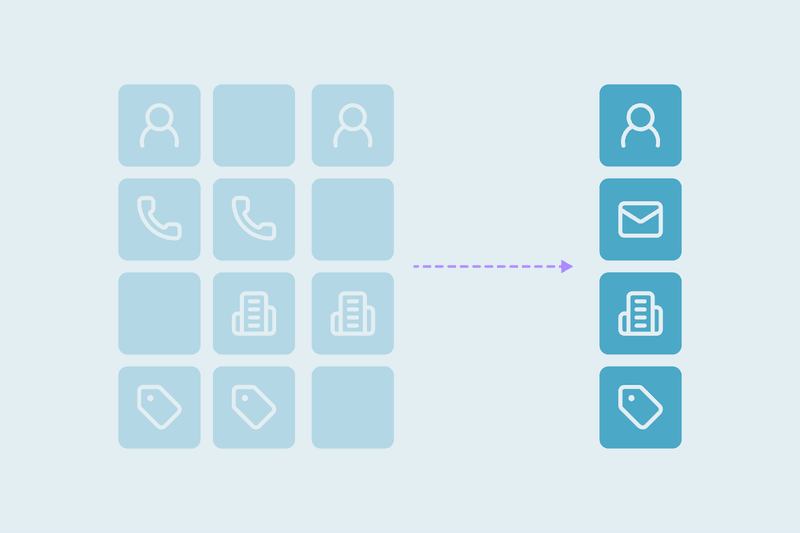
A perda de dados nas mesclagens em massa acontece propriedade a propriedade. Quando dois registros têm valores em conflito, aplicar uma única regra global a todos os campos arrisca substituir contexto importante da conta.
Cada empresa trata os dados à sua maneira, por isso a preservação de propriedades depende do contexto. A forma de resolver conflitos deve depender de como a equipe usa cada campo:
- Campos do pipeline ativo: Propriedades como responsável pela conta, fase do ciclo de vida ou estado do negócio representam a atividade comercial em curso. A resolução de conflitos deve proteger o valor que reflete a operação ativa, independentemente de qual registro é mais antigo.
- Campos descritivos e contextuais: Em campos como descrições de empresa, endereços ou notas internas, a escolha certa depende do próprio valor. As equipes avaliam caso a caso e ficam com o valor que tem melhor formatação ou mais detalhes.
- Campos do sistema de registro: Nas métricas de base, em que a consistência histórica é o que mais conta, manter o valor do registro principal preserva a coerência com os relatórios e os modelos de atribuição existentes.
Pré-visualização Campo a Campo
Exportar um backup em CSV é visto como rede de segurança de uma mesclagem em massa, mas planilhas só guardam valores estáticos. Antes de aplicar mudanças em todo o CRM, os administradores devem conseguir definir opções de correspondência por campo e regras de mesclagem do registro principal, para que determinados valores vençam com base em critérios próprios. Uma análise gera uma prévia, campo a campo, de como os grupos de duplicados vão ser mesclados. Se uma regra der um resultado inesperado, a lógica de correspondência ou as regras de campo podem ser ajustadas antes de atualizar qualquer registro.
Definidas as regras no nível do campo, testar a lógica de mesclagem numa amostra isolada de 50 conjuntos de duplicados dá validação imediata. Revisar esses 50 registros mesclados diretamente na interface do HubSpot confirma que os Contacts, Deals, Tickets, linhas do tempo de comunicação e campos personalizados associados foram preservados como o esperado, antes de processar o restante da base de dados.
Definir regras de junção com resultados previsíveis protege o histórico das contas em limpezas grandes. Ao combinar a correspondência pela raiz do domínio com regras de preservação de campos personalizados, as equipes mantêm o controle total sobre a integridade dos dados.
Perguntas frequentes
Como evitar registros de empresa duplicados quando os contatos usam domínios regionais ou alternativos (por exemplo, .org, .com.mx, .mx)?
O HubSpot cria automaticamente um novo registro de empresa sempre que um domínio recebido não corresponde exatamente a um domínio principal existente. Não é possível bloquear essa criação de forma nativa, mas pode automatizar a resolução: use a correspondência por raiz de domínio para retirar extensões de país e variações de TLD após a criação, aplique as regras de registro principal e deixe o Auto Merge mesclá-los num único registro principal.
Como tratar estruturas empresariais complexas com domínios de marca separados?
Depende inteiramente da sua estrutura comercial:
- Modelo por conta (conta única): Use a correspondência por raiz de domínio para retirar prefixos e sufixos e unir os registros regionais numa conta principal central. Assim, o histórico de negócios, as comunicações e os contatos associados ficam todos num único registro de empresa global.
- Modelo por Entidade (Subsidiárias Separadas): Limite a correspondência de domínios às variantes regionais exatas para que cada unidade de negócio continue distinta, usando associações entre empresa-mãe e filial em vez de as unir.
A partir de que ponto a deduplicação nativa do HubSpot deixa de chegar?
As ferramentas nativas esbarram em limites estruturais em cinco situações:
- Ferramentas web conectadas ou integrações de terceiros criam registros novos para clientes que já existem, em vez de atualizar o perfil ativo, contornando as regras nativas de correspondência exata.
- Quando há 20, 30 ou 40 ou mais registros duplicados de uma mesma empresa, as interfaces nativas obrigam a revisar registro a registro, em vez de resolver o grupo inteiro de uma vez.
- Bases de dados grandes atingem depressa os limites de visualização das ferramentas nativas (entre 2.000 e 10.000 correspondências, consoante o plano).
- As regras nativas não detectam registros com extensões de domínio diferentes ou pequenos erros de digitação e diferenças de formatação.
- Os seus dados dependem de campos personalizados que exigem regras de retenção condicionais para impedir que os campos secundários sobreponham os dados principais.
Juntar empresas duplicadas no HubSpot é exatamente para isso que o Dedupely foi criado: correspondência pela raiz do domínio, regras de registro principal que você define e uma prévia campo a campo antes de qualquer registro mudar.
Comece grátis, conecte seu CRM e veja os duplicados que você tem antes de mesclar qualquer coisa. Comece aqui.


 Ou cadastre-se com o Google

 HubSpot Marketplace