

TL;DR
- AI-chatassistenter kan identifiera uppenbara dubbletter i små exporter, men resultaten kan variera.
- Språkmodeller kan skapa matchningar som inte stämmer eller missa korrekta, så varje resultat måste kontrolleras.
- Att ladda upp CRM-data till ett externt AI-verktyg skickar kunddata till tredje part.
- Automatiseringar och skript byggda på AI ökar kostnaden och underhållet när databasen växer.
- Dedupely Intelligence hittar komplexa dubbletter utan språkmodell och håller CRM-data inom Dedupely.
Att be AI hitta dubbletter låter som den självklara genvägen. Du exporterar dina kontakter, ger dem till en assistent och frågar vilka poster som är samma person. För en kort lista fungerar det ofta.
Problemen börjar med en riktig CRM: tusentals poster, kunddata som inte ska lämna ditt företag och sammanslutningar som inte kan ångras. I det här inlägget jämför jag de tre sätt som team använder AI för deduplering, och vad var och en betyder för sekretess, noggrannhet, kontroll och kostnad.
De fyra metoderna jämförda
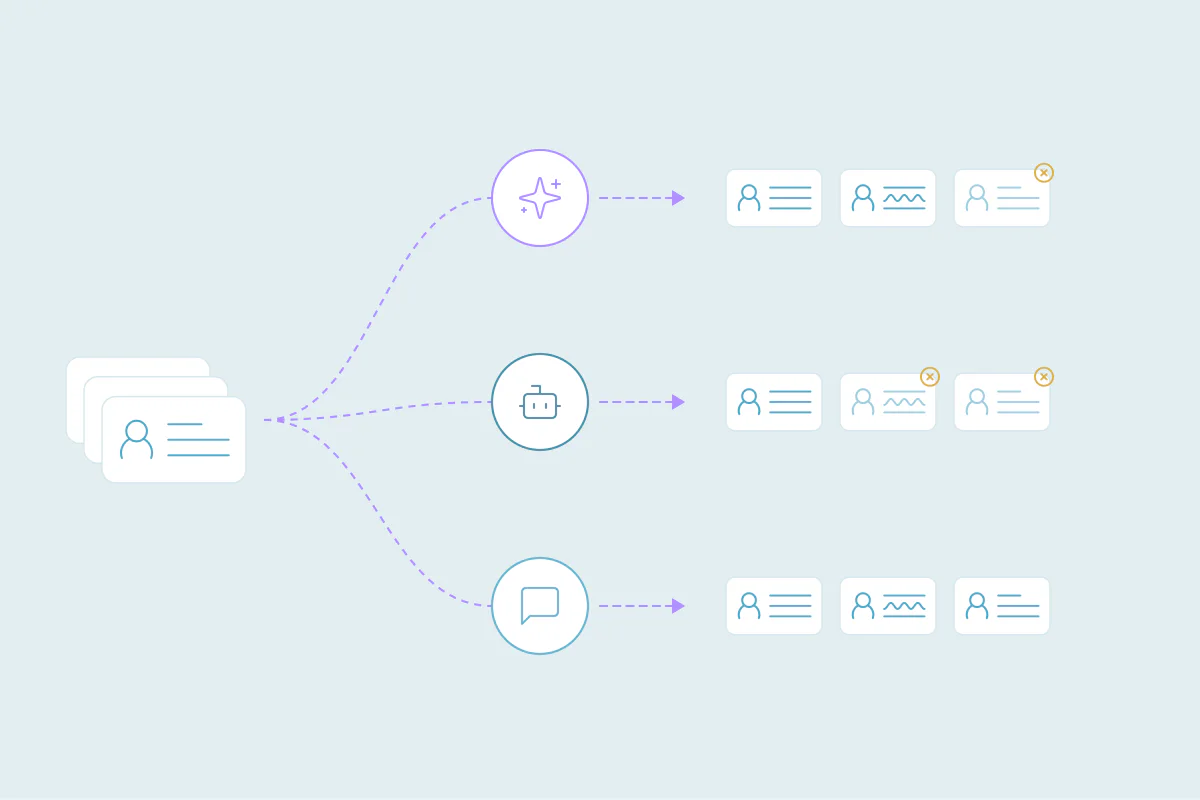
Team som använder AI för deduplicering tar vanligtvis en av tre vägar: en chattassistent, kodlös automatisering med ett AI-steg, eller ett eget skript som anropar en språkmodell. Här är en jämförelse med Dedupely Intelligence.
| AI-chattassistenter | Automationer utan kod med AI | Anpassade skript med en språkmodell | Dedupely Intelligence | |
|---|---|---|---|---|
| Dataintegritet | Exporten överförs till AI-leverantören. Vad som sparas och hur länge beror på prenumerationsplan och inställningar. | Data passerar genom automationsplattformen och en extern AI-leverantör. | CRM-data skickas direkt till en språkmodells-API. | CRM-data stannar på Dedupelys infrastruktur och skickas aldrig till externa AI-modeller. |
| Påhittade eller missade matchningar | Högt risk. Resultaten kan ändras mellan körningar. | Högt riskat. Resultatet behöver justering och kontroller. | Kontrollerat med anpassade skyddsåtgärder och kontroller av resultatet. | Inga. Matchning körs på fast kod, utan språkmodell i appen. |
| Konfiguration | Minuter: exportera, ladda upp, prompt. | 1–4 timmar: arbetsflöden, webhooks och API-anrop. | 1–3 dagar: kod, hosting och API-nycklar. | Ingen konfiguration när CRM är ansluten. Genomsökningar körs automatiskt. |
| Kunskaper som krävs | Ingen från början; kontroll av resultat kräver CRM-kunskap. | Visuella byggare och CRM-logik. | Python, API:er, hosting och felsökning. | Inget. Ingen kod eller matchningsinställningar. |
| Vem hanterar det | Vem som helst, plus någon som kontrollerar resultaten. | RevOps eller CRM-administratör. | En mjukvaruutvecklare. | Vem som helst i teamet. |
| Grupper av duplikat | Begränsad till de rader en konversation kan innehålla. | Poster bearbetas parvis; grupper kräver extra granskningssteg. | Grupper hittas i kod, utan något inbyggt sätt att granska dem. | Alla matchade poster visas tillsammans i en uppsättning. |
| Gränsfall | Varje undantag behöver en ny instruktion. | Varje undantag behöver mer komplex logik. | Anpassad kod, ofta med externa anriknings-API:er. | Komplexa mönster hanteras automatiskt. |
| Sammanfogningskontroll | Inget. Sammanslagning sker för hand i CRM:et. | Enkla standardvärden; kontroll på fältnivå blir rörig. | Vilken logik du än skriver i kod. | Välj primärposten och vilka värden som gäller för varje fält. |
| Omfattade objekt | Vad som helst du exporterar. | Vad ditt arbetsflöde än läser. | Det som CRM:ens API exponerar. | Kontakter, företag och leads för närvarande, med fler på vägen. |
| Priser | Prenumerations- eller användningsavgifter. Granskningtiden är din. | Betala per uppgift; varje operation adderar till kostnaden. | Betala per token, plus utvecklartid. | Matchning ingår i alla planer. Obegränsade sammanslagningar i årliga planer. |
| Växande databaser | Stora exporter måste delas upp, och dubletter mellan delarna missas. | Blir dyrt snabbt: fler poster betyder fler uppgifter. | Högre volym kräver mer beräkningskapacitet och underhåll. | Byggt för skalning. |
Dedupely-prissättning: dedupe.ly/pricing.
Vart dina CRM-data går
Alla AI-vägar utom en skickar kundposter till någon annan. Med en chattassistent laddar du upp exporten. Med en kodlös automation passerar data genom automationsplattformen och sedan AI-leverantören. Med ett skript skickar din kod det direkt till en språkmodells API.
Det spelar roll för att CRM-data är personuppgifter: namn, e-post, telefonnummer, affärsvärden och anteckningar. Många företag har policyer, klientkontrakt eller säkerhetsgranskar som begränsar vilka externa verktyg som kan komma åt dem. Vad leverantören behåller och om det används för att förbättra deras modeller beror på vilken plan och vilka inställningar du väljer.
Innan du laddar upp något, kontrollera din organisations datapolicy och AI-verktygets villkor för data. Är svaret osäkert, säg nej.
Varför modeller skapar och missar matchningar
En språkmodell förutsäger sannolikt text. Den jämför inte poster på det sätt en databas gör. Det mesta av tiden är det nära nog, men deduplicering behöver samma svar varje gång.
Från vad jag har sett återkommer tre problem om och om igen:
- Uppfunna matchningar: två olika personer med liknande namn slås samman till en, eller ett fältvärde dyker upp som inte fanns i data.
- Missade matchningar: poster som delar e-post men skiljer sig i namn eller format glider igenom, ofta mot slutet av en lång lista.
- Olika svar varje gång: kör samma fil två gånger och du kan få två olika uppsättningar dubbletter.
Ingen av dessa är synlig tills någon kontrollerar resultaten rad för rad. Eftersom en sammanslutning kan vara permanent, kan en felaktig matchning radera posten som en rep arbetade på.
Dubbletter förekommer i grupper, och AI-verktyg ser par
Riktiga dubbletter kommer sällan i par. Samma person kan existera fyra gånger: från ett formulär, från en import, från ett försäljningsverktyg och skriven för hand.
Kodlösa automatiseringar kontrollerar vanligtvis poster två och två, så en grupp på fyra blir sex separata jämförelser att granska. Script kan hitta grupper, men du behöver ett sätt att granska dem. En chattassistent ser bara raderna som passar i en konversation, så poster i andra delar av exporten möts aldrig.
Antalet jämförelser växer också snabbt. Att kontrollera varje post mot varje annan betyder ungefär 50 miljoner postpar i en databas med 10 000.
Kantfall kräver mer än bara en bättre prompt
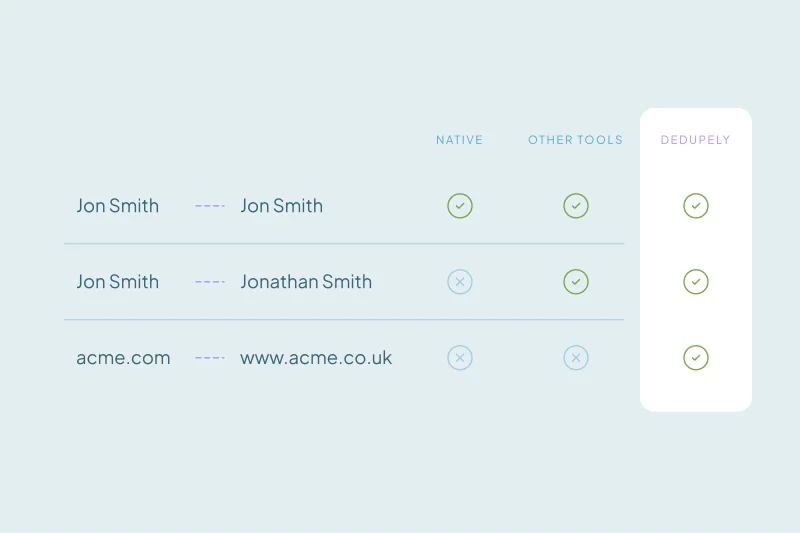
De dubbletter som orsakar mest problem är de svåra: smeknamn, stavfel, företagssuffixer, delade brevlådor, människor som bytte jobb, och poster som delar ett telefonnummer men ingenting annat.
Med promptbaserade verktyg blir varje nytt undantag en ny instruktion. Prompten växer, resultaten blir svårare att förutsäga och någon måste fortsätta testa den. Script hanterar undantag i kod, ofta med externa berikningtjänster, och varje sådan tjänst ökar underhållet.
Vem beslutar vad som överlever sammanslåingen
Att hitta dubbletter är bara halva jobbet. Den andra halvan är att välja vilken post som ska sparas och vilket värde som vinner i varje fält: senaste telefonnumret, ursprunglig ägare, flest använd e-post.
En chatassistent ger dig en lista och sammanslagningen sker manuellt i CRM:et. Automationer utan kod hanterar enkla standarder, men fältspecifika regler blir snabbt komplicerade. Skript ger dig full kontroll, så länge någon skriver och underhåller varje regel.
Installation, kunskap och underhåll
En chatassistent går att prova på några minuter, varför många börjar där. Sedan handlar det om att granska resultaten.
No-code-automationer tar några timmar att bygga och kräver kunskap om arbetsflöden, webhooks och CRM-logik. Script tar dagar, en utvecklare, hosting, API-nycklar och uppdateringar när CRM-fält eller API:er ändras.
Vad som händer med kostnaden när databasen växer
AI-verktyg debiteras per användning, och deduplicering använder mycket. Kodlösa plattformar debiteras per uppgift, så varje post eller par lägger till kostnad. Skript betalar per token för varje post som skickas till modellen, utöver utvecklartid.
Chattassistenter träffar en annan gräns: hur mycket en konversation kan innehålla. Stora exporter måste delas upp och dubbletter som faller i olika delar jämförs aldrig.
Så här väljer du metod
Varje väg passar en annan situation:
- En chattassistent passar en kort lista utan känslig data, där du kontrollerar varje resultat själv.
- En automatisering utan kod passar ett team med en CRM-administratör, låg volym och en godkänd automatiseringsplattform.
- Ett anpassat skript passar ett team med utvecklartid och regler som inget verktyg täcker.
- Ett dedupliceringverktyg med inbyggd matchning passar stora databaser, komplexa dubbletter och data som måste vara privat.
Oavsett vad du väljer, testa på en liten uppsättning först, granska resultaten innan något slås samman och behåll en post över originalvärdena.
Hur Dedupely Intelligence använder AI utan att dela din CRM-data
Dedupely använder AI endast för att utforma matchningslogiken. Dedupely Intelligence kör denna logik som fast kod på Dedulelys infrastruktur, vilket innebär att dina CRM-data aldrig skickas till externa AI-modeller. Det hittar komplexa dubblett-mönster utan konfiguration, visar alla matchade poster tillsammans i en uppsättning och låter dig förgranska varje sammanfogning med dina regler för vilket värde som gäller. För närvarande täcker det kontakter, företag och leads.
AI kan hjälpa, men bara om du vet var det slutar
AI-verktyg är användbara för snabba kontroller på små listor och för team med kunskaper för att bygga och underhålla sina egna arbetsflöden. Deras gränser visar sig med verklig CRM-data: kundposter som lämnar företaget, matchningar som ändras mellan körningar, grupper delade i par och kostnader som växer med varje post.
Det säkraste sättet att använda AI för deduplering är att hålla det bort från beslut det inte kan fatta pålitligt. Matchning av dina kunder och sammanslaging av deras poster behöver samma svar varje gång, med ditt team i kontroll över vad som överlevs.
Vanliga frågor
Kan en AI-chatassistent deduplicera min CRM-data?
Det kan hitta uppenbara dubbletter i små exporter, men är inte tillförlitligt för en fullständig CRM. Resultaten kan ändras mellan körningar, matchningar kan uppstå eller missas, och stora exporter måste delas. Du måste dessutom kontrollera alla resultat och slå ihop manuellt i CRM:en.
Är det säkert att ladda upp CRM-data till ett AI-verktyg?
Det beror på företagets datapolicy och verktygets användarvillkor. Att ladda upp en export skickar kunddata till tredje part. Vad som sparas beror på plan och inställningar. Många företag begränsar vilka externa verktyg som kan ta emot personuppgifter, så kontrollera innan du laddar upp något.
Varför ger AI olika dubblettresultat varje gång?
Språkmodeller förutsäger trolig text i stället för att jämföra poster med fasta regler. Små ändringar, eller ingen alls, kan ge ett annat svar från samma fil. Deduplicering kräver samma resultat varje gång, så modellens utdata måste granskas före varje sammanfogning.
Fungerar AI-baserad deduplicering på stora databaser?
Det blir svårare när databasen växer. Chattassistenter kan bara hantera del av en stor export, no-code-plattformar tar betalt per uppgift, och skript betalar per token för varje skickad post. Antalet jämförelser växer också snabbt: cirka 50 miljoner postpar för en databas med 10 000.
Vad är det bästa sättet att använda AI för CRM-deduplicering?
Använd AI där misstag är billiga, som en snabb kontroll av en kort lista du granskar själv. För en fullständig CRM, använd matchning som ger samma resultat varje gång, håller data privat och låter dig granska grupper av dubletter och välja vilka värden som vinner innan något sammanslås.

 Eller registrera dig med Google