 Dedupely Intelligence




TL;DR
- Wenn ein Bericht denselben Kunden zweimal zeigt, liegt es nahe, das Duplikat nur im Bericht zu entfernen und weiterzumachen.
- Damit korrigieren Sie eine Zahl in einem Bericht, während das CRM und alle anderen Berichte und Tools weiterhin falsch bleiben.
- Dann braucht jeder Bericht seine eigene Korrektur, und die Korrekturen beginnen, sich zu widersprechen.
- Vertriebsmitarbeiter, Automatisierungen und Integrationen arbeiten weiterhin mit den doppelten Datensätzen.
- Dedupely behebt Dubletten direkt im CRM, sodass jeder darauf aufbauende Bericht mit einem Datensatz pro Kunde startet.
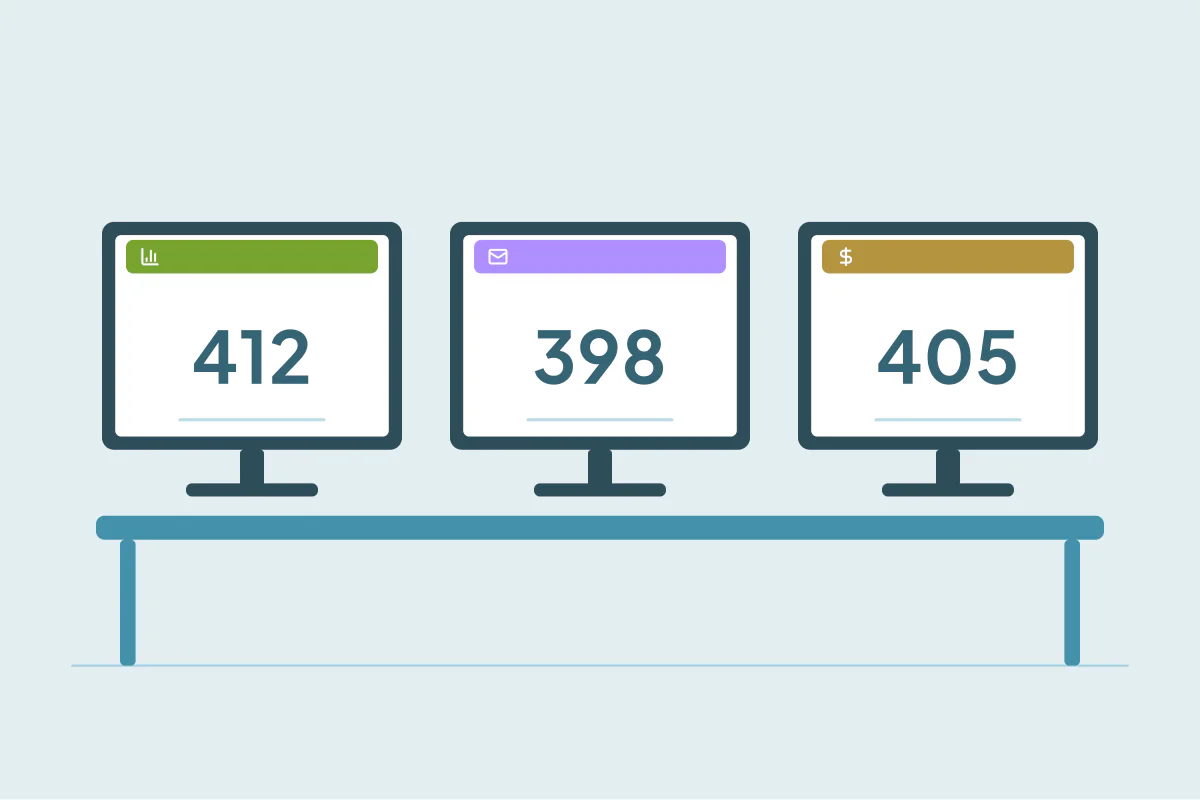
Ein Dashboard zeigt mehr Kunden, als die Finanzabteilung kennt. Jemand findet den Grund: Dasselbe Unternehmen ist dreimal im CRM. Die schnellste Lösung liegt im Report: nach Domain gruppieren, wiederholte Zeilen entfernen oder einen Schritt "distinct" in die Abfrage einbauen. Am Ende des Tages stimmt die Zahl.
Das ist eine vernünftige kurzfristige Lösung. Das Problem: Damit wird der Bericht korrigiert, nicht die Daten. Dieser Beitrag erklärt, warum Korrekturen auf Berichtsebene nicht halten und wann sie trotzdem nützlich sind.
Was eine Korrektur auf Berichtsebene bewirkt
Eine Korrektur auf Berichtsebene blendet Dubletten nur in einer Ansicht aus. Die darunterliegenden Datensätze ändert sie nicht. Übliche Varianten:
- Ein Schritt "distinct" oder "Duplikate entfernen" in einer Tabelle oder Abfrage.
- Gruppierung nach E-Mail oder Domain sodass mehrere Datensätze als eine Zeile erscheinen.
- Eine manuelle Ausschlussliste von Datensätzen, die bereits als Dubletten bekannt sind.
- Eine Nachschlagetabelle das mehrere Datensatz-IDs einem "echten" Kunden zuordnet.
Alle diese Lösungen funktionieren für den Bericht, für den sie gebaut wurden. Keine davon erreicht das CRM.
Warum das CRM dadurch nicht korrigiert wird
| Was die Korrektur im Bericht bewirkt | Was defekt bleibt |
|---|---|
| Zeigt eine Zeile pro Kunde | Im CRM existieren noch zwei oder drei Datensätze |
| Summiert den Umsatz korrekt | Deals und Aktivitäten sind noch auf Datensätze verteilt |
| Entfernt doppelte Einträge aus einer Liste | E-Mails, Sequenzen und Anrufe nutzen weiterhin beide Datensätze |
| Alles in einem Dashboard | Jeder andere Bericht braucht dieselbe Korrektur, neu aufgebaut |
Vertriebsmitarbeiter sehen die Dubletten weiterhin. Sie öffnen den falschen Datensatz, verpassen den Verlauf und erzeugen beim Suchen weitere Duplikate.
Automatisierungen laufen weiterhin auf beiden Datensätzen. Workflows, Lead-Scoring und Routing behandeln jeden Datensatz als eine andere Person oder Firma.
Andere Tools synchronisieren trotzdem beide. Ihr Marketing-Tool, Ihr Support-Desk und jeder Datenexport erhalten die Dubletten unverändert.
Berichtskorrekturen laufen auseinander
Das größere Problem zeigt sich ein paar Monate später. Der Vertrieb hat ein Dashboard, das nach Domain gruppiert. Marketing nutzt eine Tabelle, die nach E-Mail gruppiert. Die Finanzabteilung hat eigene Ausschlusslisten. Jede Lösung ist anders aufgebaut, daher nennt jeder Report für dieselbe Sache eine etwas andere Zahl.
Jetzt dreht sich das Gespräch darum, welcher Bericht stimmt, nicht um das Geschäft.
Wann eine Korrektur auf Berichtsebene genügt
Berichtskorrekturen sind nicht falsch. Sie sind als Übergangslösung nützlich:
- Für einen heute fälligen Bericht, während die CRM-Bereinigung geplant wird.
- Für historische Daten die Sie nicht ändern können oder nicht ändern möchten.
- Zur Kontrolle: der Vergleich zwischen gruppierter und roher Anzahl zeigt, wie groß das Dubletten-Problem ist.
Betrachten Sie sie als Messgröße, nicht als Lösung.
Beheben Sie das dort, wo die Daten liegen.
Die dauerhafte Lösung liegt im CRM:
- Duplikate finden für die Objekte, auf die Ihre Reports angewiesen sind, meist Unternehmen, Kontakte und Deals.
- Führen Sie sie zusammen, mit Regeln, welche Werte gelten, damit Historie und Deals auf einem Datensatz landen.
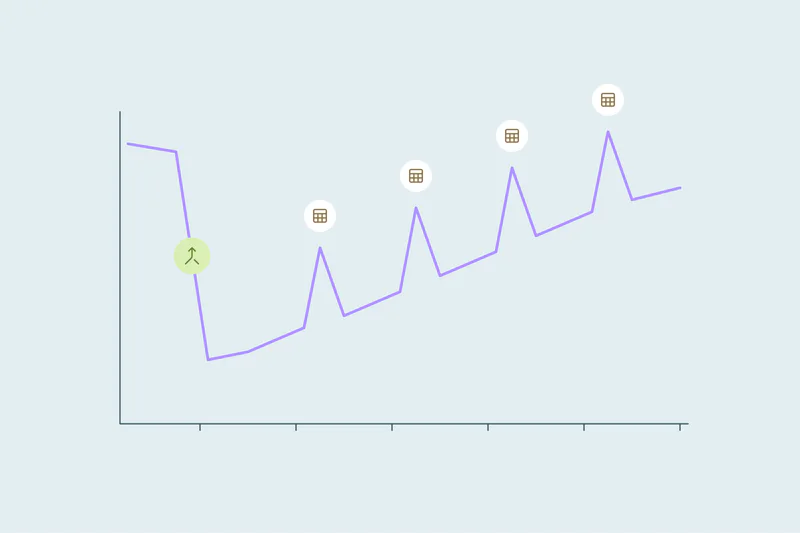
- Neue Duplikate erkennen nach Zeitplan, damit die Berichte ohne zusätzliche Schritte korrekt bleiben.
- Workarounds in Berichten entfernen sobald die Daten bereinigt sind, damit jeder Bericht gleich zählt.
So behebt Dedupely Dubletten an der Quelle
Dedupely findet und führt Dubletten direkt im CRM zusammen, in HubSpot, Salesforce, Pipedrive, Close, Nimble und Google Contacts. Beim Zusammenführen werden Aktivitäten und Verknüpfungen, etwa verknüpfte Unternehmen, Deals und Kontakte, in den zusammengeführten Datensatz übernommen, sodass Berichte jeden Kunden nur einmal zählen. Mit Merge Rules legen Sie fest, welche Werte in jedem Feld gelten, und Auto Merge führt neue Dubletten nach Zeitplan zusammen, damit die Berichte nicht erneut auseinanderlaufen.
Eine Korrektur, alle Berichte
Dubletten in einem Bericht zu entfernen korrigiert eine einzige Zahl. Sie im CRM zusammenzuführen korrigiert jeden Bericht, jede Ansicht der Vertriebsmitarbeiter und jedes Tool, das damit synchronisiert. Nutzen Sie Korrekturen im Bericht als Übergangslösung und zur Messung, und beheben Sie dann die Daten dort, wo sie liegen.
Häufige Fragen
Kann ich Dubletten einfach in meinen Berichten statt im CRM entfernen?
Für einen Bericht, als Übergangslösung. CRM, Ihr Vertrieb und Ihre anderen Tools arbeiten weiter mit den Dubletten, und jeder weitere Bericht braucht eine eigene Korrektur.
Warum zeigen Ihre Berichte für dasselbe unterschiedliche Zahlen?
Oft, weil jeder Bericht Duplikate anders behandelt: einer gruppiert nach E-Mail, ein anderer nach Name oder Domain.
Ist eine Korrektur im Bericht manchmal die richtige Wahl?
Ja, für einen heute fälligen Bericht oder historische Daten, die Sie nicht ändern möchten. Nutzen Sie es, während Sie die CRM-Bereinigung planen.
Wie erkenne ich, wie viele Dubletten meine Berichte verbergen?
Vergleichen Sie die Zeilenanzahl vor und nach der Gruppierung nach E-Mail oder Domain. Die Differenz ist eine grobe Schätzung.
Was sollten Sie nach einer Bereinigung mit Workarounds in Berichten tun?
Entfernen Sie sie, damit jeder Bericht Datensätze gleich zählt.


 Oder mit Google registrieren
 HubSpot-Nutzer